工程师 Khairallah AL-Awady 近期在 X 上发布长文,把 GPT、Claude 这类大语言模型的诞生过程拆成了五个阶段:从一堆原始网络文本,一步步变成能对话、能干活的 AI 助手。这篇文章介绍这五个阶段各自在做什么、门槛有多高,并补充一条普通开发者能实际上手的路径,适合想搞懂大模型原理、或打算微调自己模型的读者。
五个阶段各自做什么
- 数据准备:从网页、书籍、代码库收集海量文本,做清洗、去重、过滤低质内容,再切分成模型能处理的 token。数据质量直接决定模型上限,大厂在这一步投入的工程量远超外界想象。
- 预训练:让模型在这些文本上反复做”预测下一个词”的练习。这一步产出的是基座模型,它掌握了语言规律和世界知识,但还不会好好听指令。
- 监督微调(SFT):用人工编写的高质量问答对继续训练,教模型按指令回答问题,从”续写机器”变成”对话助手”。
- 人类反馈强化学习(RLHF):让人对模型的多个回答排序打分,训练出奖励模型,再用强化学习让模型输出更符合人类偏好,减少胡编和有害内容。
- 评估与部署:跑基准测试、做安全评估,再通过量化、蒸馏等手段压缩模型,让推理成本降到可以对外服务的水平。
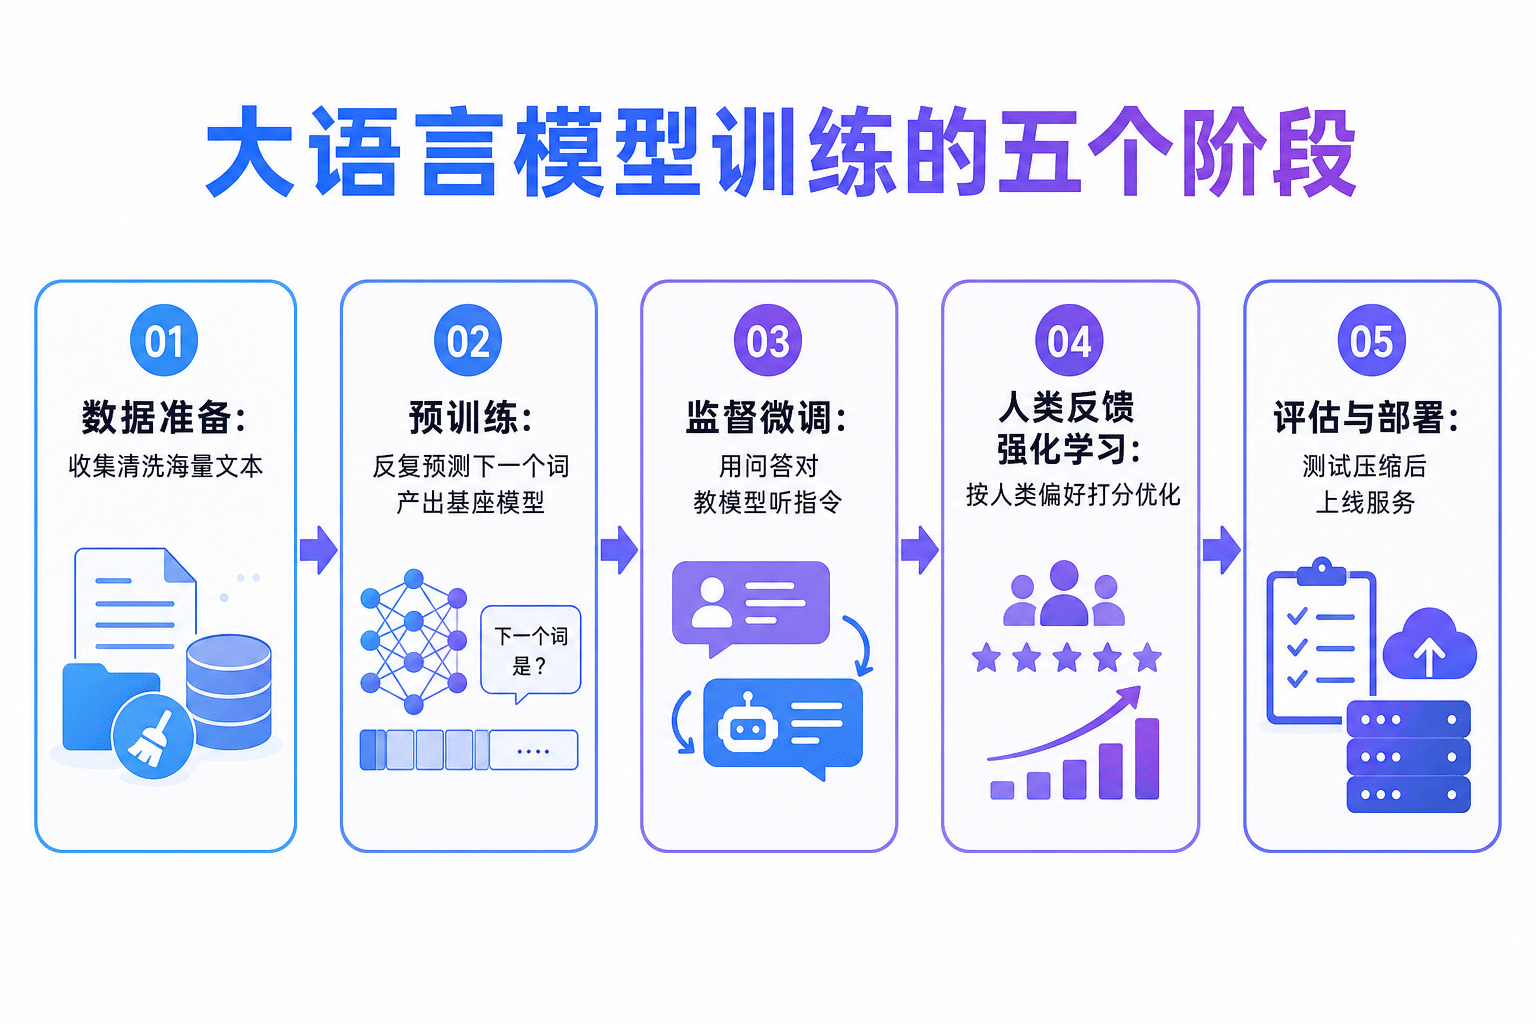
图:从原始文本到上线服务的五个训练阶段(本站整理)
每个阶段的门槛差多远
这五个阶段的成本极不均匀。预训练是绝对的烧钱大头,主流规模的基座模型一次训练要用上千张高端 GPU 跑数周,费用是百万美元级起步,个人和小团队不用考虑。数据准备同样是大厂的护城河,拼的是工程能力和数据渠道。而 SFT 和轻量化的偏好对齐,在开源工具成熟之后门槛已经降到消费级:一张 24GB 显存的显卡,配合 LoRA 这类参数高效微调方法,就能在开源模型上跑出效果。
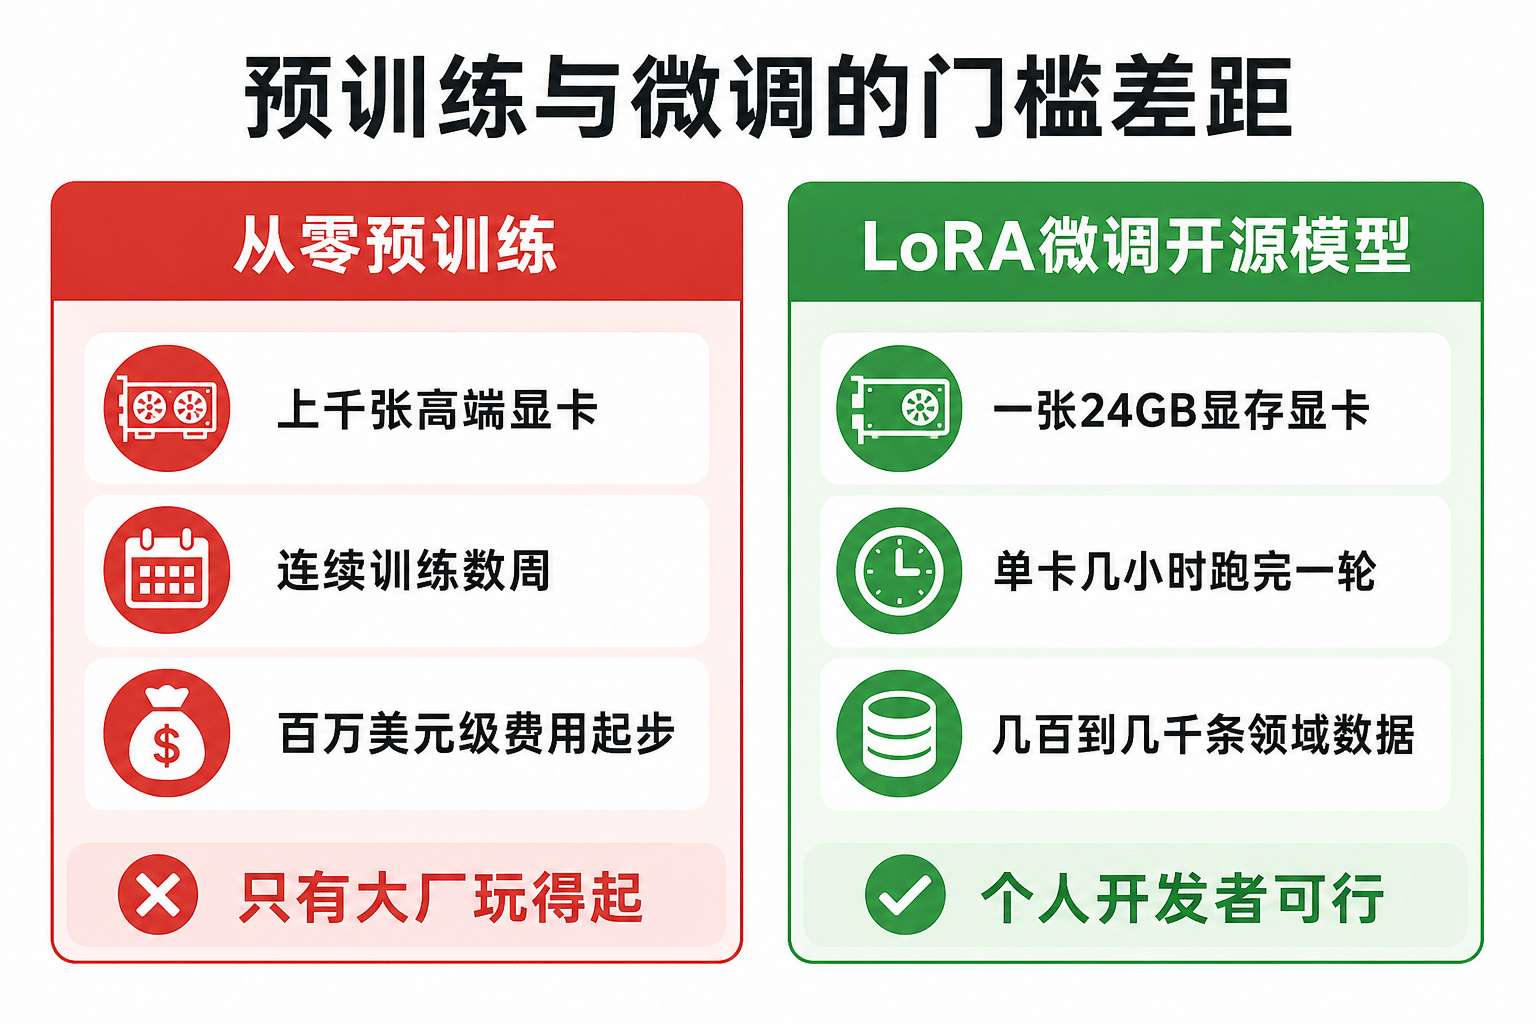
图:从零预训练和 LoRA 微调开源模型,完全是两个量级的门槛(本站整理)
普通开发者的可行路径
对绝大多数人,从零预训练没有意义,合理的做法是站在开源模型肩膀上:
- 选一个开源权重的基座,国内常用的有 Qwen 和 DeepSeek 系列,英文场景可以用 Llama。
- 准备几百到几千条自己领域的问答数据,格式对齐指令微调的模板。
- 用 Hugging Face 的 transformers 加 PEFT 库做 LoRA 微调,单卡几小时就能跑完一轮。
- 微调后一定要留一部分数据做测试,对比基座模型确认没有把通用能力练丢。
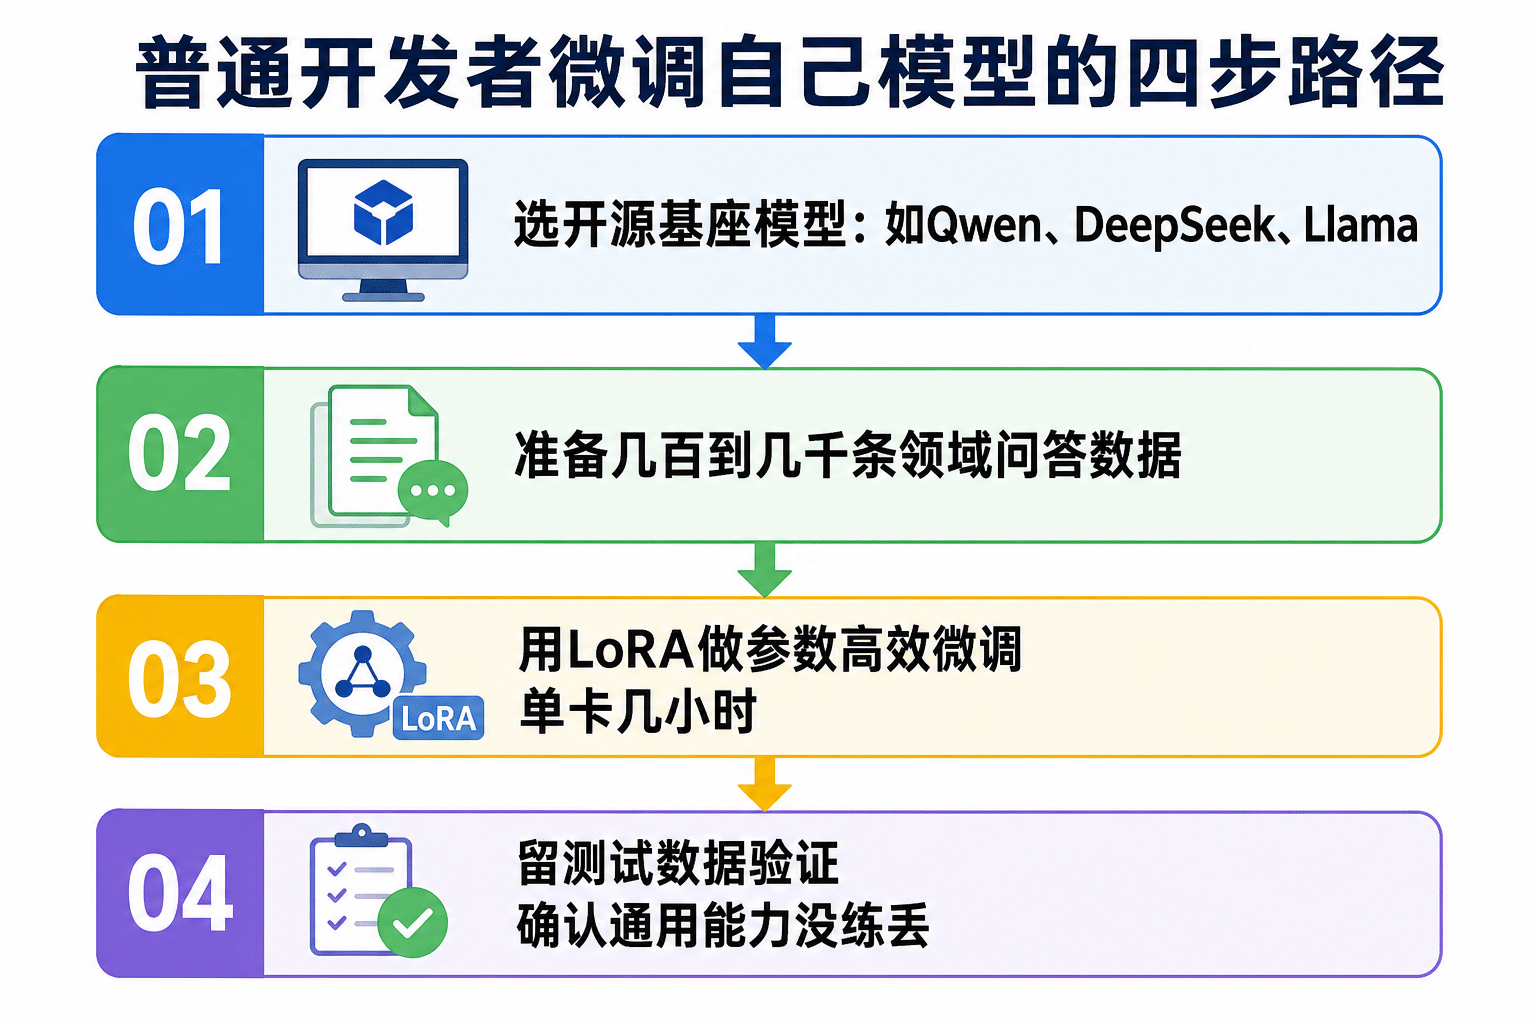
图:站在开源模型肩膀上的四步微调路径(本站整理)
就算不动手训练,把这五个阶段搞清楚也有价值:你会明白模型为什么会一本正经地编造事实、为什么同一个问题换种问法效果差很多,写提示词和选模型时判断会准确不少。
原文:How To Build Your Own LLM from Scratch(Khairallah AL-Awady)
© 版权声明
文章版权归作者所有,未经允许请勿转载。