Double-Color-Ball-AI 是一个结合历史数据处理、统计图表和大语言模型输出对比的开源项目。根据提供的来源材料,它以公开数据为示例,串联 Python 数据清洗与 Vue.js 前端展示,适合作为理解数据看板开发流程的学习案例。
这个开源数据看板可以用来学什么
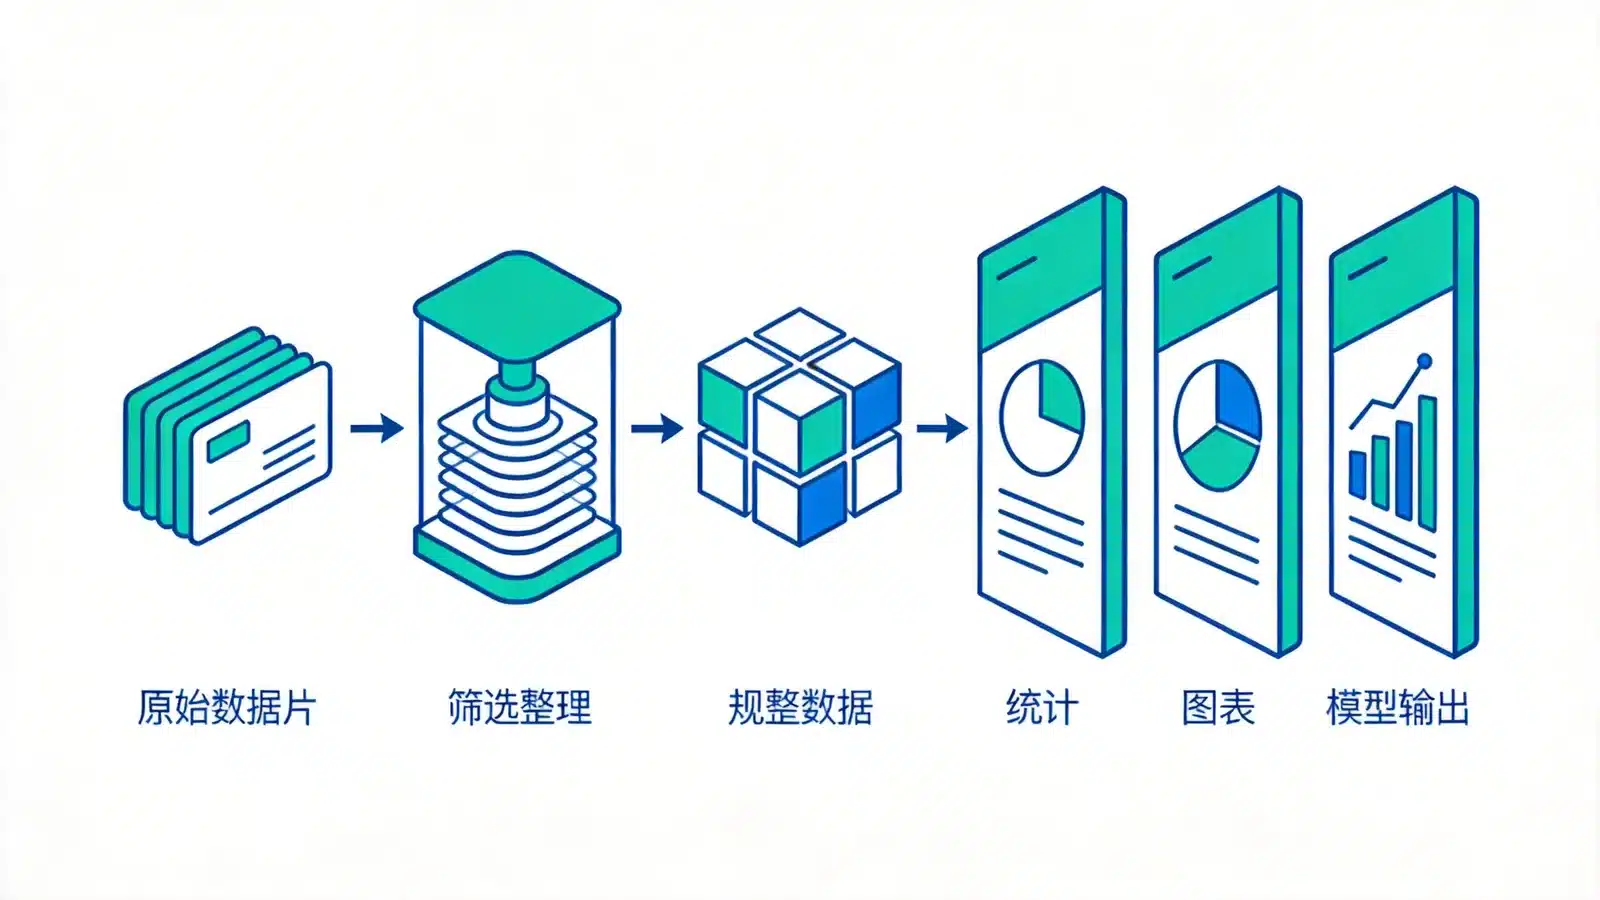
项目围绕一条完整的数据处理流程展开:后端抓取原始数据并完成清洗,中间环节计算统计指标,前端再将结果呈现为可交互的图表。阅读时可以沿着数据流向,观察每个环节接收什么内容、产生什么结果,以及结果如何传递给下一步。
来源将其介绍为统计学与前端工程的实战模板,学习重点包括数据格式整理、指标计算和页面展示。对已经接触过 Python 或 Vue.js 的读者,这类案例有助于把分散的知识点连接起来,理解一个数据页面背后的处理过程。
本文依据所提供的 ahhhhfs 来源材料整理,材料标注日期为 2026 年 2 月 14 日。本次未抓取原页面核实;采集备注中的浏览量为 4200,所附正文显示为 4.3K,因此不将浏览量作为项目质量或使用规模的依据。
历史数据清洗与趋势图表如何衔接
来源描述的数据处理方式,是由后端脚本将网页中的原始内容整理为标准 JSON,再交给前端使用。学习时可以重点检查字段含义、数据类型和记录顺序,理解原始内容如何转化为图表能够读取的数据,而不只是关注最终页面的外观。
在可视化部分,来源提到 ECharts 或 Recharts,并列举了区间分布、和值走势等展示内容。折线图用于观察数值随记录顺序的变化,柱状图用于比较不同区间的统计结果;阅读源码时,应把图表配置与对应的数据字段一起查看。
材料没有明确说明两个图表库是否同时使用,也没有提供组件结构和依赖清单。实际复现时,需要以项目源码确认图表实现,不能仅凭文章中的名称就认定所有图表能力均已具备。
多模型输出对比能够观察哪些差异
按照来源介绍,看板支持配置 GPT-4o、Claude 3.5、DeepSeek 等模型接口,让不同模型围绕同一组统计指标生成分析文本。这里可以关注的是模型如何组织结构化数据、遵循输出要求,以及它们对相同输入是否给出一致的描述。
对比时可分别检查 JSON 格式是否符合要求、分析文字能否对应输入指标、结论之间是否存在矛盾。为了让观察结果更容易解释,建议保持输入数据和提示词模板一致,再逐项比较输出,避免把输入条件变化造成的差异归因于模型能力。
模型生成的解释文字不等于其内部推理过程,也不能单凭表述流畅就判断结论正确。来源没有提供统一评分规则、测试样本数量或准确率结果,因此这部分更适合作为输出观察案例,不能据此给模型做性能排名。
统计指标的学习价值与解释边界
来源列出的指标包括频次统计、低频项在较长周期中的变化,以及奇偶和大小分布等。学习这些算法时,可以先理解统计窗口如何选择,再核对计数、分组和汇总结果,逐步建立从数据记录到指标数值的对应关系。
频次统计反映的是选定范围内的出现情况,分布指标则帮助概括已有样本的特征。改变统计窗口后,结果可能随之变化,因此阅读图表时需要同时关注数据范围,避免脱离计算条件解释某一条曲线或某一个比例。
来源使用了“均值回归演示”和“回补趋势”等说法,但未提供相应的验证过程。低频记录不能单独证明后续一定补回,历史趋势也不能说明未来必然延续。该项目的图表与算法输出仅用于学习程序逻辑,不具备经过证实的预测能力。
从查看演示到本地运行的使用路径
来源列出了在线演示和 GitHub 源码入口,并称源码包含数据清洗脚本、前端工程及 Docker 部署配置。可先通过演示了解页面内容,再阅读仓库说明,确认目录结构、运行步骤和所需配置,最后尝试在本地复现数据到图表的过程。
按材料说明,前端依赖 Node.js,数据处理依赖 Python。本地预览应通过项目提供的启动方式或本地 HTTP 服务进行;直接打开页面文件可能影响资源加载,但使用本地服务也不意味着所有跨域问题都会自动解决,仍需结合实际请求检查配置。
开启模型对比功能需要配置相应接口密钥,较长的历史数据上下文会增加 Token 消耗。材料没有给出具体费用、开源许可证或商业授权范围,也未核实当前接口可用性;运行前应查阅项目说明和接口服务规则,不能将开源等同于接口免费或商业使用不受限制。
官网 / 下载
延伸阅读
© 版权声明
文章版权归作者所有,未经允许请勿转载。