机器学习系统设计是算法岗和后端岗面试的高频考点,也是不少工程师日常调用模型、却讲不出完整链路的一块内容。The System Design Newsletter 最近一期由 ML 工程师 Paolo Perrone 撰写的入门指南,把这套系统拆成数据和模型两条主线,不写代码、不推公式,只解释每个术语在工程里究竟对应什么。本文按这个思路重新梳理其中的十个核心概念,并补上国内团队落地时需要额外考虑的部分。
机器学习系统与传统软件的差别
传统软件的行为由人写死的规则决定:温度高于 32 摄氏度就开空调,用户点了”购买”就扣款,每一条判断都以代码的形式存在。
机器学习系统的做法不同。工程师不再直接编写规则,而是把大量历史样本交给系统,由系统自己归纳出规律。给它一百万条历史订单记录,它学会预测这一单大概要开多久;给它几十亿条播放记录,它学会判断下一首该推什么。
这个过程听上去抽象,实际做的就是数据工程:数据进来,模式被提取出来,预测流出去,系统再拿预测结果的反馈继续调整自己。下面的十个概念,每一个都对应这条管线上的某个环节。
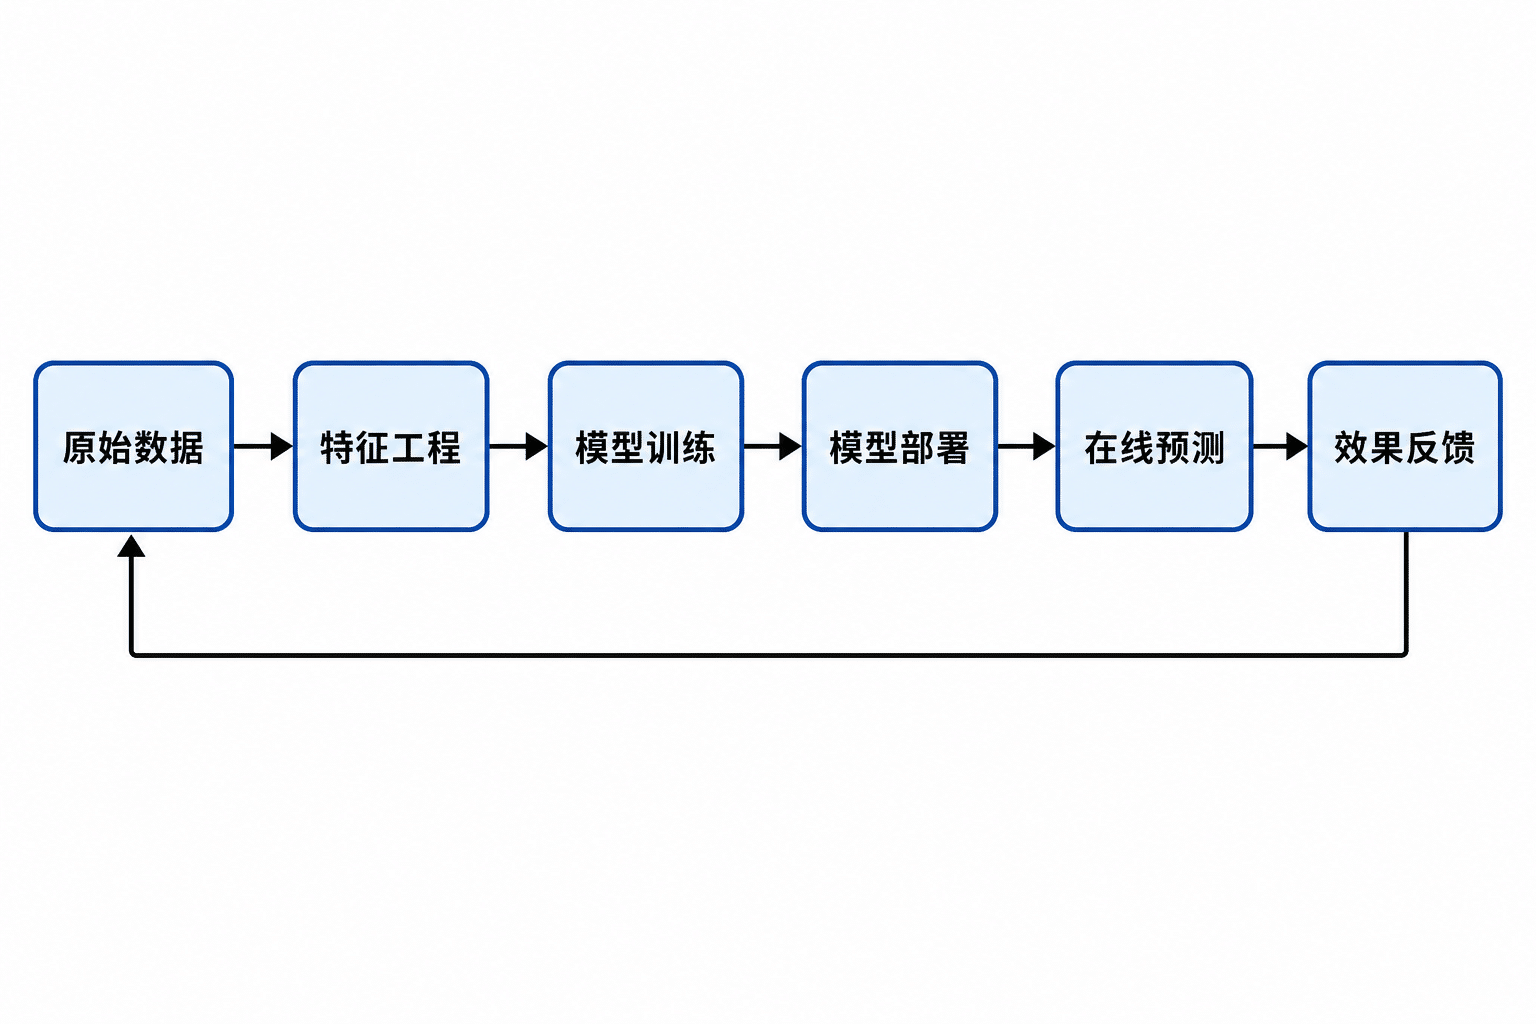
图1:机器学习系统的完整管线,从原始数据一路到线上预测,再由效果反馈回流到数据端。
数据环节:模型效果的上限所在
原文对这一段的判断很直接:模型再先进,喂进去的数据是垃圾,出来的预测也是垃圾。数据侧有七个概念。
特征
特征(feature)指模型用来做判断的单个可量化信息,可以理解成数据表里的一列。预测用户会不会点某条广告,特征可能包括年龄、访问时间、设备类型、本次会话中已经看过几条广告,每一项从不同角度描述同一个样本。
Spotify 的每周新发现(Discover Weekly)用到的特征包括常听曲风、习惯收听的时段、跳过歌曲的频率。模型并不”听”音乐,它读的是这些特征。网易云音乐的私人漫游、QQ 音乐的推荐位,底层逻辑是同一套。
特征质量对最终结果的影响,通常大于模型本身是否先进。
特征工程
原始数据往往杂乱且没有结构,特征工程(feature engineering)负责把它清洗、重组,把有用的信号提取出来。原文用备菜作比:整鸡不会直接下锅,得先切块、腌制、摆好。
Uber 的原始记录可能只有一行”2024-12-25 08:47:32 UTC 发起叫车”。特征工程把它拆成星期几(周三)、时段(早高峰)、是否节假日(是)、天气(雨)。每一项都比原始时间戳更有指向性。
威力最大的特征常常不在原始数据里。”该用户平均每周叫几次车”需要跨多条记录聚合才能算出来,这类构造能力是特征工程拉开差距的地方。
一个需要澄清的适用边界:不少人认为特征工程在大模型时代已经过时。在图像、语音、自然语言这几类非结构化数据上,端到端的深度模型确实基本取代了人工特征。但推荐、风控、广告投放、需求预测这些跑在结构化表数据上的业务,人工特征工程至今仍是主力,梯度提升树(XGBoost、LightGBM 一类)配合精心设计的特征,在这类任务上依然稳定跑赢直接套用大模型的方案。判断依据是数据形态,不是年份。
标签与真值
标签(label)是训练时希望模型预测出来的那个答案,真值(ground truth)则是现实中实际发生的结果。垃圾邮件过滤器的标签是”垃圾”或”非垃圾”,房价预测的标签是实际成交价。模型靠比对自己的猜测与已知答案来学习。
真值听着简单,取得却很难。Netflix 要判断”用户喜不喜欢这部电影”,真值本身就是模糊的:看完了算喜欢吗?打了分算吗?接着看了同类型的算吗?定义不同,模型学出来的行为完全不同。
标签定义决定了模型实际优化的目标。定义选错,模型会认真地朝错误的方向优化下去。
训练集、验证集与测试集
不能拿学生练过的原题去考他,机器学习同理。数据切成三份,各有分工:
- 训练集:模型实际学习的部分,训练过程中它只见这些样本。
- 验证集:训练中途的检查点,用来判断哪个版本的模型表现更好。
- 测试集:最终考试,这里表现好才算具备上线条件。
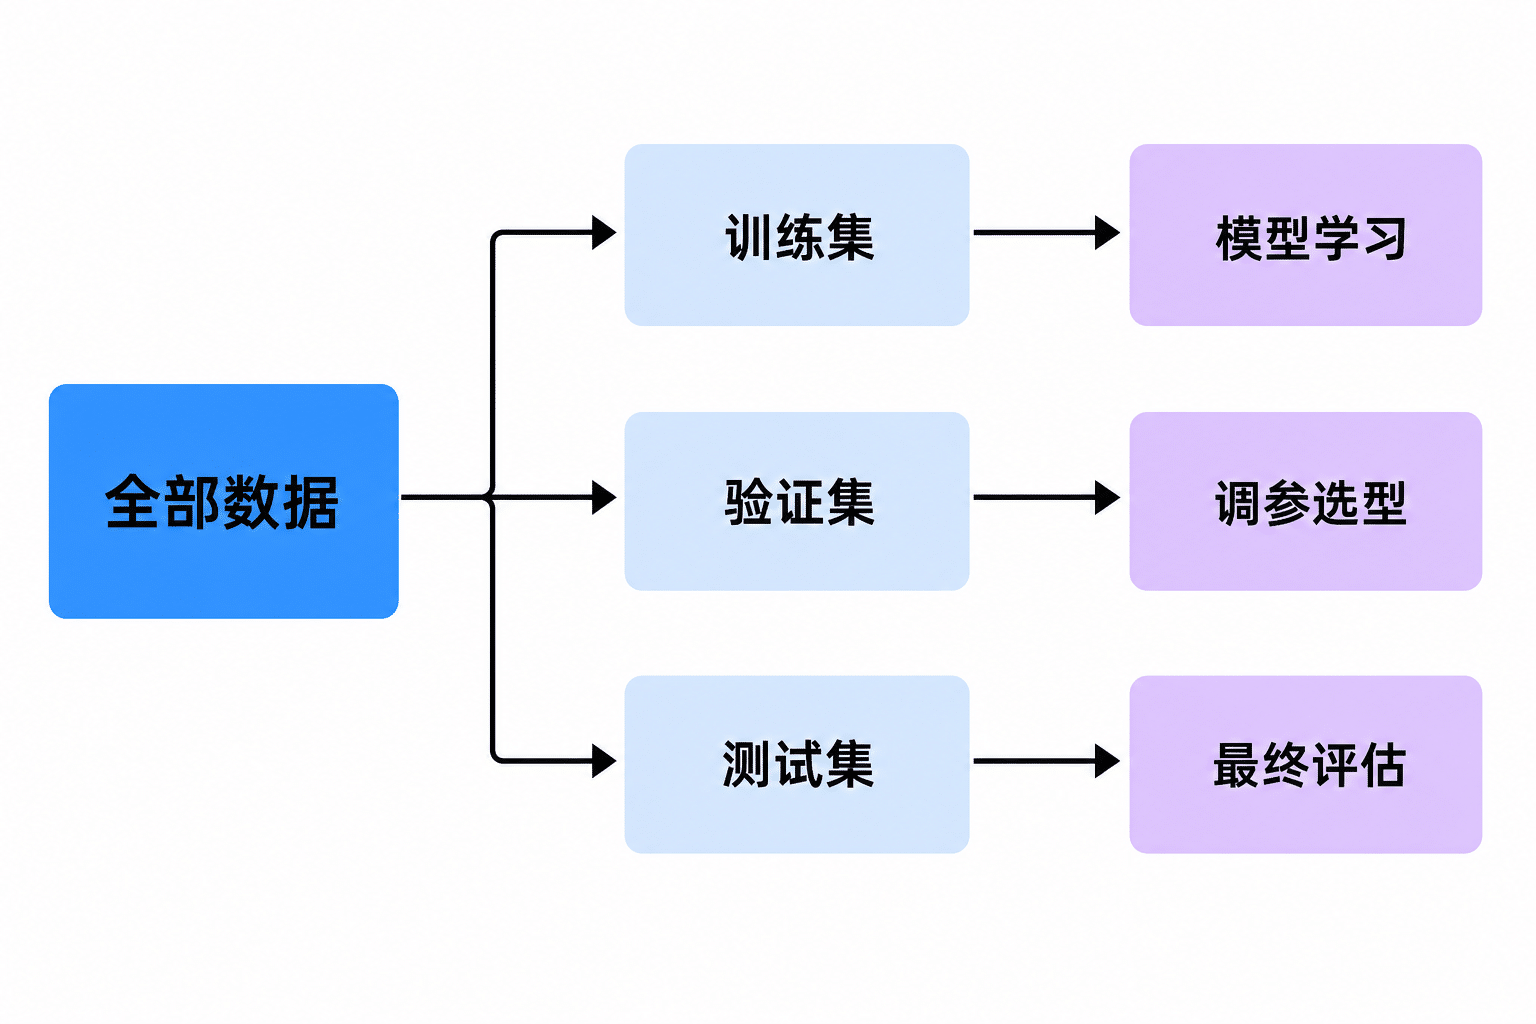
图2:数据集三分割及各自承担的任务。
常见的切分比例是 70/15/15 或者 80/10/10,具体取决于数据量有多少。有一条规矩不能破:测试集绝不能参与模型开发过程,否则等于让学生提前看了考卷。
Netflix 这类业务通常按时间切分:一月到十月的观看数据用于训练,十一月做验证,十二月做测试。按时间切分对机器学习系统尤其重要,因为真实世界的数据分布本身会随时间变化。
类别不平衡与数据泄露
反欺诈场景里可能一万笔交易才有一笔是欺诈,医疗诊断里绝大多数患者没有那种罕见病。这就是类别不平衡(class imbalance):某一类结果远比其他类常见。这种分布下模型只要一律预测”不是欺诈”,准确率就能到 99.99%,同时毫无用处。
常规处理办法包括对稀有类过采样、对常见类欠采样,或者调整损失函数,让模型在稀有样本上犯错的代价更高。
原文没展开的一点是指标该怎么换。准确率(accuracy)在极端不平衡的分布下失去意义,实际要看的是精确率(precision)、召回率(recall),以及在这种分布下仍能反映真实水平的 PR 曲线下面积(PR-AUC)。面试中被问到不平衡数据,答完采样策略再补一句评估指标的选择,完整度会明显不同。
数据泄露(data leakage)则是答案混进了训练数据。做迟到率预测模型,数据集里带了”是否有客户投诉”这一列,而投诉本身正是因为已经迟到才产生的。模型的评估分数会高得反常,把这一列删掉就什么都预测不了。
原文给了一条经验规则:第一次训练准确率就超过 95%,先查泄露;超过 99%,连类别不平衡一起查。
还有一类容易被漏掉的泄露形态是时间穿越:特征里用到了在预测时间点上根本还不存在的信息,比如预测七月订单量时用了七月底才结算出来的数据。随机打乱切分数据集会把这类问题掩盖过去,按时间切分则会直接把它暴露出来,这也是上一节强调时序切分的另一层理由。
数据管道与 ETL
数据管道是把数据从原始来源(数据库、事件日志、第三方 API)经过一系列转换、送成模型可用格式的自动化流程。ETL 是其中的三个动作:抽取(Extract)从源头取出原始数据,转换(Transform)负责清洗、关联、聚合和特征加工,加载(Load)把结果写入特征存储或训练数据集。
这是机器学习里的管道工程,和真实的水管一样,不出事没人想起它。出问题的往往不是模型也不是算法,而是漏掉的一行记录、一个空值、一次延迟执行的管道任务。系统不报错,预测结果只是悄悄变差。Uber 每天运行数千条数据管道,每一条都配了监控、告警和质量检查。
原文把”加载到特征存储(feature store)”一笔带过,这里值得补全:特征存储的核心价值不在存储本身,而在于让训练和线上推理共用同一套特征计算逻辑。训练时用离线批处理算特征、线上用另一套代码实时算,两边口径一旦出现偏差,模型的离线评估会很漂亮、上线效果却崩掉,排查起来极难定位。业界给这个问题起了专门的名字,叫训练与服务偏差(training-serving skew),特征存储这类基础设施存在的主要理由就在这里。想了解模型上线后的服务侧要处理哪些问题,可以参考自建 AI 聊天助手实战里关于架构设计的部分。
数据版本管理
模型效果突然下滑的时候,第一个要回答的问题是”变的是模型还是数据”。没有数据版本管理,这个问题无从查起;有版本管理,可以直接对比当前训练数据和历史版本,定位到具体改动。
数据版本管理(data versioning)就是记录清楚每个模型是用哪个版本的数据集训练出来的。软件工程师用 Git 追踪代码变更,机器学习团队同样需要追踪数据变更。
它还带来可复现性,这在金融、医疗这类受监管行业属于硬性要求。审计问起”六个月前这个模型为什么做出这个判断”,团队需要有能力还原出当时的模型和训练数据。
工具选择上有国内外之分。常用的是 DVC(Data Version Control)和 MLflow,两者都开源免费,官网 dvc.org 和 mlflow.org 在国内可以直接打开,pip 安装时建议切到国内镜像源以免超时。如果团队已经在用国内云,阿里云 PAI、百度智能云 BML、火山引擎机器学习平台都内置了实验记录与数据版本管理模块,省掉自建 MLflow 服务的运维成本,代价是与该云平台绑定较深。中小团队从 MLflow 起步更灵活,已有云上数据中台的团队直接用平台自带模块更省事。
模型环节:模式的提取方式
模型本身不”懂”任何东西。它在数据里找模式,再用模式做预测。
模型训练与损失函数
训练就是不断给模型看样本,让它调整内部数值,直到预测结果越来越接近真值,类似学生反复做模拟题。
推动这个过程的是损失函数(loss function),它衡量预测结果偏离真值的程度。每处理完一批样本,模型算出损失值,再调整内部数值把这个数压下去。几百万个样本累积下来,微小的调整汇成明显的效果。
不同问题需要不同的损失函数。预测数值(比如 Uber 的到达时间)常用均方误差,它对大偏差的惩罚远重于小偏差;做分类(比如判断是不是垃圾邮件)通常用交叉熵损失,衡量的是模型在错误答案上有多自信。
损失函数的选择决定了模型往哪个方向优化。用均方误差训练出来的模型追求平均意义上的准确,用平均绝对误差训练出来的模型对异常值更稳健。这个位置上的小决定,会一路影响到线上表现。
参数与超参数
参数(parameter)是模型自己学出来的东西,可以理解成模型的记忆:每个学到的模式都编码成一组数字。工程师不写这些数字,模型在训练中自行得出。
原文提到 GPT-4 有数千亿参数,这一点需要说明:OpenAI 从未公开过 GPT-4 的参数规模,外界流传的数字都属于推测,写进面试答案之前应当标明来源。有确切公开参数量的是开源模型,Llama、Qwen、DeepSeek 系列都在模型卡里直接标了参数规模,举例时用它们更稳妥。
超参数(hyperparameter)则是控制训练过程的设置,训练开始前由人设定:模型每次调整的幅度(学习率)、一次处理多少样本(批大小)、完整过一遍数据的次数(轮数),以及模型结构本身。沿用学生的类比,参数是脑子里的知识,超参数是学习计划,包括每天学几小时、先学哪一科、做几套模拟题。
超参数没设好,再合适的模型也跑不出结果。学习率过高,模型始终收敛不了;过低,训练时间会长到不可接受。轮数太少会欠拟合,太多会过拟合。实际做法是跑多组不同超参数的训练实验,在验证集上比较结果。
嵌入
嵌入(embedding)指把一个对象,一个词、一个用户或者一件商品,表示成一串能反映其含义的数字。”猫”和”小猫”不再是两个完全无关的标签,它们在向量空间里的位置相互靠近,因为二者语义相关。
可以用地图来理解:普通地图上地理位置接近的城市画在一起,嵌入空间里语义接近的概念挨在一起。”喜剧”和”爱情喜剧”是邻居,”恐怖片”离得远一些但仍在电影类型这一片区域内,”财务报表”则落在完全不同的位置。
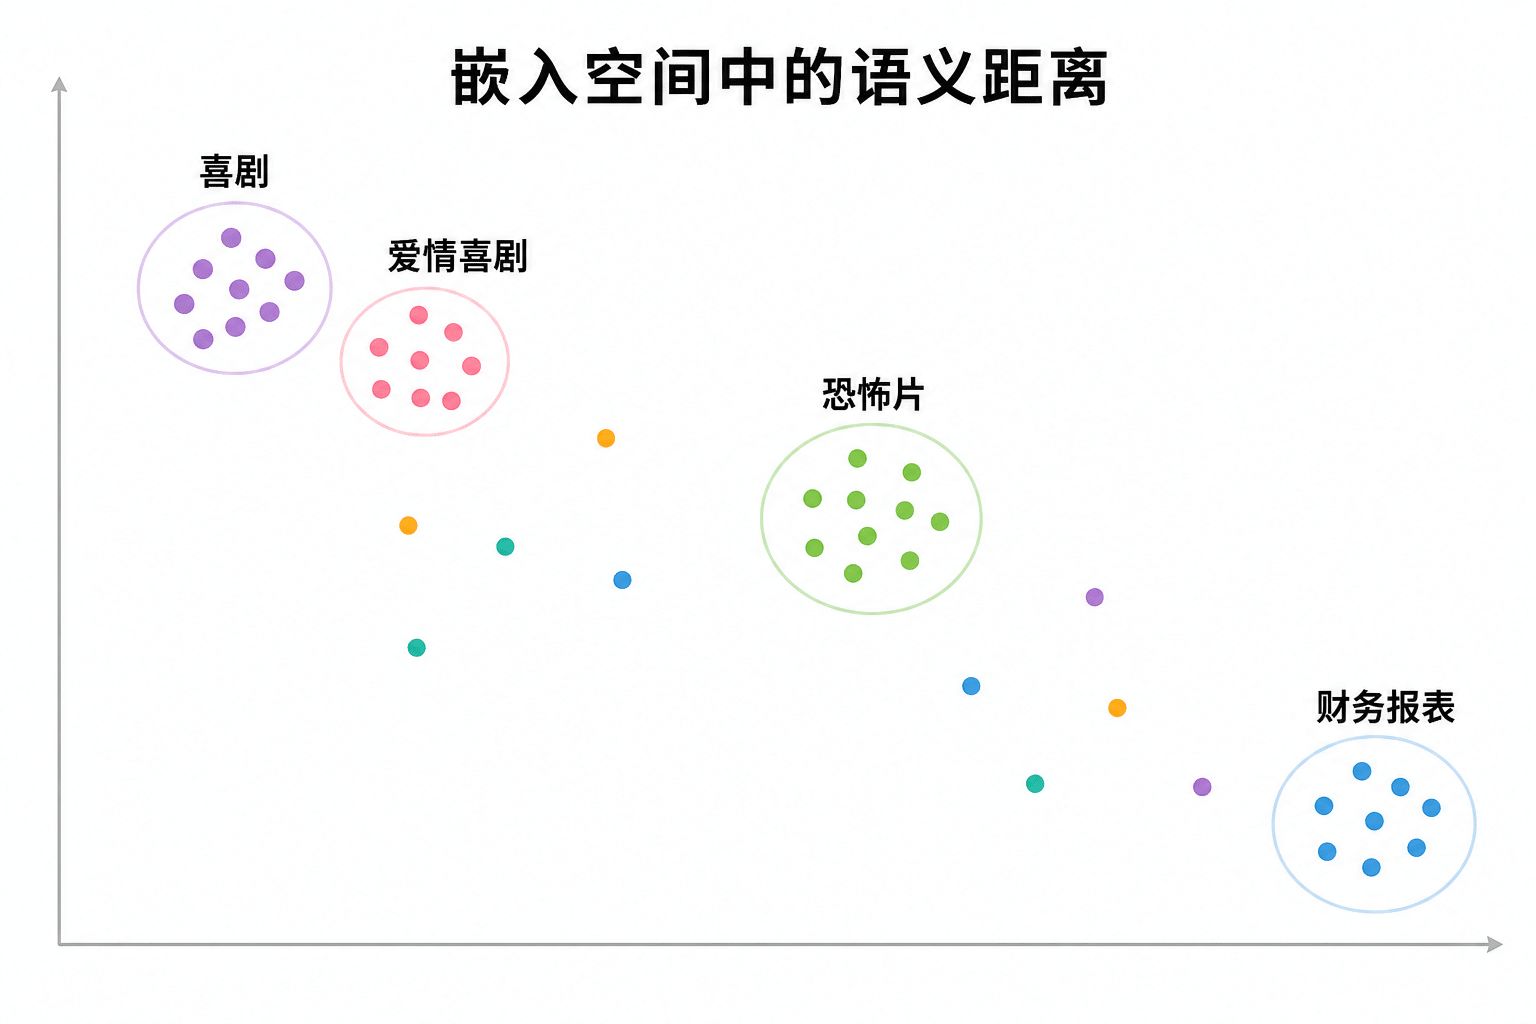
图3:嵌入空间里,语义接近的概念位置相邻,无关的概念相距很远。
嵌入在真实系统里随处可见。Spotify 用歌曲嵌入找出和用户近期收听风格接近的曲目,Netflix 用电影嵌入和用户嵌入做匹配。国内业务同理,抖音的内容推荐、淘宝的商品召回、支付宝的风控画像,底层都要先把对象转成向量,才能计算谁和谁相似、该推荐哪一个。
近两年 RAG(检索增强生成)的流行让嵌入进一步走出了推荐系统,成为大模型应用的标配组件:文档切块之后转成向量存进向量数据库,检索阶段比对的就是嵌入之间的距离。面试里聊到这一块,把推荐系统和 RAG 串起来讲,比只背定义扎实得多。
这份清单的使用建议
原文是付费订阅内容,公开部分讲到嵌入为止,后面的过拟合与正则化、模型评估指标、特征存储、模型漂移等概念需要订阅才能读到。就这十个公开概念而言,覆盖的恰好是机器学习系统里最容易被跳过、面试中却最常被追问的部分。
三条取舍上的判断供参考。数据侧的七个概念优先级高于模型侧,面试里回答”怎么设计一个推荐系统”,从数据来源、标签定义、切分方式讲起,比一上来讨论模型结构更贴近实际工程流程。数据泄露和类别不平衡最值得反复确认,它们在真实项目中的出现频率远高于在教程里的篇幅占比。想动手验证这些概念,用一份公开数据集从特征构造一直走到模型评估跑通一遍,比单纯读概念更能记住每个环节的位置。
做 AI 应用而非训练模型的开发者,这十个概念中每天用得上的是特征、嵌入和数据管道三项,其余部分了解到能听懂算法同事在说什么即可。相关的工程实践可以参考AI 编程工作流实战。
原文出处:The System Design Newsletter – How ML Systems Actually Work
© 版权声明
文章版权归作者所有,未经允许请勿转载。