不少人对 AI 编程的想象是「把问题贴进去,拿到能跑的答案」,真放到生产项目里很快就会碰壁:模型会调用不存在的函数、引入项目里没有的库,还会无视那些在开发者看来显而易见的约束。订阅量超过 20 万的技术通讯 System Design One 最近刊出一篇实战文章,客座作者 Louis-François Bouchard 在反复踩坑之后给出了一套完整的解法,核心思路是把 AI 编程从一次性请求改造成人主导的六步循环:上下文、规划、编码、审查、测试、迭代。本文把这套流程完整拆开讲清楚,末尾补充国内工具环境下的落地方式。
能力边界与预期校准
这套方法建立在对 AI 编码助手的清醒认识上。需求清晰、问题就摆在眼前时,它表现出色:起草函数、重构代码、搭测试脚手架、解释报错信息都做得又快又好。但它有一条硬边界:只知道当前上下文里出现过的东西。它不记得上一次会话,不了解项目架构和团队约定,猜测的时候不会提醒,只会带着十足的把握继续输出。
作者见过 AI 调用根本不存在的库函数、使用错误版本的语法、忽略他以为不言自明的约束。错误的样态各异,根因高度一致:没被告知的信息,模型会用「听起来合理」的内容补上。这类凭空编造在业内叫幻觉(hallucination)。
原文给了一个好记的比喻:AI 是五分钟前刚加入项目的聪明同事。写代码的速度确实快,但架构、约定、限制条件一概不知,除非有人亲口交代。理解了这一点,那些看似离谱的错误就变得可以预测——模型不是能力差,而是在填补开发者没意识到自己留下的信息空洞。由此引出贯穿全文的三条原则:上下文给得比自己以为的更多;指令拆成具体步骤,「加上这几个字段的输入校验、返回明确的错误信息、写一个证明非法输入会被拒绝的测试」远好于「帮我做个网页应用」;重要的输出必须验证,安全逻辑、数据库迁移、必须正确的算法,一律人工审查并用测试锁定行为。
工具层面,原文把常用产品分成四类:AI 编辑器(Cursor、VS Code 加 Copilot 这类内置 AI 的代码编辑器,能引用项目文件做补全、重构和生成);对话模型(ChatGPT、Claude、Gemini,适合思路尚未成形时梳理方案、解释报错、比较取舍);AI 代码审查工具(CodeRabbit 一类,自动审查代码合并请求);搜索助手(Perplexity 一类,用来核实某个 API 是否真实存在、某个特性在当前版本里是否可用)。编辑器长于仓库内的操作,对话模型长于自然语言推理,审查和测试工具负责兜住人疲劳时漏掉的问题——六个步骤里各有分工。
六步循环总览
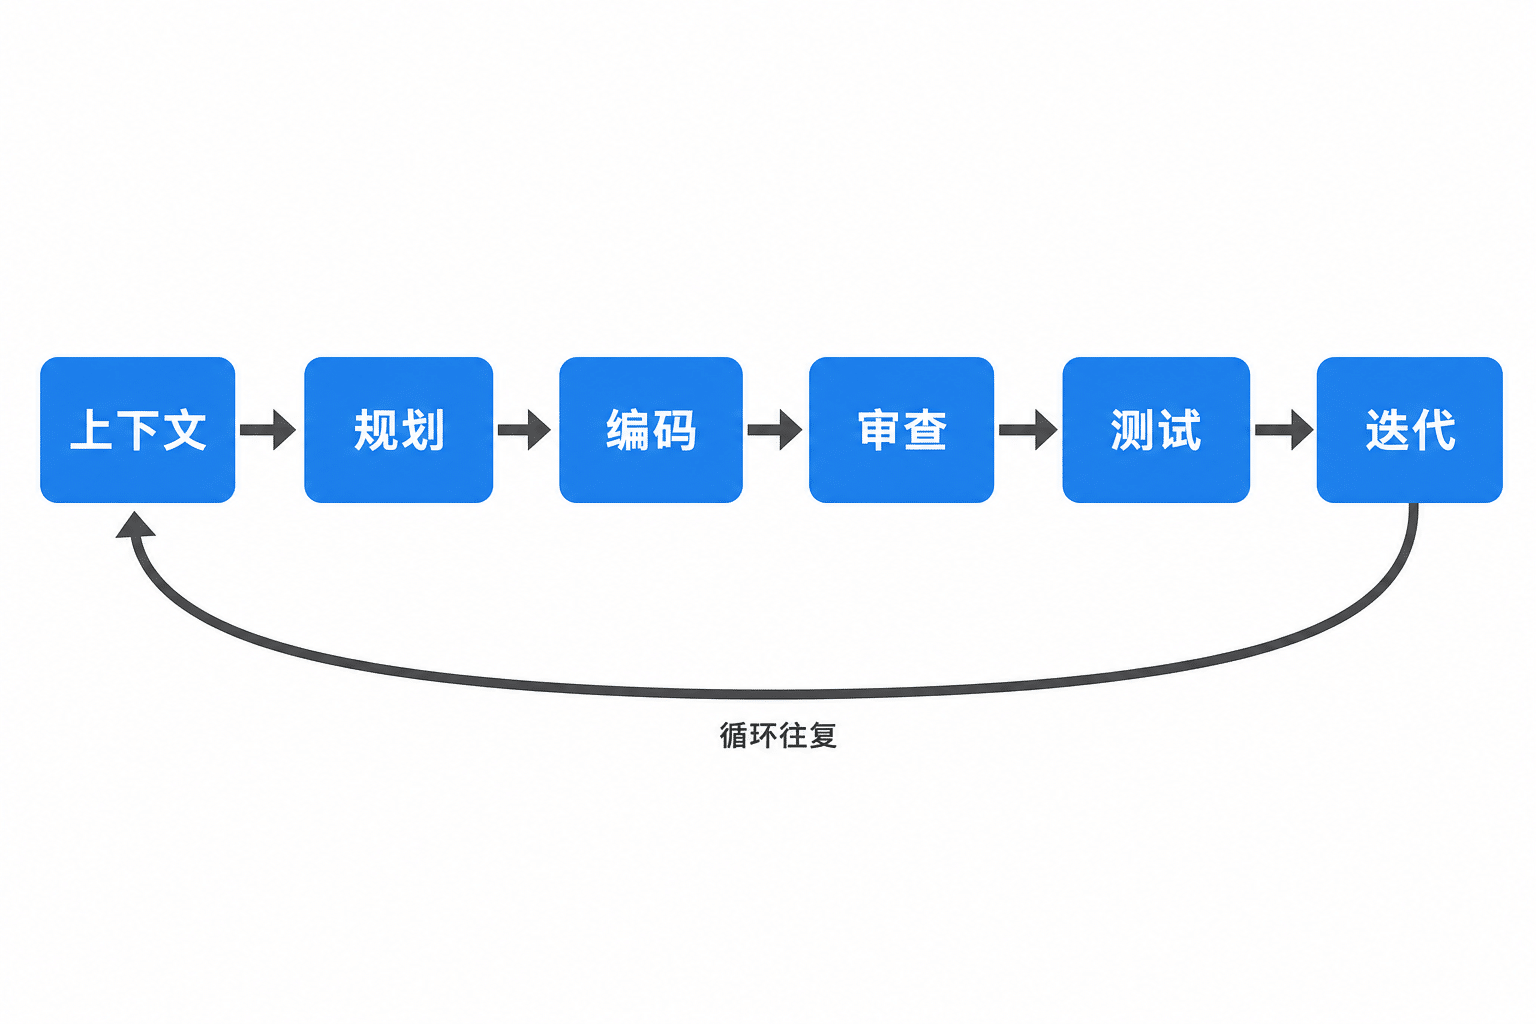
图:六步循环——上下文、规划、编码、审查、测试、迭代,循环往复
无论修 bug、加功能还是清理混乱的模块,作者跑的都是同一个循环:先共享项目背景、约束和相关代码,让 AI 不必猜测(上下文);在写任何代码之前先要一份策略(规划);一次只生成或修改一小步,保持改动可审(编码);仔细检查输出,常配合 AI 辅助的代码审查当第二双眼睛(审查);跑测试,并让 AI 生成新测试锁定预期行为(测试);调试失败、修正请求、重复执行,直到改动稳固(迭代)。
整个循环里最要紧的是第一步。模型若在猜测你的环境,后面每一步都会变成收拾残局。
第一步:上下文先行
AI 写出错误代码,多数场景是同一个根因:模型在信息真空里硬猜。有人贴上一个函数、敲下「fix this」,然后惊讶于建议无视了系统的另一半。只给一句「修好它」,是让模型产生幻觉最快的方式——没有项目背景和约束,它只能用不存在的函数、错误版本的语法、破坏仓库惯例的方案来填空。
对任何不算小的改动,作者的做法是把默认顺序倒过来:文档和规则在前,代码在后。用能自动引入文件的 AI 编辑器做这件事最省力,他用的是 Cursor,可以圈选代码、拉入项目里的其他文件,还能中途换模型——快模型做小修改,重推理模型啃难缠的 bug。偏好 VS Code 生态的话,Copilot 或 Claude Code 提供类似能力。任务稍复杂时,他会装载三类上下文。
项目背景。每个项目维护一份持续更新的 README,多数 AI 会话以它开场:
Read the README below to understand the project. Then I will give you a specific task.改动涉及敏感模块(比如支付)时,关键文件也一并放进第一条消息。等到描述具体需求时,助手已经熟悉了周边地形。
规则与约束。维护一份规则文件(常见命名是 AGENTS.md 或 CLAUDE.md),汇总项目范围、代码风格、版本约束(例如「本服务跑在 Django 4.0 上」)和少数硬规则(「开发环境绝不调用这个外部 API」「所有时间一律用 UTC」)。不少工具支持 rules 或自定义指令功能,可以免去每次会话重复粘贴。
相关代码与信号。修 bug 或加功能时,把涉及的函数或文件连同堆栈信息(stack trace,报错时的函数调用路径)、日志一起给出。只有一行报错,等于只给了整张截图里的一个像素,模型没法做真正的推理,只能乐观地猜。
三类上下文合起来,就是这个可以反复套用的提示词骨架:
Read @README to understand the project scope, architecture, and constraints.

Read @AGENTS.md to learn the coding style, rules, and constraints for this codebase.

Then read @main.py, @business_logic_1.py, and @business_logic_2.py carefully.

Your task is to update @business_logic_2.py to implement the following changes:

1. <change 1>
2. <change 2>
3. <change 3>

Follow the conventions in the README and AGENTS file.

Do not modify other files unless strictly necessary and explain any extra changes you make.
结构从不变化:先上下文,再规则,最后是精确的任务描述,换掉的只有文件名和改动清单。作者也强调上下文要经过筛选,不能一股脑倾倒——最好的简报短小果断,足以杜绝猜测,又不至于淹没信号。判断标准很直接:粘贴的内容超过一个人开工前愿意读完的量,就该删。
规则文件还有一个原文没有展开的隐患:它会过时。依赖升级、约定调整之后,AGENTS.md 往往没人同步,AI 按旧规则输出反而制造新错误。比较稳妥的做法是把规则文件纳入代码审查范围,随代码一起改。
第二步:先规划后编码
上下文回答的是「我在哪」,回答不了「该造什么」。直接放 AI 写代码,常见结果是选一个古怪的实现方案、优化错方向,或者悄悄忽略约束。作者的对策是强制两段式:先要计划,批准后再要代码。
规划阶段通常在对话模型里完成——问题还很模糊时,ChatGPT 的结构化梳理帮得上忙;设计大致合理后,再切到 Cursor 或 VS Code 里的 Claude Code 实现,因为落地要在真实代码库里进行。对任何不算琐碎的改动,第一轮对话只用平实语言描述功能或 bug,把想法捋成可执行的形状:
Here is the feature I want to build and some context.

Help me design it.

What needs to change?

Which modules are involved?

What are the main steps?
关键动作是拦住 AI 直接跳进代码,作者常明说一句「Do not write any code until I say approved」。计划看着合理了,批准,然后要求一步一步实现:每一步先解释将要改什么,只给这一步的代码。小步改动容易审查,出了问题也容易回退。他反复使用的完整模板如下:
You are a senior engineer helping me with a new change.

First, read the description of the feature or bug:
<insert feature or bug description and any relevant context>

Step 1 — Plan only:

- Think step by step and outline a clear plan.
- List the main steps you would take.
- Call out important decisions or tradeoffs.
- Mention edge cases we should keep in mind.

Stop after the plan. Do not write any code until I say "approved."

Step 2 — Implement:

Once I say "approved," implement the plan one step at a time:

- For each step, explain what you are about to change.
- Propose the code changes for that step only.
- Write tests for that step where it makes sense.
AI 在计划里推荐了没见过的库或函数,先用搜索助手或官方文档确认真实存在——模型有时会编造听起来可信的 API。这个先规划的模式在几类场景下回报最高:接手新技术栈时,AI 先解释再动手,学习和实现同步发生;改动横跨多个模块时,计划让人先看到全貌再动手;碰上没吃透的疑难 bug 时,与其说「把这个慢查询改快」,不如让模型先推理为什么慢、有哪些选项,推理认可之后再要具体修法。修改计划比修改一堆代码便宜得多,「approved」这道闸口逼着人先认可方案再放行。
这道人工批准的闸口,也是这套流程和当下流行的「后台 Agent 全自动跑任务」模式的分界线。全自动模式省掉了批准环节,适合已经能熟练判断 AI 输出质量的工程师;对新手,每一次批准都在训练自己评估方案的能力,等判断力稳定之后再逐步放权,顺序不宜倒过来。对各类 Agent 架构感兴趣的读者,可以参考站内的Agent 设计模式全解析。
第三步:轻量级角色分工
在规划习惯站稳之后,作者又加了一个提升可靠性的简单技巧:把工作拆成角色。这不是复杂的智能体系统,多数时候就是同一个模型换不同的提示词;有时也换模型——规划交给 Claude 或 ChatGPT(推理为重),实现换更快的模型(任务已明确,速度优先),Cursor 支持任务中途切换,操作成本很低。
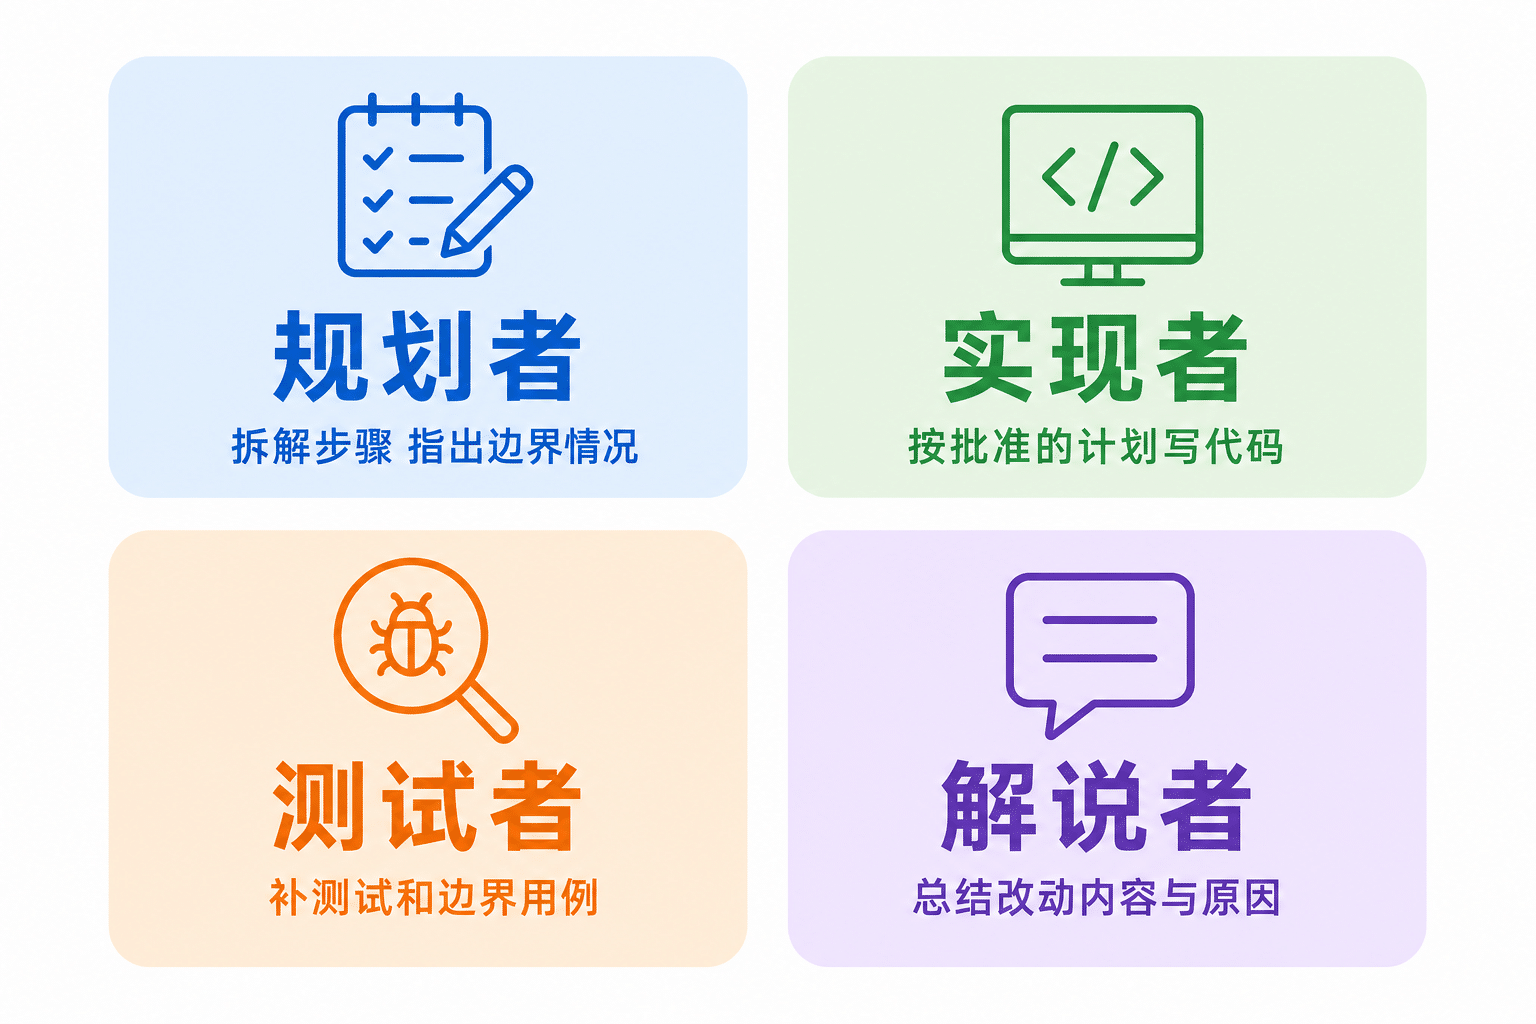
图:四个角色各管一段,同一个模型换提示词即可
四个角色的分工:规划者拆解任务步骤、指出边界情况,就是上一步覆盖的内容;实现者严格按已批准的计划写代码,提示词大意是「按批准的计划执行,只改我列出的文件,改动保持小,不清楚的先问再写」;测试者负责测试和边界用例——「为正常路径写单元测试,至少补两个边界用例;如果是 bug 修复,写一个修复前会失败的回归测试」;解说者收尾——「按文件总结变更,用平实语言解释逻辑,列出可能出问题的地方以及测试如何覆盖」。
拆分的理由有两个。其一,大而全的提示词招致混乱的回答:让 AI 一口气完成规划、实现、测试、解释,产出会纠缠成一团;拆开后得到的是一份清单、一小段改动、几个测试、一段说明,每一份都容易审。其二,长对话会漂移:来回多了,模型忘掉早先的决定,或者把坏主意翻出来重用,短而聚焦的会话更稳。配套技巧是在角色之间做小结——一个角色收尾时先要一份简短总结,粘进下一个提示词的开头,上下文就不会在长对话里丢失。
第四步:AI 辅助代码审查
AI 生成的代码需要额外一层审查。模型错的时候依然自信,似是而非的代码里最容易藏细小的 bug。作者在合并前加了一层自动化审查,用的是 CodeRabbit 这类接入 GitHub、GitLab 的工具:PR(pull request,代码合并请求)一打开,它自动审查 diff(两个版本代码的差异)并把评论发在 PR 线程里。这类工具通常给两样东西:一份变更摘要,常带逐文件走查,用来先确认 PR 和意图相符;以及逐行评论,常能标出缺失的错误处理、边界情况、潜在安全问题和差一错误这类逻辑 bug,审查过程中还能顺带跑 linter(静态代码检查器)和安全分析。同一个 PR 追加提交时,它做增量审查,不会把全部内容重审一遍。
典型的 PR 流程四步走:开一个小而聚焦的 PR;审查工具自动留言;阅读评论,修掉真问题,对噪音或缺少上下文的留言回复说明;合并前再做一轮人工终审。评论不必条条照办,分成两桶处理——必须修的(逻辑错误、缺失的错误处理、安全问题)和值得考虑的(风格偏好、命名建议、替代方案)。拿不准某条评论要不要理会时,问两个问题就够了:这会不会引发 bug?会不会让后来读代码的人困惑?任一答案为是,要么修掉,要么补个测试。
AI 审查工具的局限和其他 AI 工具一样:会误报不是问题的问题,会建议不符合本仓库风格的模式。它的价值在于提早抓住明显的问题,而不是替代人的判断,合并前的人工终审省不得。
第五步:测试紧跟改动
在这套流程里,测试是流程本身的一环,不是收尾的杂务。任何不算小的改动一完成,作者立刻索要测试,不等功能全部做完。测试同时承担验证和文档两个职责——AI 如果写不出一个说得通的测试,往往说明它刚生成的代码本身就不清楚。
不同场景要不同的测试。新函数要覆盖正常路径和边界情况的单元测试:作者在自己不熟的技术栈里用 AI 写完一个 React 组件后,紧接着的一句就是「现在为这个组件写单元测试」,测试反过来告诉他这个组件应该做什么、如何处理不同输入。bug 修复要回归测试,修复前必须失败、修复后必须通过,既证明修复有效,也防止旧病复发。跨组件或涉及接口端点的改动,则要一个最小的集成或端到端测试,附上简短的功能描述,要求覆盖一条真实用户流程加几个边界情况。四个模板都可以直接复用:
Write unit tests for this function.

Cover the happy path and at least two edge cases.
Write a regression test for this bug.
The test should fail before the fix and pass after.Write a minimal integration test for this feature.
Include one realistic user flow and a few edge cases.Review these tests.
Are there obvious edge cases missing or any weak assertions?作者坦承自己刚开始用 AI 写码时,生成完函数就接着往下走,测试后补甚至不补,结果 bug 照常上线,自己也不总明白代码在做什么。现在的习惯是代码之后马上要测试——读测试常常比读函数学到的更多,输入、期望输出、要处理的边界一目了然。生成的测试看不明白时,这本身就是信号:要么代码不清楚,要么提示词不完整,先回头解决再往前走。
第六步:调试与迭代
出问题的时候,作者不是贴个报错就指望奇迹。给模型的信息和给同事的一样多,共四类:报错信息或完整堆栈、出错的函数、相关的周边代码或类型定义、期望的行为与实际的行为。
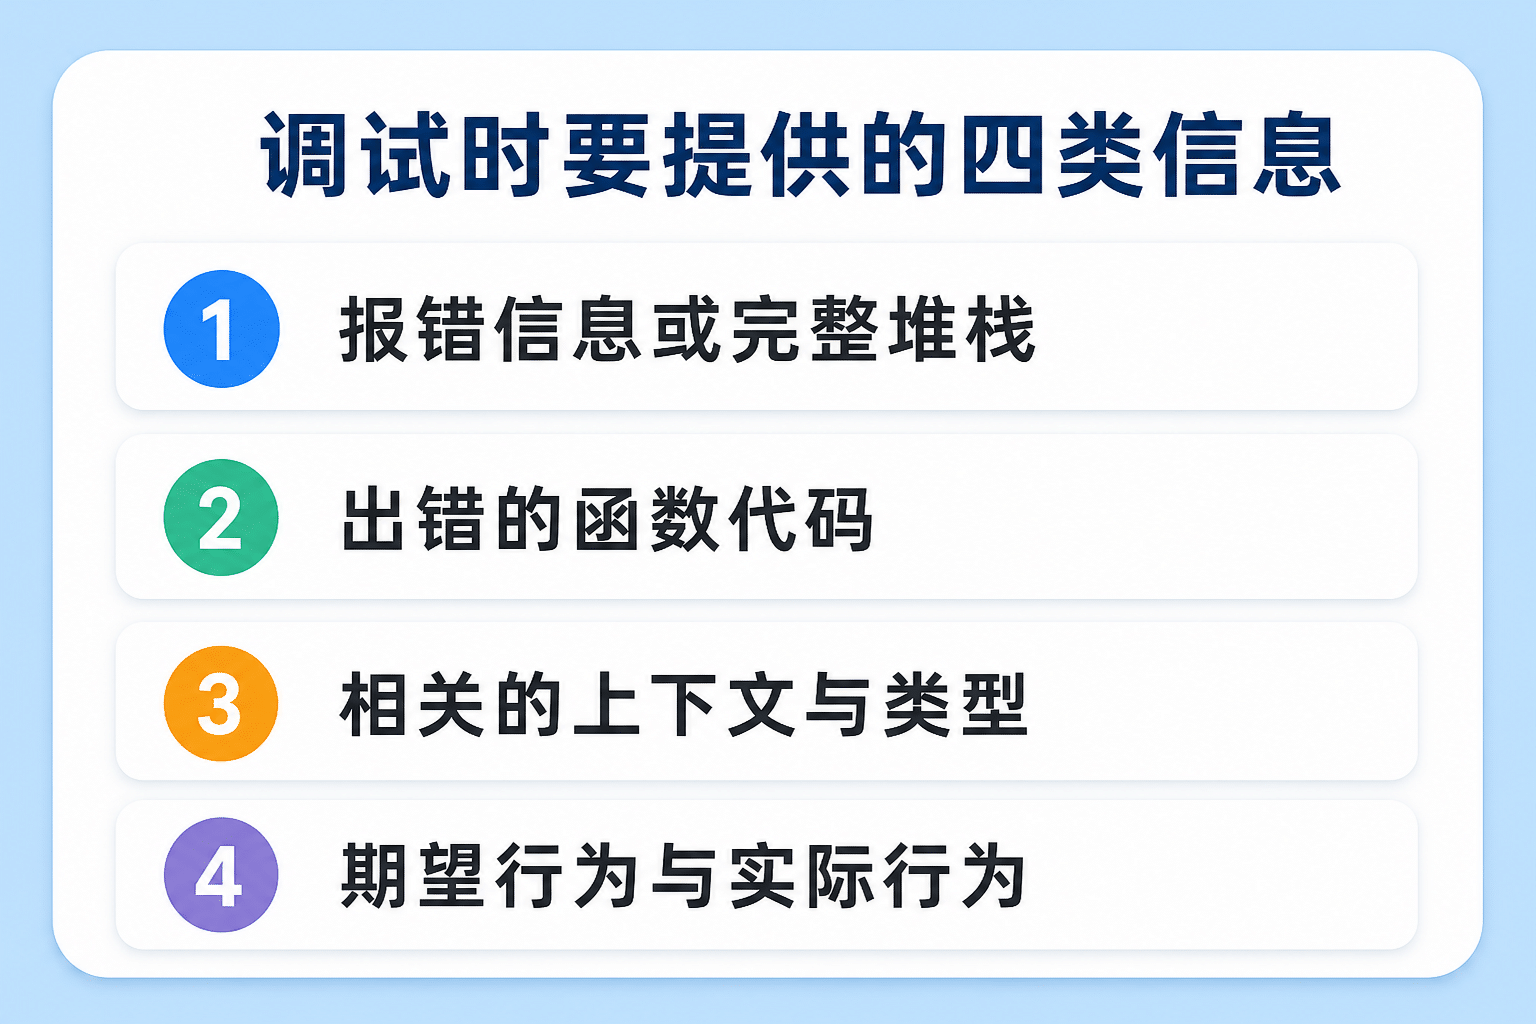
图:调试时的信息清单,和请同事帮忙时给的一样
要避免的做法与之对应:只贴报错不贴代码、把整个文件倾倒进去却不指出相关段落、只说「跑不起来」却不描述失败的具体方式。他调试时常用的提示词把诊断和修复合在一次请求里:
Here is the function and the error message.

Explain why this is happening.

Then rewrite the function using best practices, while keeping it efficient and readable.
一次拿到解释加修复,顺带弄懂错在哪里,而不只是打上补丁。修复无效时有一条明确的止损规则:同一个线程里问了两次、回答开始重复或者变差,就停下来。开一个新会话,带着更好的上下文重述问题,并把问题问小——「修好这个函数」不如「这个变量在什么条件下会是 null」。新上下文加小问题,多数时候胜过一条疲惫的旧线程。
还有一种情况是自己都没看懂问题,没法评估 AI 给的修复对不对。这时先停止索要代码,改要解释:
Do not fix anything yet.

Explain what this function does, step by step.

Then list the most likely failure cases.
弄懂逻辑之后再回头要针对性的修复,避免陷入「接受一个看不懂的修复并祈祷它能用」的循环。
常见失败模式与对策
循环跑得多了,作者发现出问题的总是同样的几个地方,他维护了一份对策清单:
长对话上下文漂移。对话拖长,模型会忘掉早先的决定。对策是会话短而专一:设计一个会话,A 部分一个,B 部分一个;线程乱了就让模型总结当前进度,带着总结开新会话。
API 或版本用错。模型的训练数据有截止时间,可能按旧版本写代码,或者生成不存在的方法。凡是新出的或演进快的库,默认它的建议可能有错,对照官方文档验证;也可以让模型自报假设——「你假设的是哪个版本?」对不上环境就自己动手改。
调试原地打转。模型一旦认死一个坏思路就会越挖越深,变着措辞提出同一个失败的修复,有时还把早前的 bug 重新引进来。对策在第六步已经给出:停下、开新会话、缩小问题。
代码质量滑坡。AI 默认产出的是「能跑的东西」,离「三个月后还愿意维护的东西」有距离。把质量要求直接写进请求里:要测试、要变更说明、给结构引导,「重构成更小的函数」「参照文件 X 里的模式」。
过度依赖。这一条与模型无关,与人有关。所有决定都交给 AI,自己的判断力会钝化。作者的对策是重要决策留在人手里,偶尔不借助 AI 完成小任务,并要求模型既做事也教学:解释推理过程、比较方案、讲清取舍。目标不只是交付更快,而是交付更快的同时明白自己交付了什么。
国内落地与适用边界
原文提到的工具在国内使用有现实门槛:ChatGPT、Claude、Gemini 的网页服务在中国大陆需要相应的网络环境,Cursor 等产品的订阅还需要海外支付渠道。好在这套流程和具体产品是解耦的。编辑器一侧,通义灵码、字节跳动的 Trae、百度 Comate 都提供「编辑器内 AI 加引用项目文件」的核心能力;对话规划一侧,DeepSeek、Kimi、通义千问可以承担规划者的角色。README 开场、规则文件、先计划后批准、小步实现、测试紧跟——每一个环节在国产工具组合上同样跑得通。想从零体验一遍这类工具的读者,可以参考站内的零代码用 Claude Code 搭建 Telegram 智能助手的实操记录。
流程本身也有适用边界,成本要和变更风险匹配。存量业务代码库、多人协作项目、涉及资金或数据安全的模块,值得走全六步;一次性脚本、用完即弃的原型,直接生成、跑通即可,套完整流程反而是负担。取舍标准是出错的代价:代价高的改动值得走全流程,代价低的不必。
原文结尾的一段话适合作为收束:工具会换代,模型会更新,价格会调整,能留下来的是方法——怎么给上下文、怎么把工作拆成步骤、什么时候用模型、什么时候靠自己。六步循环看起来朴素,但它省下的是 AI 编程里最费时间的部分:清理那些看起来可信、实际错误的输出。
© 版权声明
文章版权归作者所有,未经允许请勿转载。