把多个 AI Agent(智能体)组成一个团队协同干活,听起来并不复杂:几个智能体各管一摊,合力完成单个智能体做不完的事。实际动手就会发现,十个多智能体项目有九个停在演示阶段——智能体之间不共享上下文、不分工、互相不知道对方在做什么,最后变成一个模型在五个窗口里自言自语。
本文整理的这份路线图,方法论主要来自 Anthropic 围绕 Claude Agent SDK 发布的工程文章、其多智能体研究系统的公开架构,以及 2026 年已经把智能体系统跑进生产的团队的共同做法。它把从第一个智能体到生产级团队的过程拆成三层九个阶段:先把单个智能体做对,再让多个智能体协调起来,最后把整套系统推到生产可用。多智能体系统缺的从来不是更聪明的模型,缺的是这九层结构。
第一层:先把单个智能体做对
阶段一:把智能体写成循环
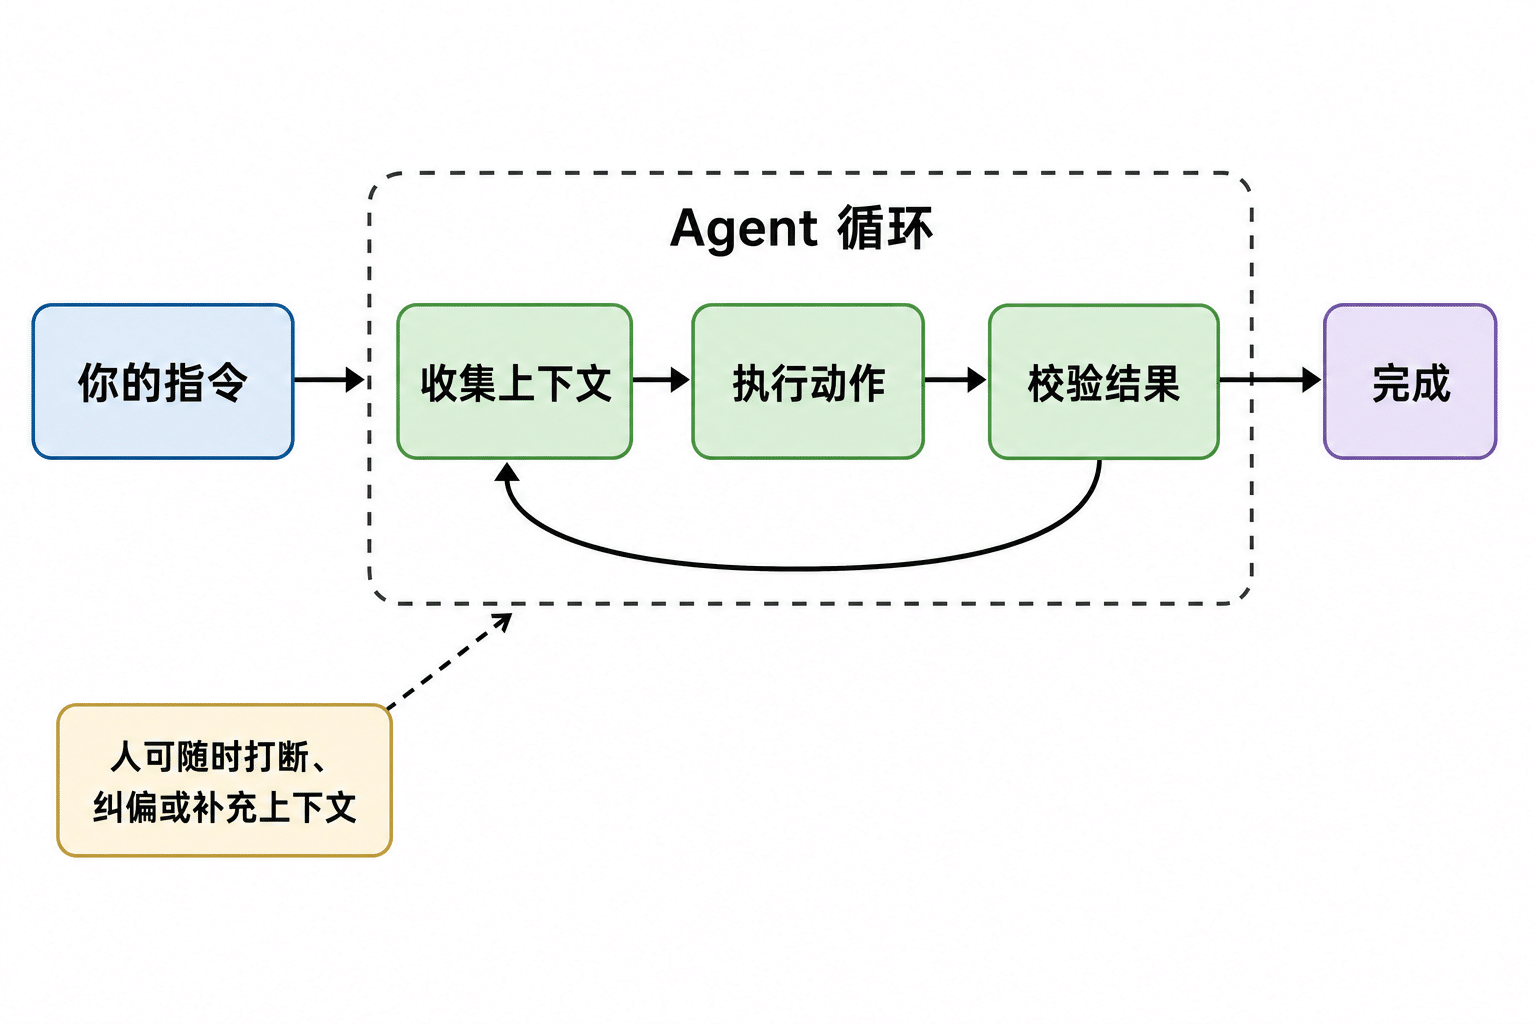
在第一阶段开始之前,最常见的错误已经发生了:把一个聪明的聊天机器人当成智能体。聊天是一问一答的单轮交互;智能体是一个循环——模型拿到目标,选择动作,执行,观察结果,再决定下一步做什么,直到目标完成或者触发停止条件。用伪代码看,这个形状一目了然:
def run_agent(goal):
    context = build_initial_context(goal)
    while not_done(context):
        action = model.decide(context)          # pick next tool call
        if action.requires_approval:
            wait_for_human(action)
        result = execute_tool(action)           # actually do it
        context = update_context(context, result)
        log_trajectory(action, result)          # for evals later
    return final_answer(context)
注意这段代码里已经埋好了三样东西:一道人工审批门、一个日志钩子、一个明确的停止条件。如果你的”智能体”只是一个巨大的提示词,指望模型一口气把所有事做完,那只能算一次超长的文本补全——本文后面所有内容,都以代码里有一个真实循环为前提。
停止条件比多数人以为的重要得多。一个没有明确终点的循环会持续烧钱。常见的停止条件有四种:目标达成、达到最大迭代次数(一般设 30-50)、用户手动中止、错误次数超过阈值。max_iterations 任何时候都要设——一个失控的智能体,比一个慢的智能体损失大得多。
阶段二:上下文工程——写入、筛选、压缩、隔离
上下文是智能体系统里最贵、也最脆弱的部分。很多看起来像”模型变笨了”的故障,实际是上下文出了问题:模型根本没拿到需要的信息,或者拿到的太多、注意力被冲散,或者拿到的信息已经过期。Anthropic 的工程文章把上下文管理归纳为四个操作:
- 写入(Write):每一步往上下文里加什么要精挑细选,每一行都在消耗 token 和模型的注意力。
- 筛选(Select):从记忆或文件里按需检索,不整段倾倒。
- 压缩(Compress):上下文快满时把旧内容摘要化,同时保留关键决定不丢。
- 隔离(Isolate):子代理在自己的上下文窗口里干活,主线程保持干净。
落到代码上,这意味着用一个结构化的上下文对象,而不是自由拼接字符串。一个能用的智能体上下文大致长这样:
{
  "goal": "the user's actual task, never overwritten",
  "plan": ["step 1", "step 2", "step 3"],
  "completed_steps": [/* with results, compressed if old */],
  "working_memory": "current focus, evicted between subtasks",
  "tool_results": "last 5 tool outputs, full fidelity",
  "selected_files": [/* paths read this turn, not dumped wholesale */],
  "constraints": "things never to do, always loaded"
}
四个操作里收益最大的一项是隔离子代理的上下文。主智能体把调研任务派给子代理时,子代理拿到的是一个全新的窗口,里面只有任务本身和相关文件;它交回来的是一份摘要,而不是完整的过程记录,主智能体从头到尾不接触那些噪音。子代理这套模式能成立,靠的就是这一点。
阶段三:给工具写类型化的调用规范
没有类型化的工具 schema(调用规范),模型每次调用工具都在即兴发挥:自己猜消息格式、猜参数结构、猜权限边界。生产环境里的多数故障就出在这里——模型不是不会调工具,而是猜错了格式、传错了参数,或者做了不该有权限做的事。类型化 schema 把任务从”猜怎么调”变成”照着字段填”,还能让运行框架强制执行模型绕不过去的规则:
{
  "name": "github",
  "operations": {
    "create_pr": {
      "required_args": {
        "title": { "type": "string", "max_length": 72 },
        "body":  { "type": "string" },
        "base":  { "type": "string", "default": "main" },
        "head":  { "type": "string" }
      },
      "preconditions": ["all tests must pass", "branch has commits ahead"],
      "side_effects":  ["notifies reviewers", "triggers CI"],
      "requires_approval": false
    },
    "merge_pr": {
      "required_args": { "pr_number": { "type": "integer" } },
      "preconditions": ["CI passing", "at least one approval"],
      "requires_approval": true
    },
    "force_push": {
      "blocked_targets": ["main", "production", "staging"],
      "requires_approval": true
    }
  }
}
第二层:让多个智能体协调起来
阶段四:派生带独立上下文的子代理
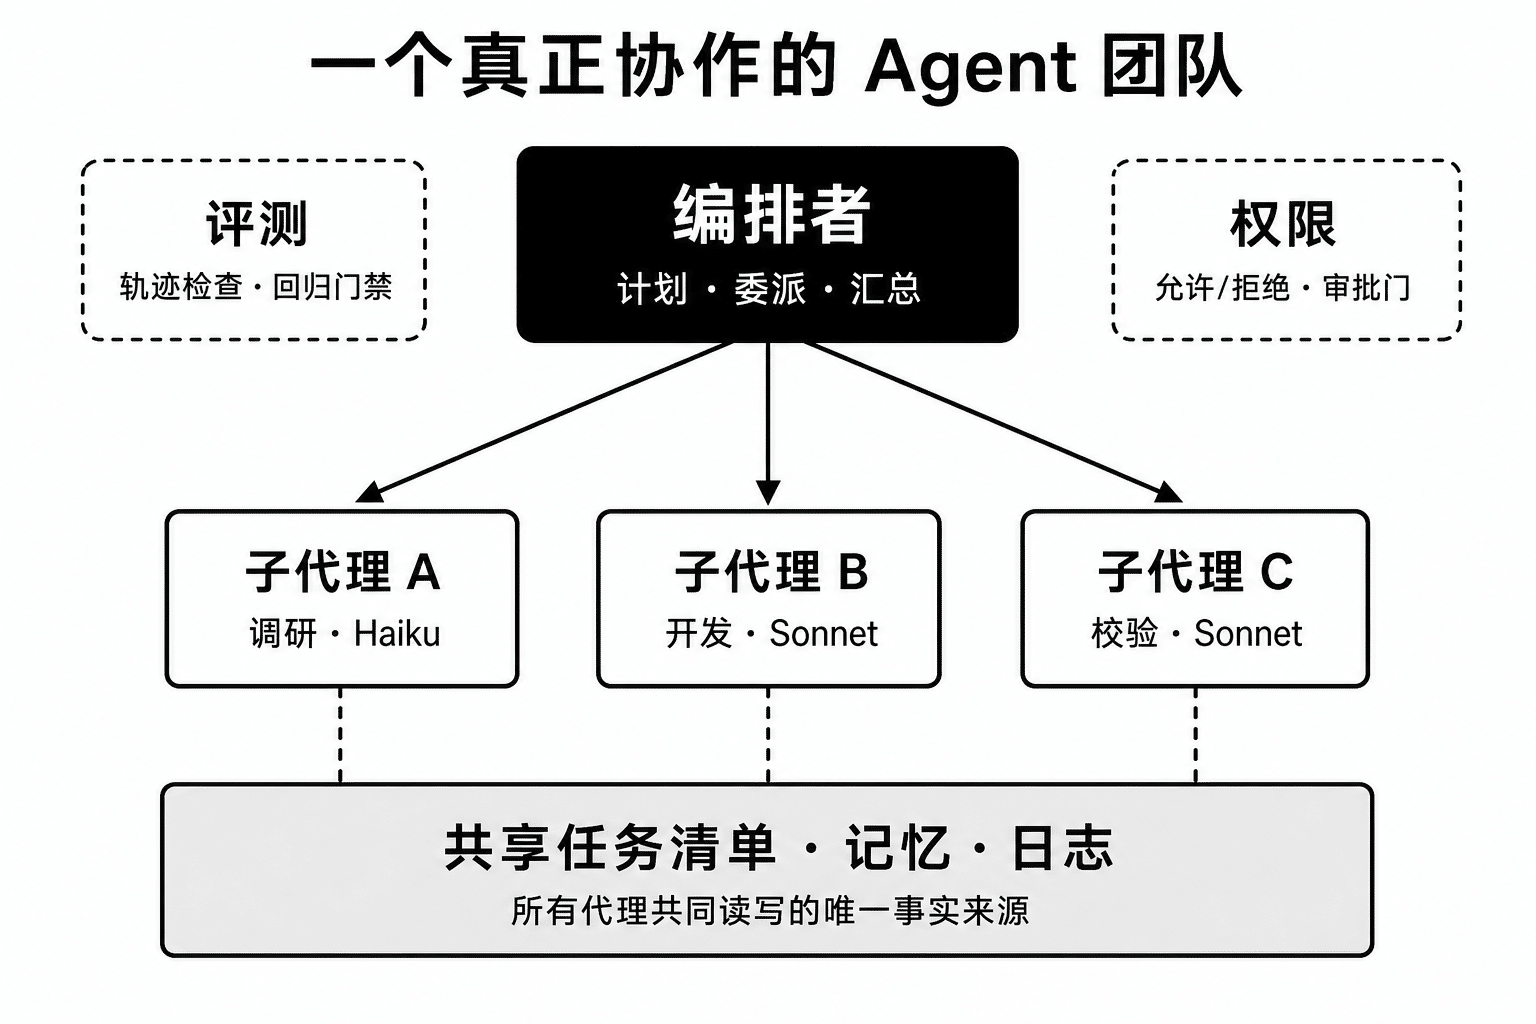
子代理(subagent)不是主智能体的复制品,而是一个专才:有自己的上下文、自己的工具集,通常还跑在不同的模型上。编排者判断”这部分是调研活”,就派生一个调研子代理——只给它相关的目标,只开放相关的工具,跑在 Haiku 这类更便宜的模型上,然后等它交回一份摘要。在 Claude Agent SDK 里,这个动作对应的就是 Task 工具。调用的形态大致如下:
spawn_subagent(
    role="research",
    model="claude-haiku-4-5",
    goal="find every API endpoint in src/ that lacks auth",
    tools=["grep", "read_file"],
    return_format="summary + file list"
  )

▲ subagent_a  starting in isolated context…
- scanning 142 files
- 11 endpoints flagged
✓ done · returned 1.2K-token summary, full transcript not loaded into parent
其中 return_format 字段比任何提示词都重要。允许子代理自由发挥地返回长文本,编排者很快会被淹没;强制结构化返回——一段摘要,加一个事实清单、文件清单或发现清单——编排者才能直接拿这些结构化结果做下一步决策,不必读过程里的噪音。
阶段五:编排者只计划、委派、汇总,从不亲自执行
编排者(orchestrator)是整棵智能体树顶端的那一个,它的全部职责是制定计划、分派任务、收拢结果。它不写代码、不跑查询、不直接调外部接口——一旦亲自动手,那些本该留在子代理内部的细节就会灌进它自己的上下文,把全局视野挤掉。编排者保持轻量,才能始终看得见整个任务。一个能工作的编排者,在主循环里嵌着三步:
def orchestrator_loop(goal):
    plan = make_plan(goal)                  # step 1: PLAN
    results = []

    for step in plan:
        subagent = pick_specialist(step)    # step 2: DELEGATE
        result   = run_subagent(subagent, step)
        results.append(result)

        if plan_needs_revision(result):
            plan = revise_plan(plan, result) # adapt mid-run
    return synthesize(results)             # step 3: GATHER
编排者通常用最强的模型(在 2026 年就是 Opus 这一档),下面的子代理用 Sonnet 或 Haiku。成本账在这里就算通了:贵的模型只跑计划,便宜的模型干具体活。按这个结构组织的团队,总成本比单个 Opus 从头扛到尾更低,任务吞吐量却能达到 5-10 倍。
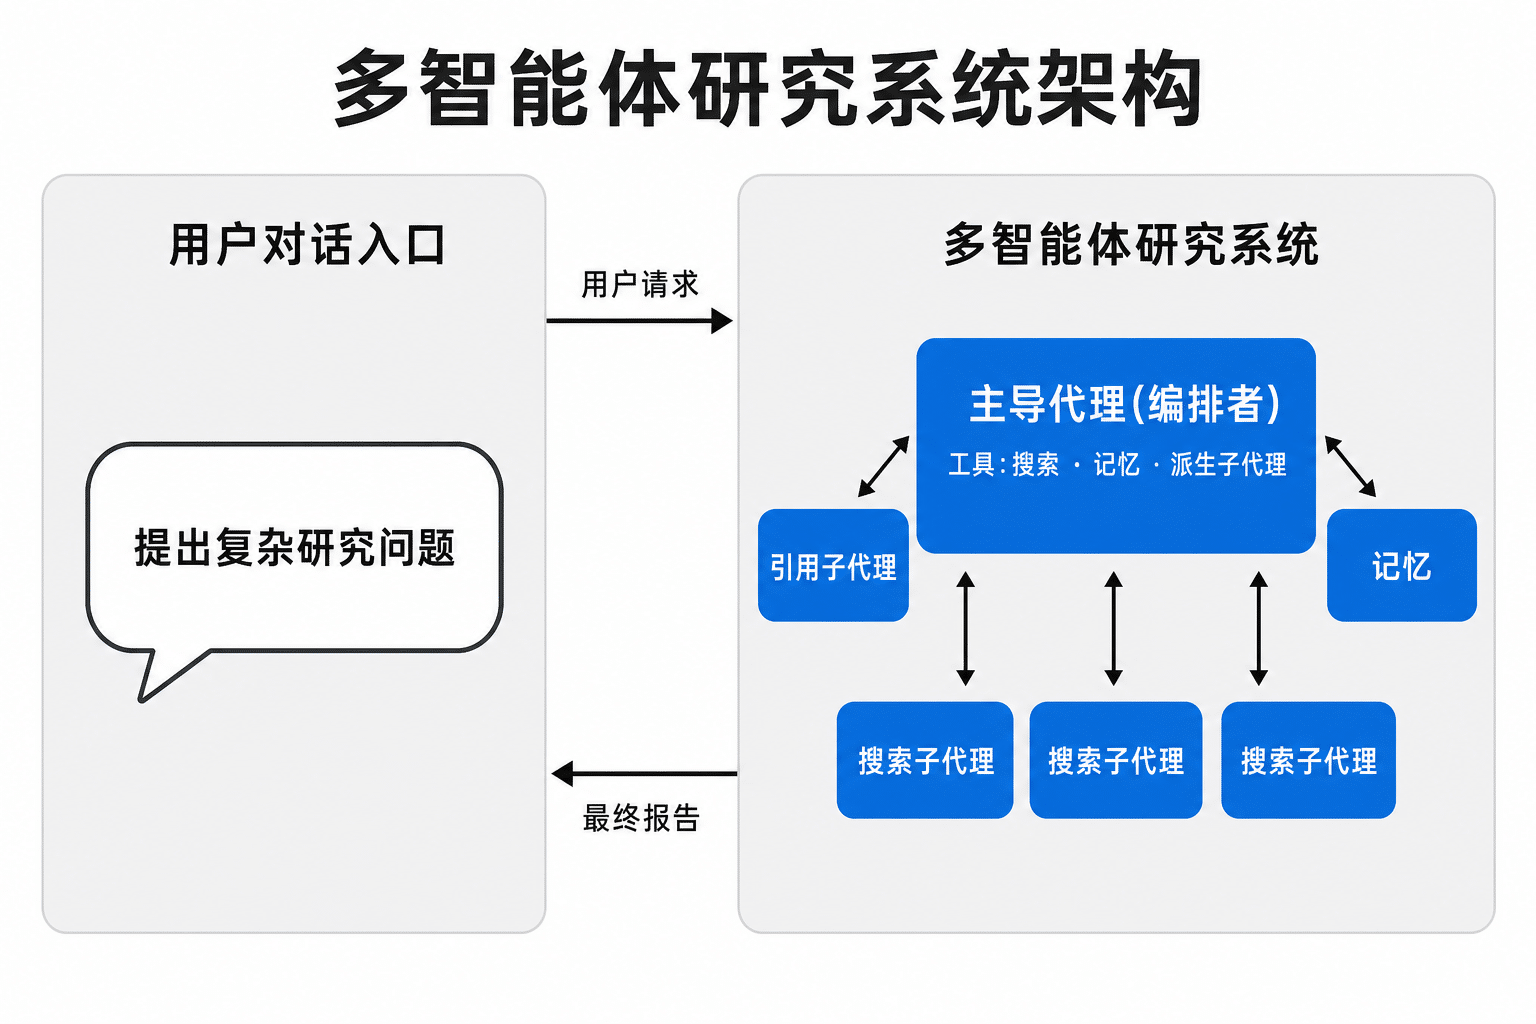
Anthropic 公开的多智能体研究系统就是这个形态:主导代理负责拆解问题和汇总报告,多个搜索子代理并行查资料,引用子代理在最后统一补引用来源。站内此前介绍过的 QuantAgent 多智能体量化交易分析平台,用的也是同一类编排结构。
阶段六:建一份所有智能体共读共写的任务清单
没有共享状态,所谓”团队”只是几份并行的单干:两个子代理同时开工同一步,有人完成了一步但没人知道,编排者忘了什么任务派给了谁。解法是一份唯一的共享任务清单,每个智能体都从它读、往它写——不是一份随意编辑的文档,而是结构化文件:
{
  "goal": "Add auth to all unprotected endpoints",
  "tasks": [
    {
      "id": "t1",
      "description": "Find unprotected endpoints",
      "status": "done",
      "assignee": "subagent_a",
      "result": "11 endpoints in src/routes/*.ts"
    },
    {
      "id": "t2",
      "description": "Add JWT middleware to each",
      "status": "in_progress",
      "assignee": "subagent_b",
      "depends_on": ["t1"]
    },
    {
      "id": "t3",
      "description": "Write integration tests",
      "status": "pending",
      "assignee": null,
      "depends_on": ["t2"]
    }
  ]
}
这份文件解决了三件纯靠模型记忆解决不了的事:assignee 字段显式记录任务归属,两个智能体不会抢同一个活;depends_on 显式声明依赖,子代理不会在输入还没就绪时开跑;status 显式标注进度,编排者不用翻对话记录做推理,就能知道整体进行到哪了。
工程上还有一个原文没有展开的细节:多个子代理并发写同一份 tasks.json,会出现互相覆盖。常见的处理办法是只允许编排者写、子代理只读,或者给文件加写入锁。
第三层:推到生产可用
阶段七:接上记忆、持久化和沙箱
演示用的智能体,会话一结束就什么都忘了;生产团队要记住该记的、忘掉该忘的。三件事按顺序接入:
- 记忆:一个由智能体主动写入的结构化存储,而非会话日志——日志太吵。每个值得留下的事实、决定、惯例单独存一条,比如 memory/decisions.md、memory/conventions.md、memory/known_failures.md,下一次会话显式加载这些文件。
- 持久化:每一步先把动作和结果写进磁盘,再进行下一步。进程中途崩溃,下次启动读一遍执行轨迹就能接着跑。没有这一层,一个 50 步的任务在第 47 步失败,就得从零重来。这是智能体工程里最容易被忽略的一个环节。
- 沙箱:智能体跑在容器或受限子进程里,没有显式授权的资源一律碰不到——不会因为某句提示词跑偏就去读你的用户主目录,也不会往项目目录以外写文件。沙箱的作用,是把智能体的活动范围死死限制在授权之内。
其中记忆里的决策日志,实际长这样:
# Decisions log

## 2026-05-22
- chose JWT over session cookies (mobile clients drive this)
- auth lives in src/auth/, never duplicated per route
- all endpoints under /api/admin require role check, not just login

## 2026-05-29
- adopted shared task list pattern (state/tasks.json)
- orchestrator on Opus, subagents on Sonnet/Haiku
- max_iterations = 30 per loop, hard cap enforced by harness
阶段八:接上评测和轨迹检查
多数团队改完智能体系统之后,并不知道这次改动是变好还是变坏:在熟悉的任务上跑两遍,感觉更好了,就上线了。六周之后,系统在他们忘了测的场景上表现得比原版还差。评测(evals)解决的就是这个问题。一个生产团队需要三层测量:
- 评测集:20-100 个冻结的任务,配上已知的正确输出。每次有实质改动就跑一遍,长期跟踪通过率。
- 轨迹检查:不只看”做完了没有”,还要看”是不是调用了对的工具、按大致正确的顺序调用的”。答案对但路径错,就是一个埋着的回归隐患。
- CI 回归门禁:评测集在每个 PR 上自动运行,通过率低于阈值就拦下合并——和代码测试同一套纪律。
{
  "id": "auth_refactor_001",
  "input": "Add JWT auth to all unprotected /api/* endpoints",
  "expected": {
    "endpoints_protected": 11,
    "files_touched": ["src/auth/jwt.ts", "src/routes/*.ts"],
    "tests_added": "at least one per endpoint",
    "no_changes_to": ["src/db/", "src/email/"]
  },
  "trajectory_must_include": [
    "grep_for_unprotected_endpoints",
    "read_existing_auth_module",
    "apply_middleware_to_each_endpoint",
    "run_tests"
  ],
  "max_iterations": 30
}
trajectory_must_include 这个清单是整套评测里最有价值的部分。两个智能体可以给出相同的答案,但走的路径天差地别——一条安全,另一条离事故只差一次误批。轨迹检查能在上线之前拦住不安全的那条。再配合对真实生产运行做匿名记录,评测集就能从实际发生过的案例里自动积累,省去手工编造测试任务。
阶段九:写好权限文件,留好人工检查点
最后一个阶段,决定了你敢不敢让这套系统整夜自己跑。一份权限文件声明三类边界:哪些事不用问、直接做;哪些事必须人批;哪些事永远不许做。运行框架在每次工具调用前都读这份文件——规则放在模型外面,模型绕不过去。
## Always allowed (no approval needed)
- read any file in the project directory
- run tests
- create branches
- write to memory/ and skills/ directories
- create draft pull requests

## Requires approval
- merge pull requests
- deploy to any environment
- delete files outside of memory/working/
- install new dependencies
- modify CI/CD configuration

## Never allowed
- force push to main, production, or staging
- access secrets or credentials directly
- send HTTP requests not in the approved domains list
- modify permissions.md (only humans edit this file)
- disable or bypass pre_tool_call hooks

## Approved external domains
- api.github.com
- registry.npmjs.org
- pypi.org
这份文件是整个生产技术栈里最重要的一份产物:有它,智能体团队可以放心留着过夜;没有它,就得随时有人盯着。它应该在派生第一个子代理之前写好,而不是等第一次事故之后再补。
用 Claude Code 的读者不需要从零造这套机制:settings.json 里的 permissions 允许/拒绝清单加上 hooks,就是这份权限文件的现成实现;子代理派生(Task 工具)和记忆目录也都有内置对应物,直接按这九个阶段的思路配置即可。
让团队卡在演示阶段的九种做法
对照自查,每一条都对应前面的一个阶段:把一段”逐步思考”的长提示词当成智能体,没有迭代、没有观察、没有恢复;往上下文窗口里自由堆料,模型注意力被冲散;工具不带类型约束,模型乱猜参数,有时猜出破坏性的结果;子代理和编排者共享上下文,得到的是五个凑在一起闲聊的智能体,而非一个分工明确的团队;编排者亲自下场写代码,淹死在本该由专才处理的细节里;没有共享任务清单,团队退化成重复劳动的并行单干;没有持久化,长任务一崩就全部重来;没有评测,”更好”全凭感觉,六周后没人说得清系统为什么好用或不好用;没有权限文件,跑得快,但没有安全网,离真实事故只差一次误批。
适用边界与国内落地
这套结构并不适合所有任务。Anthropic 在多智能体研究系统的公开复盘里给过一组数据:单个智能体的 token 消耗约是普通对话的 4 倍,多智能体系统约是 15 倍。按 Claude API 的计价粗算,一次多智能体任务的成本可能是一次普通对话的十几倍。所以它只适合价值足够高、可以并行拆解、单个上下文窗口装不下的任务;日常的单点任务,一个智能体甚至一次对话就够,硬上团队只是多花钱。
落地条件上有两点需要交代。其一,文中示例绑定 Claude Agent SDK,而 Claude API 在中国大陆无法直连,需要相应的网络环境才能使用。其二,九个阶段本身与具体框架无关:不具备条件的团队,可以在 LangGraph、CrewAI 这类开源编排框架,或国内团队开源的 MetaGPT 上落同一套结构——编排者、子代理、共享状态、评测、权限,每一层在这些框架里都有对应的实现位置。
结语
一个能干活的智能体团队,靠的不是更强的模型,而是更多的结构。这九个阶段没有一样是黑科技,全部是工程管道:2026 年把多智能体系统跑进生产的团队,用的模型和所有人一样,差别只在智能体之间那九层结构。如果你此前试过多智能体没有成功,原因多半就在某个被跳过的阶段里——最常见的是共享任务清单和权限文件这两处,优先补齐它们,再逐个补其余的。对刚上手的读者,第一层的三个阶段值得反复打磨,后面六个阶段全部建立在单个智能体已经可靠的前提上。
© 版权声明
文章版权归作者所有,未经允许请勿转载。