AI 应用要发挥作用,离不开外部上下文:编码助手要读代码库,客服机器人要查订单数据库,办公助手要访问网盘里的文档。在 MCP 出现之前,每一条这样的连接都要单独开发、单独维护。2024 年 11 月,Anthropic 发布 MCP(Model Context Protocol,模型上下文协议),要把”AI 连接数据源”这件事标准化。本文基于 System Design Newsletter 的深度解析,拆解 MCP 针对的问题、三层架构和三大原语,并补充协议生态与国内落地的现状。
N×M 集成困境
大语言模型的知识停在训练截止日,外部世界却在持续变化。想让 AI”盯着服务器日志报警”,不能只把日志文件喂给它——得搭一条数据管道,每隔几秒轮询日志 API,滤掉噪音,再把有价值的异常推进模型的上下文窗口。API 一旦调整限流策略或响应格式,整条链路就断了。
单条集成已经这么麻烦,规模化之后问题更大。以 AI 编码助手接入 GitHub 为例,一次完整的集成开发包括:
- 编写连接 GitHub API 的代码;
- 实现认证与安全控制;
- 把 GitHub 的数据格式转换成模型能理解的形式;
- 处理限流、报错和各种边界情况;
- 换成 GitLab、Bitbucket,以上工作全部重来一遍。
行业里每家都在重复这套劳动:Cursor 想支持 Notion,从零写一套集成;GitHub Copilot 想要同样的功能,再写一套。N 个 AI 应用乘以 M 个数据源,就是 N×M 条需要开发和维护的定制集成,原文把这称为 N×M 问题。
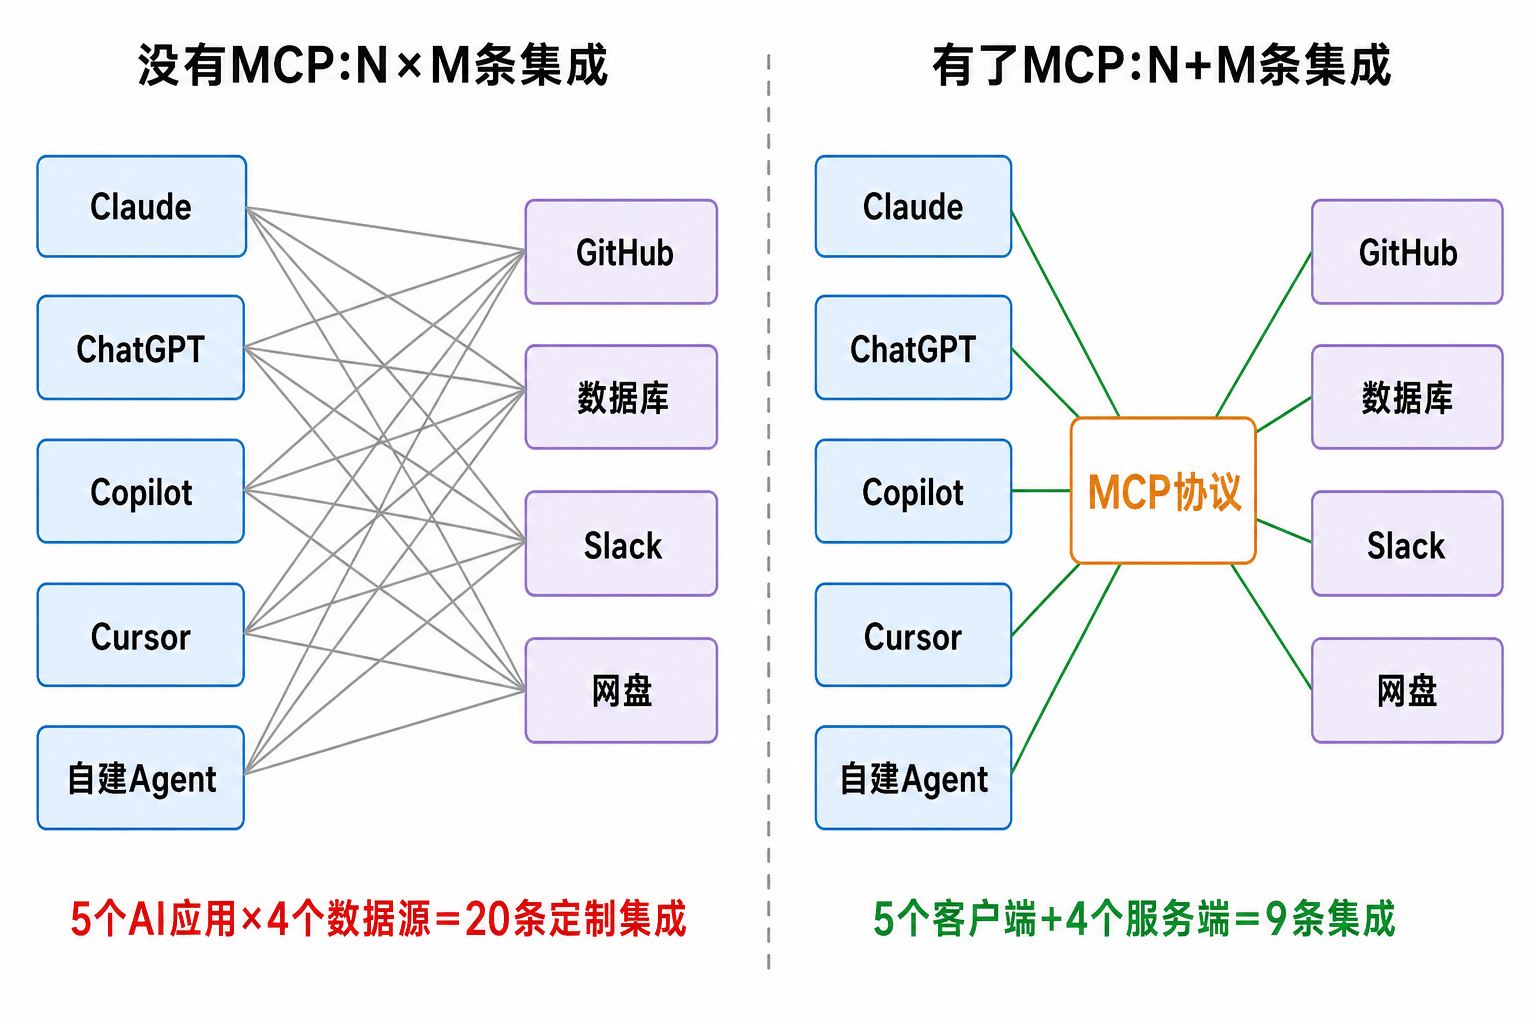
图:同样 5 个 AI 应用、4 个数据源,集成数量从 20 条降到 9 条(据原文图示重绘)
原文用 USB-C 作类比:USB 出现之前,鼠标用 PS/2 圆口,打印机用并口,相机用各家专有线材,电脑要为每种设备准备专门的接口;有了统一标准之后,任何设备插任何主机都能直接用。MCP 想做的就是 AI 世界的 USB-C:模型这头只说一种”语言”,数据源那头也只需实现一种接口。
传统集成方式的三个结构性缺陷
除了工作量,原文还指出定制集成有三个更根本的问题:
静态的构建期集成。应用能连哪些数据源在开发阶段就写死了,用户想接新数据源只能等官方支持,快速试验无从谈起。
安全实现各自为政。每条集成都要重新实现一遍认证、授权和数据保护,安全模型不统一,攻击面随集成数量同步扩大。
没有标准的能力发现机制。AI 无法主动询问一个数据源”你能做什么”,所有能力都要提前硬编码,智能体也就谈不上自主适配新工具。
MCP 的解法:从 N×M 到 N+M
MCP 的思路很直接:定义一个所有系统通用的协议。AI 应用只需实现一次 MCP 客户端,就能接入所有存量数据源;数据源只需实现一次 MCP 服务端,就能被所有 AI 应用调用。集成总量从 N×M 降到 N+M。
支撑这套效率的是两个架构设计。
动态能力发现。MCP 采用握手模型:AI 连接到一个 MCP 服务端时先问”你能做什么”,服务端实时返回可用的资源和工具清单。原文举的例子是给数据库服务端新增一个”用户退款”工具,AI 智能体下次连接时立刻就能发现并使用它,AI 应用侧一行代码都不用改。
智能与数据解耦。MCP 把”负责思考的系统”(模型)和”负责知道的系统”(数据源)分开。数据团队专心为内部 API 构建安全可靠的 MCP 服务端,不用关心最终是哪个模型在调用;AI 团队随时更换模型,不用重建数据集成。数据层建一次,之后接什么智能层都行,基础设施不会因为新模型发布而报废。
三层架构:宿主、客户端与服务端
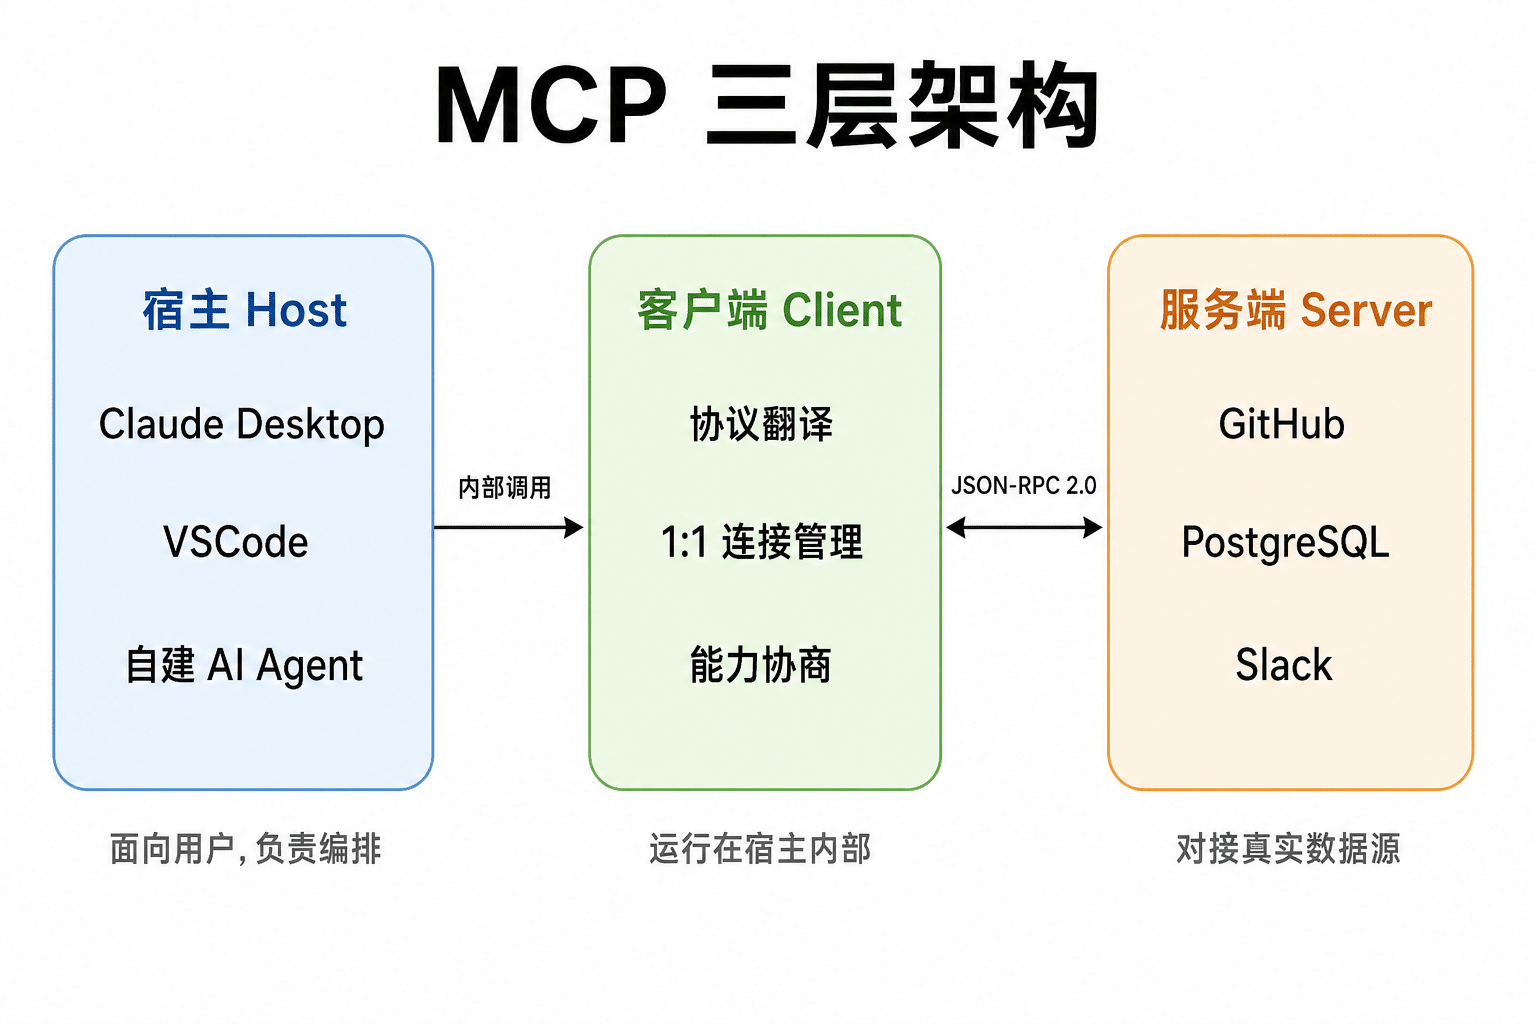
图:MCP 三层架构与各层职责(据原文架构图重绘)
宿主(Host)是面向用户的应用,比如 Claude Desktop、VSCode 这类 IDE,或者自建的 AI 智能体。宿主负责解释用户的指令,判断本次请求需不需要外部数据或工具;需要时,它会创建并管理若干内部客户端——每连接一个 MCP 服务端,就维护一个对应的客户端。
客户端(Client)运行在宿主内部,是协议层的执行者。每个客户端与一个 MCP 服务端保持一对一的专属连接,把宿主发来的抽象请求翻译成服务端能理解的标准消息(如 tools/call、resources/read,底层是 JSON-RPC 2.0)。连接建立时的能力协商由客户端发起,断线重连、会话状态维护也归它管。
服务端(Server)对接真实系统,把 MCP 请求翻译成目标系统的原生操作——比如把一次 MCP 读取请求转成 SQL 的 SELECT 查询,对接对象可以是 PostgreSQL 数据库、GitHub 仓库或 Slack 工作区。服务端既可以跑在用户本机(适合私有数据),也可以部署成远程云服务。连接建立后,服务端向客户端公布自己提供的资源、提示词和工具。
三大原语:Resources、Prompts 与 Tools
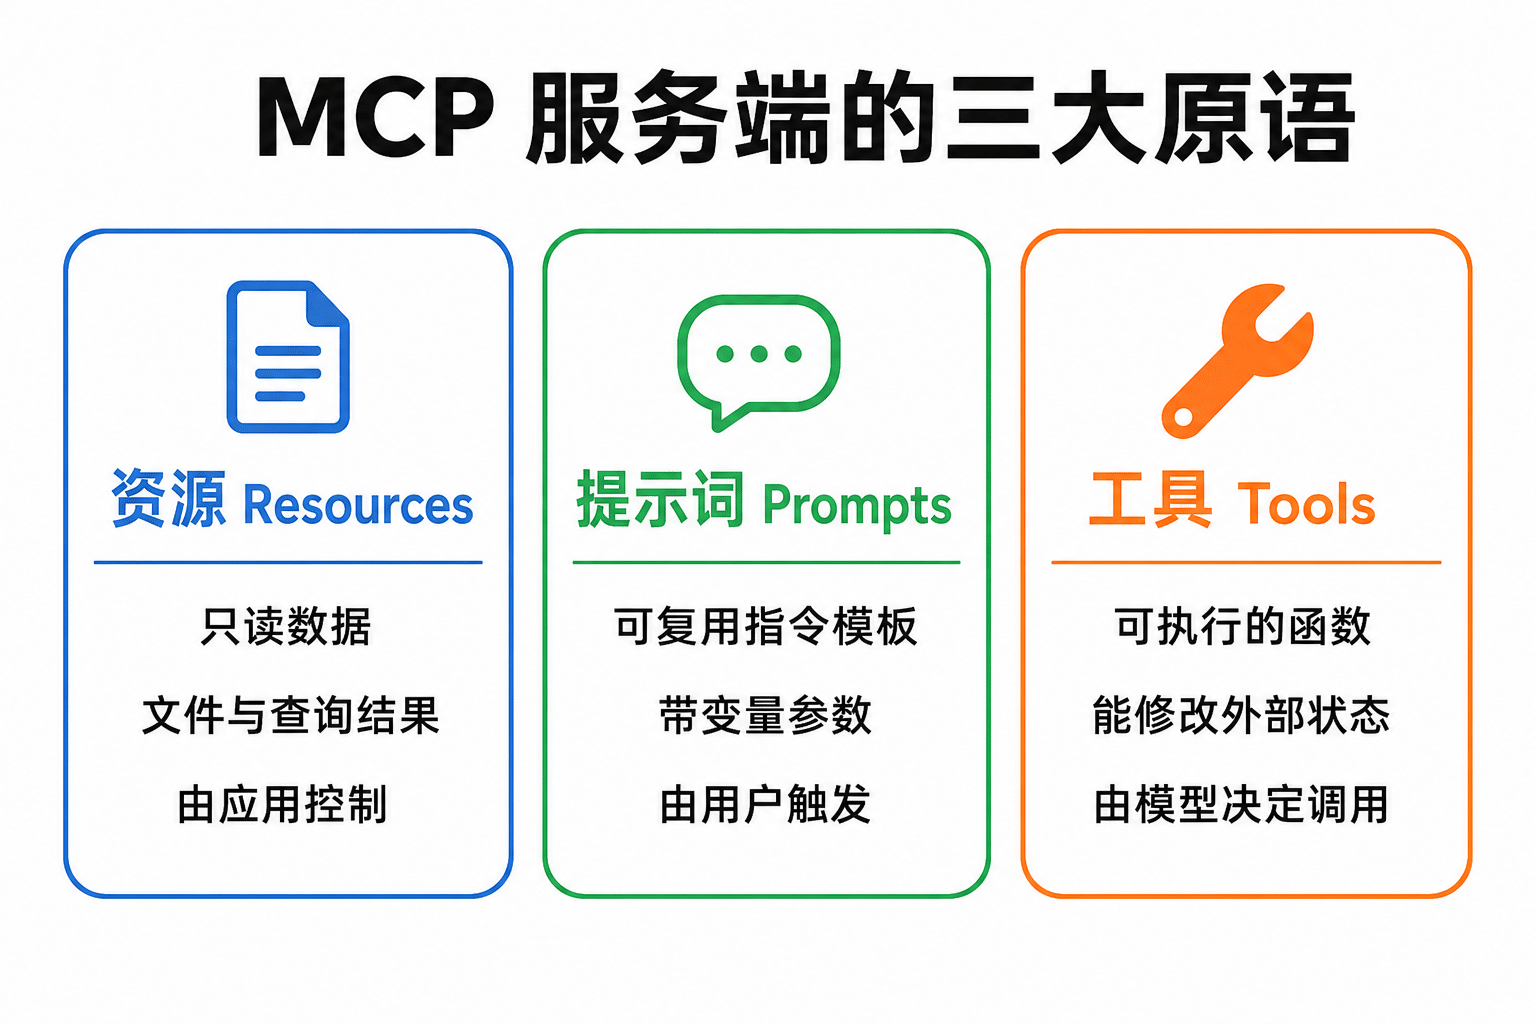
图:MCP 服务端向外暴露的三类能力
Resources(资源)是只读的上下文数据,由应用控制,模型能读不能改。典型形态包括数据库查询结果、文件系统里的文件、Web 服务的 API 响应、文档和知识库条目。
Prompts(提示词)是带变量的可复用指令模板,同一套模板可以在不同应用间共享、用不同参数调用。团队里验证有效的提示写法由此沉淀成标准件,常见的 AI 工作流也能规范化。
Tools(工具)的展开在原文付费部分,以下按 MCP 官方规范补全:工具是可执行的函数,与只读的 Resources 相对,可以产生副作用——写数据库、发消息、调用外部 API 都属于这一类。工具由模型自主决定何时调用,因此规范同时要求宿主在执行前取得用户授权,这是 MCP 安全模型里最关键的一环。
生态现状与国内落地
发布一年多后,MCP 已经从 Anthropic 的自家协议变成行业事实标准:2025 年 3 月 OpenAI 宣布其 Agents SDK 接入 MCP,谷歌随后跟进,主流 IDE 和智能体框架基本都内置了 MCP 客户端。协议规范与各语言 SDK 开源在 GitHub 的 modelcontextprotocol 组织下,能正常访问 GitHub 的网络环境即可获取,文档齐全,接入门槛不高。
国内生态跟进也快:魔搭社区(ModelScope)2025 年上线了 MCP 广场,收录了大量可直接调用的中文 MCP 服务;阿里云百炼等平台提供托管的 MCP 服务端能力,Qwen、GLM 等国产模型的智能体框架同样支持 MCP。协议本身在国内使用没有障碍,要评估的是具体 MCP 服务端背后的数据源能否稳定访问。
适用边界与三条落地判断
集成数量少而固定的场景收益有限。单个应用只接两三个自家数据源,直接用模型的函数调用(function calling)更省事;MCP 的价值要在多应用共享集成、或需要热插拔第三方工具时才能兑现。正在自建智能体的团队,可以先看架构层面的实践,比如AI Agent 搭建的十步演进路线,再决定在哪一步引入 MCP。
工具定义会占用上下文窗口。挂载的 MCP 服务端越多,每次请求携带的工具描述越长,成本和延迟同步上升,工具数量过多时模型选错工具的概率也会增加。按需挂载比一次全挂更稳妥。
第三方服务端要做安全审查。MCP 服务端能执行有副作用的操作,接入来路不明的服务端等于把执行权限交给陌生代码;恶意的工具描述还可能诱导模型执行计划外的操作,社区称之为”工具投毒”。生产环境优先选官方或可审计源码的服务端,并把每个服务端的权限范围收到最小。
© 版权声明
文章版权归作者所有,未经允许请勿转载。