System Design Newsletter 最近刊出一篇实战指南,作者 Fran Soto 是 Amazon 的软件工程师,负责过 Amazon 商城搜索结果页”加入购物车”等核心组件,现在在 Ring 工作。他以自己搭建的事故响应(incident response)Agent 为例,给出一条从纯手动操作到多 Agent 自动协作的十步演进路线。文章的价值在方法论本身:任何一个高频的人工流程,都可以照这个顺序逐步改造成替你干活的 Agent。本文把这条路线完整梳理一遍,并补充几点国内落地时需要知道的情况。
工作流、LLM、Agent 的区别
Fran 用组装家具打比方区分这三个概念。包装盒里那份固定的说明书是工作流(workflow):一条线性路径,只要一切顺利就能走到头,等价于脚本和传统程序;可一旦你装错了、掰断了一块木板,说明书帮不上忙,流程到此中断,没有任何恢复手段。
LLM(大语言模型)像一条客服热线。你描述断掉的部件,对方能给出专业又耐心的解释,甚至分析木板为什么会断——但挂了电话,你还是坐在地板上,对着那块断掉的木板,因为电话那头的人没有手。
最后能把家具装好的还是你自己:手里有锤子、钉子、胶水和电钻,脑子里能决定用哪件工具、怎么补救说明书里从没写过的意外。这个”工具加决策”的组合角色,就是 Agent。
不确定性与自愈能力
对 AI 的常见质疑是它不如传统代码可靠:同样的输入,代码每次给出同样的结果,AI 不一定。Fran 的看法是,对某些任务来说,这种不确定性恰恰是价值所在。人类的可靠性也比不过机器,但修机器的正是人——机器提供确定性带来的速度和精度,人负责应对预料之外的状况。Agent 模仿的就是人的这种适应能力:系统以一种你没预料到的方式挂掉时,它能翻日志、调整思路,具备一定的自愈能力。
要把这种能力用足,不能停留在开箱即用的通用助手上。AI 公司提供的通用 Agent 自带规划能力和内置工具,也开放了接入自有工具和记忆的接口,而机会正在后者:就像公司招聘的是软件工程师而不是”通用人类”,你需要的是针对自己业务定制的专家型 Agent。
十步演进路线
搭 Agent 不是拨一下开关就全部就位的事,而是一个迭代过程:把认知负担一部分一部分卸给机器,同时盯着它的表现。下面十步从纯手动开始,到多 Agent 协作结束。
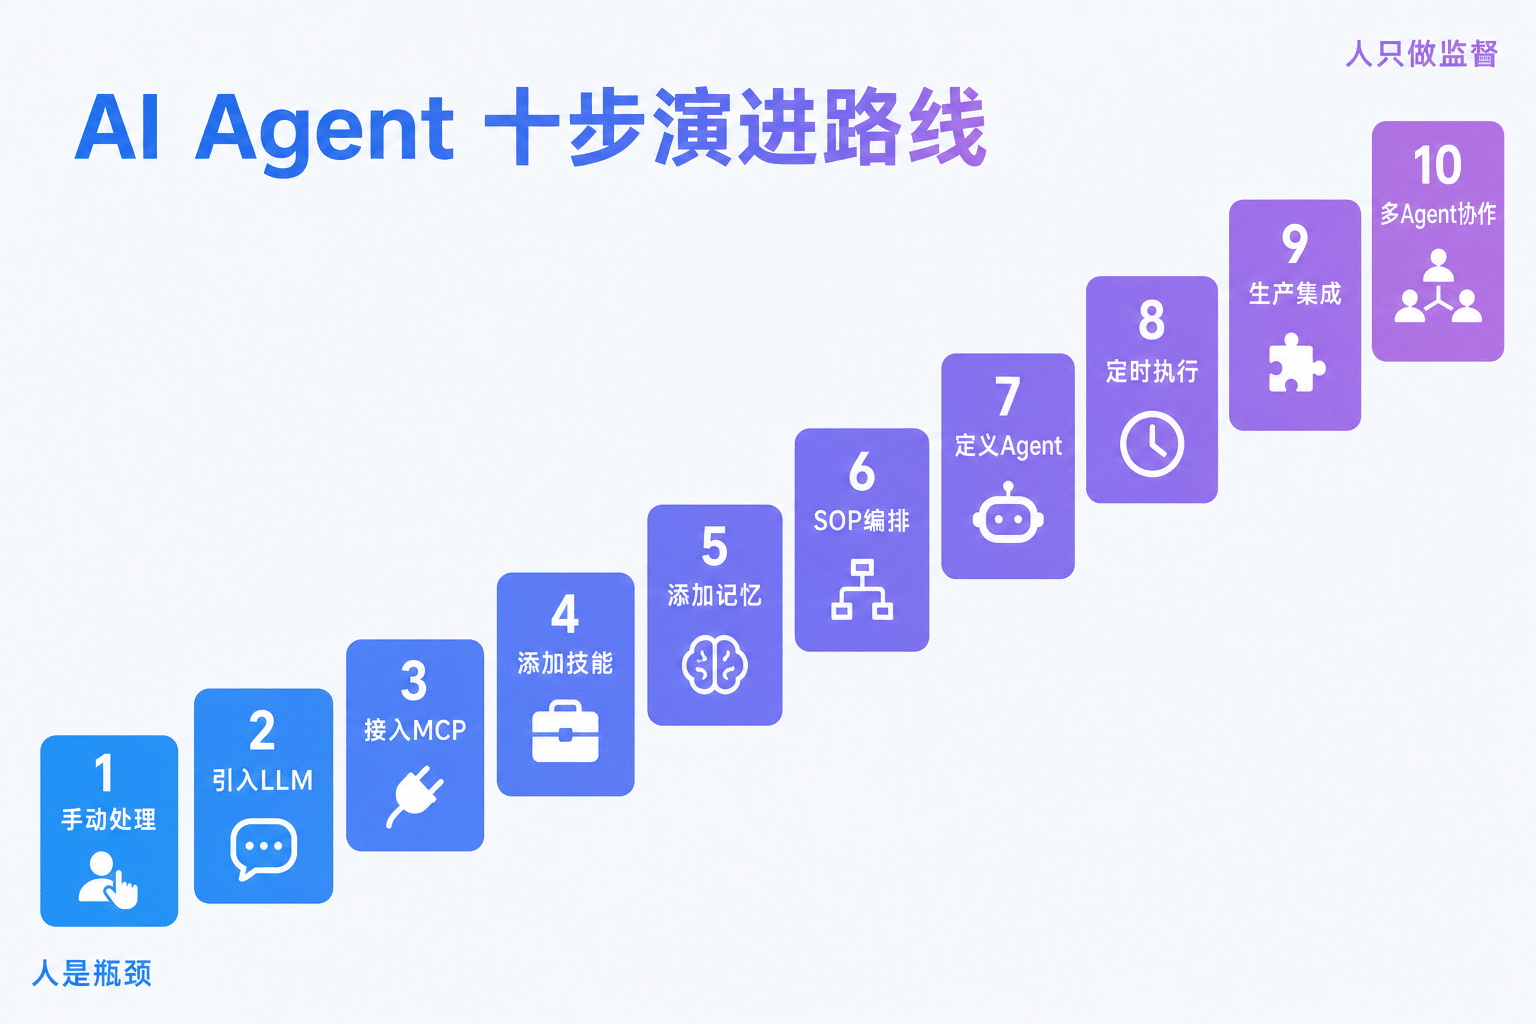
图:十步演进路线,起点”人是瓶颈”,终点”人只做监督”
第 1 步:先把活手动干一遍
起点永远是自己动手,并把步骤写成可以交接给别人的运维手册(runbook)。以事故响应为例:打开监控面板,找出偏离常态的指标;按该指标查手册里的排障说明;查最近 15 分钟的错误日志,筛出返回 HTTP 500 的请求。此时人是整个流程的瓶颈,每一步都依赖人工介入——这就是后面要改进的基线。实践中最常见的失败方式恰恰是跳过这一步直接上工具:没有手动基线,你判断不了 Agent 的输出是对是错,它出问题时也不知道往哪查。
第 2 步:引入 LLM 当分析助手
把手动流程当作提示词的蓝本,从终端复制日志、从面板复制指标,粘贴给模型分析:
Review these logs to find what error is happening: <copy-paste of logs>这个阶段的重点是做笔记:AI 在哪些地方不按你的意图来,你又是怎么把它带回正轨的。这些记录是第 4 步写技能文件的原料。现状是 AI 能分析数据了,但搬运数据、编排流程仍然全靠人。
第 3 步:接入 MCP 工具
复制粘贴是下一个要消灭的环节。MCP(Model Context Protocol,模型上下文协议)相当于 AI Agent 世界的 HTTP,是一套让模型直接操作外部系统的接口标准。接好 MCP 服务器、启用相应工具后,提示词可以直接这样写:
Obtain the alarms that fired in the last 15 minutes. You must give me only the alarm name.

Check the logs for requests ending with an HTTP 500 error. You must give me the message of the log, the error message, and the stack trace...
AI 从此自己去拿事故数据,人在一个对话界面里就能驱动全程,不用再切标签页。
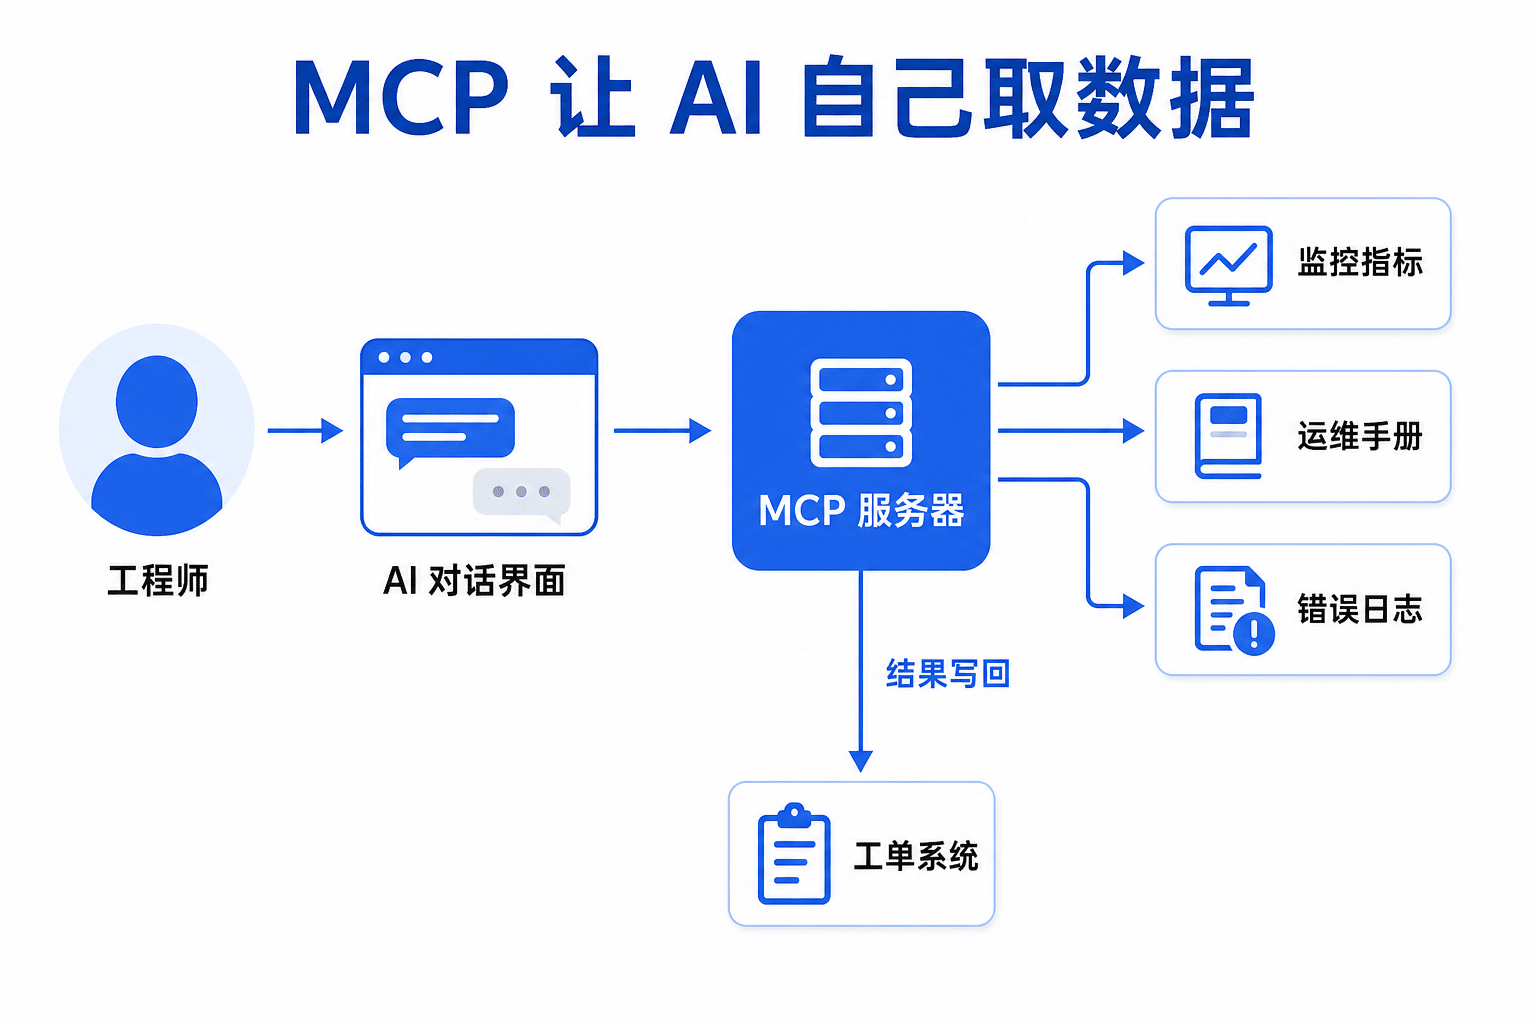
图:接入 MCP 后,AI 自行调取监控指标、运维手册与错误日志,并把结果写回工单
第 4 步:添加 Agent Skills
到这一步,操作者仍然得是事故响应专家。接下来要像带新入职的初级工程师一样给 AI 做入职培训:教它每件工具的准确用法,教它你希望活怎么干。载体是指南加标准作业程序——用自然语言写步骤,配上小脚本解决确定性问题。Fran 举的例子是”构建查询”这个技能:一份列出日志字段的 markdown 指南,加几个从模板生成查询的脚本。比起让 AI 每次现写复杂查询,这样做质量稳定得多,还能减少它幻觉出日志里不存在的字段。
这类可复用的逻辑单元就叫 Agent Skills。它有个关键设计:按需加载,只在被用到时才进入模型上下文。问的是报警,日志相关的技能就不占内存。用起来是这样(斜杠是 Cursor 等工具里强制加载某个技能的语法):
/Metrics-and-alarm-management Find the alarms fired
<LLM 返回指标信息>

/My-service-logs-management Find the logs with errors in these endpoints
<LLM 返回日志信息>

/Code-expert Where in code is this log emitted?
<LLM 返回代码信息>
现状:AI 学会了每类任务的做法,但先后顺序还是人在编排。
第 5 步:补上记忆
每次新开对话,Agent 就像失忆:知道怎么处理事故,却不记得昨天刚修过的那一起。短期记忆是内建的——当前会话的历史消息会随每次 API 调用一起发送,让它不用你反复重复;长期记忆则要靠文件。这方面行业已经有了统一标准 Agents.md:放在仓库里的这个文件会被各家 AI 统一读取,不挑模型。各家实现也都支持指定额外的目录和文件作为上下文。补上长期记忆后,AI 能查到过去出过什么错、当时哪个方案起了作用,不再重复踩同一个坑。
第 6 步:用 Agent SOP 做流程编排
工具、技能、记忆都有了,但每一步用什么、什么时候用,还是人在指挥,这成了新的瓶颈。解法是把整个流程写成 Agent SOP(Standard Operating Procedure,标准作业程序)——一份按 RFC 2119 规范书写的步骤文件,用 MUST、SHOULD、MAY 这些大写关键词标注每条要求的强制程度,步骤按顺序排列。Amazon 的 Kiro 和 Strands 两套 Agent 产品在用这个概念;Fran 自己在 Cursor 和 Claude Code 里也照用,做法就是把 SOP 写成一个 Agent Skill。之后的交互从逐步指挥变成一句委托:
/Incident-response-agent-sop Investigate the incident reported at JIRA-1234人只负责发起,Agent 接管余下所有环节,像一位高层管理者把合适的工程师拉进电话会。
第 7 步:把这一切定义成一个 Agent
MCP 工具、技能、SOP 多起来之后,配置管理会成为新负担:第一个 Agent 好办,几十个 Agent 各带一套工件时就难了。传统软件用依赖声明解决过同样的问题,现在轮到 Agent——把它依赖的全部工件声明进一个”Agent 定义”里,保证它在任何环境都带齐装备,不需要人工逐项配置。目前还没有成熟的 Agent 包管理器,按这个生态的演进速度,出现只是时间问题。到这一步,整个事故调查可以整体委托,人只等结果。
第 8 步:让它定时跑起来
Agent 已经完全知道该干什么,只是还等着人去按启动键。凌晨三点被叫醒,就为了发一句指令然后等结果,这没有道理。Fran 推荐用 CLI 工具让 Agent 独立运行,起步方案是一个简单的轮询脚本:发现有活就调 Agent,没活就睡几分钟再看。逻辑大致是:
# 示意写法,判断条件和间隔按自己的告警系统调整
while true; do
  if 有新告警; then 调用 Agent 处理; fi
  sleep 300
done
从此触发环节不再需要人。值班工程师看到告警时,旁边已经放着 Agent 的调查结果。
第 9 步:接入生产环境
本机的循环脚本只是过渡形态,目标是一条端到端的自动链路:PagerDuty 的 webhook 直接触发跑在 Lambda 里的 Agent;周期性报告交给 cron 定时任务。Agent 完成调查后,把根因摘要或例行报告发进 Slack 频道——它在你睡觉时也在干活,哪怕只擅长这一件事。国内团队搭同样的闭环,常见组合是 Prometheus 加 Alertmanager 做告警触发、企业微信或飞书机器人做结果通知,链路结构完全一致。
第 10 步:扩展成多 Agent 协作
系统规模上来后,单个 Agent 会像单个工程师一样过载——没人会让一个工程师维护所有微服务。终点形态是多个 Agent 协作处理同一起事故,按专长分工:一个收集原始日志,一个排查已知的基础设施问题,一个复查最近的代码部署有没有引入错误。编排范式有顺序执行、路由分发、集群(swarm)等多种;同一职能内部也能继续细分,事故响应 Agent 管的细节太多,就按系统模块再拆。
管理这支 AI 队伍需要一层抽象:多个专家 Agent,加一个负责调度的管理者(orchestrator)。协作机制不必一上来就上复杂的 Agent 间通信协议,Fran 的建议朴素得多:编排者由事件、排期或轮询触发;它调用你定义好的各个子 Agent(主流 AI 工具都已支持子 Agent);所有 Agent 都往文件系统里写结果,彼此就能看到对方的工作。在自己电脑上跑、靠共享文件协作,足够起步。至此,多步骤的复杂工作不再需要人介入,人不再是瓶颈。
来自一线的六条经验
Fran 另外给了六条踩坑换来的建议:
- 样本要攒够。低频任务不值得自动化,迭代需要足够多的实例。他的做法是主动向团队申请,接下某个服务一整个月的全部工单。
- 每一步多迭代几轮。解决过多个真实工单、摸清真实的模式和失败方式之前,不进入下一步。
- AI 干活时别切走。盯着它实时操作才能当场抓住错误,而不是放后台跑完再看。
- 用 tmux 保持会话。终端连接断了,跑在 tmux 里的 Agent 循环不受影响。
- 日志全量记录。把 Agent 的所有输出导进专门的日志文件,7×24 运行时的可观测性全靠它。
- 按观察结果持续改提示词。十步走完不等于结束,新的边界情况会不断出现。要么自己更新,要么让 AI 在迭代之间自行更新记忆文件。
这六条里前两条分量最重,它们实际划定了这套路线的适用边界:高频、步骤能写成文档、以只读诊断为主的任务,收益最大;一个月碰不上几次的活,写技能文件和调试的成本收不回来,留给人做更划算。
人的介入点设计
这套方案不是在全人工和全 AI 之间二选一。文中的事故响应例子刻意停留在只读操作——查报警、查指标、查日志,实际改动系统的环节留给人。介入点可以按需设计:让 Agent 完成分诊并给出修复建议,由人审批执行;更进一步,让 AI 直接在代码库里提 PR,人审核后再部署热修复。
但生产变更这条线不该让 AI 无人监督地跨过去。已经有事后复盘写明,AI 在没有任何人工审核的情况下,在 AWS 账号里执行了未经授权的生产操作。Fran 的原则是”把人尽量往右推”:流程里人的动作越少越好,但监督位置必须保住。原因很直白——出了事,被追责的永远是人,没人会去找 AI 要说法。
七个组成模块
全文的框架可以收拢成七个模块:
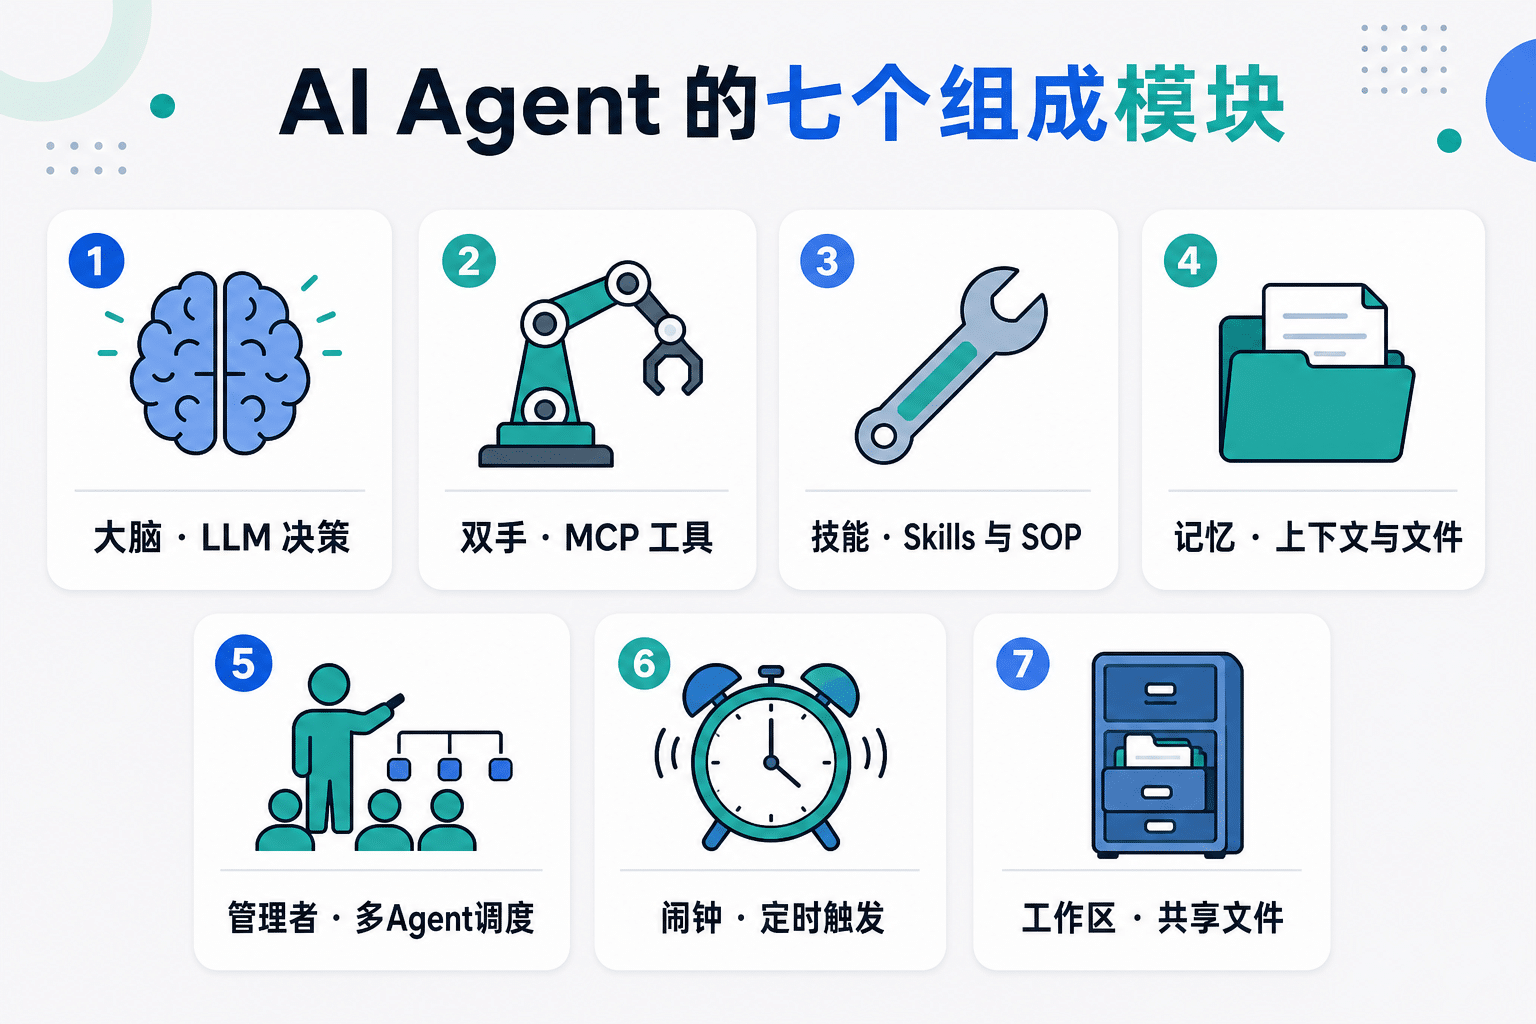
图:AI Agent 的七个组成模块
- 大脑(LLM):处理信息、做决策、确定下一步动作;
- 双手(工具与 MCP):与真实世界交互的接口,执行代码、查数据库、拉日志,而不是只会回话;
- 技能(Skills 与 SOP):教模型按你的方式干活,像初级工程师照手册操作,同时压低出错率和幻觉;
- 记忆(上下文与 Agents.md):短期记住当前对话,长期通过共享文件记住历史,避免重复犯错;
- 管理者(编排器):规模化之后调度多个专家 Agent 协作,一个找错误、一个提修复,合力产出最终结果;
- 闹钟(cron 定时任务):让 Agent 按计划自动运行,不需要人启动;
- 工作区(本地文件系统):所有 Agent 共同读写的场地,复杂问题的协作靠它完成。
国内落地的几点说明
MCP 是开放协议,不绑定任何一家模型厂商,Qwen、GLM、Kimi 等国产模型的工具链均已支持,这套框架在国产模型上同样成立。Agents.md 只是一份放在代码仓库里的 markdown 约定,不依赖特定产品。工具层面,文中提到的 Cursor 和 Claude Code 属于付费订阅产品,在大陆使用需要相应的网络环境;Strands 是开源框架,代码托管在 GitHub 上,可以直接取用。对已经在用 Claude Code 或 Cursor 的读者,这套路线基本可以原样照搬;用国产模型 CLI 的读者,把 MCP 服务器和技能文件对接到自己的工具链即可,思路不变。
站内此前两篇同主题文章与本篇互为补充:AI Agent 是什么?零代码用 Claude Code 搭一个 Telegram 智能助手适合从零理解 Agent 的读者;AI Agent 团队怎么搭?从单个智能体到生产级协作的 9 个阶段与本篇的第 10 步正好衔接。
结语
“AI 不会取代你,会用 AI 的人才会”——这句话流传很广,而这篇文章给出了”会用 AI”的具体定义:不是往 IDE 里装个插件,也不是被 AI 第一次没做对就断定它不行,而是照着一条清晰的路线,把自己的工作流程一步步改造成一支替你干活的 Agent 队伍。通用工具各家都在发,把它们调教成贴合自己业务的专家,才是拉开差距的地方。
© 版权声明
文章版权归作者所有,未经允许请勿转载。