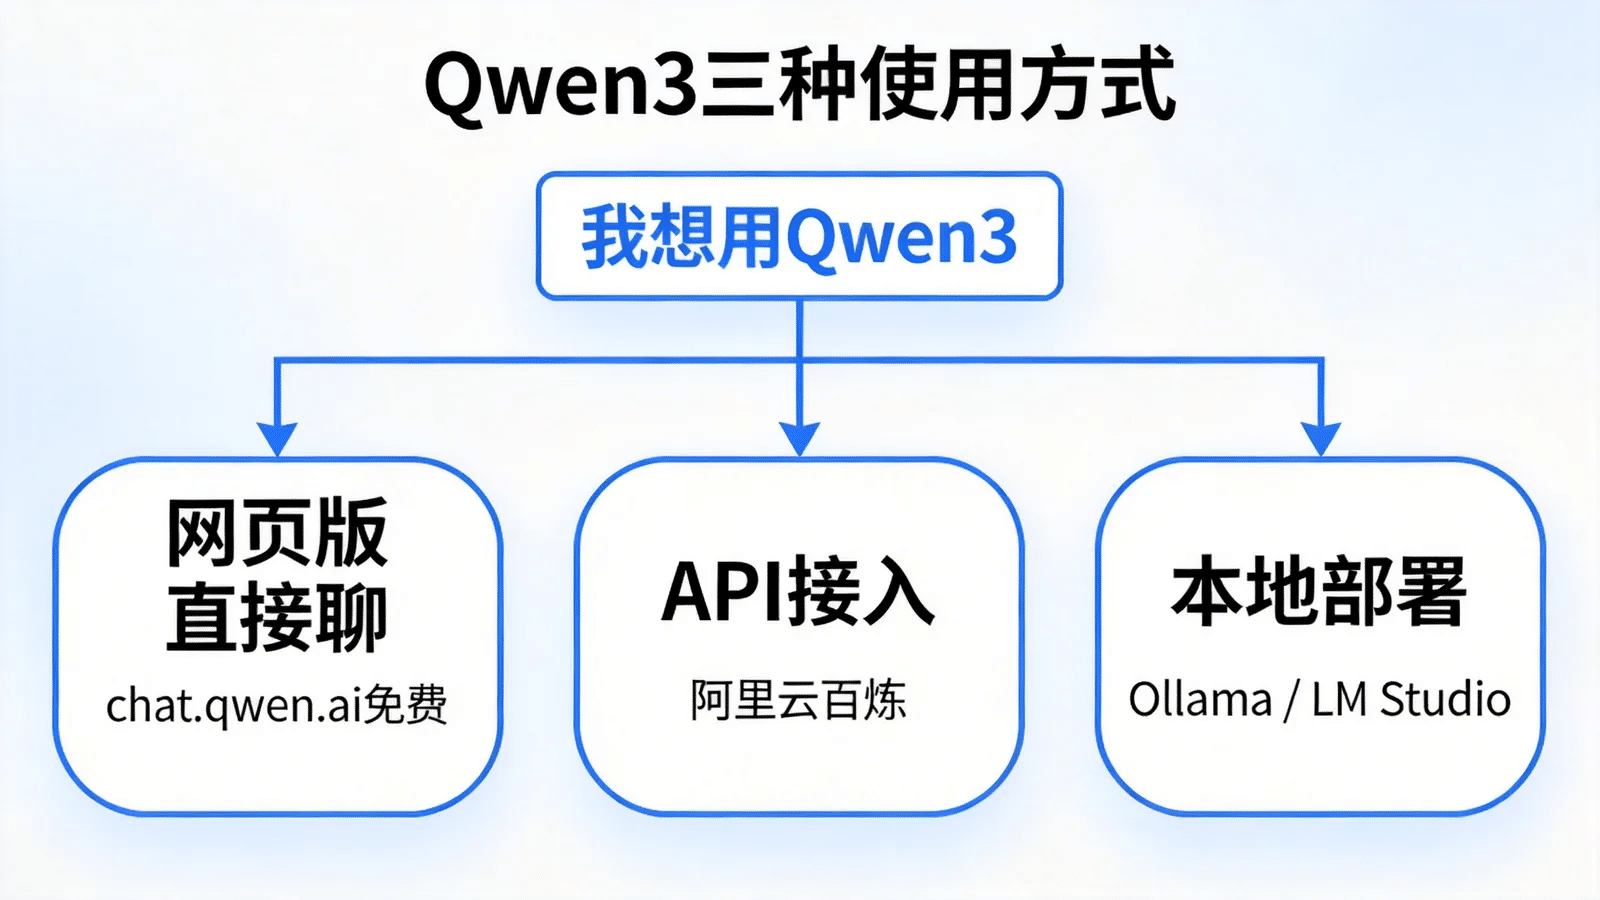
Qwen3(通义千问 3)是阿里巴巴通义团队开发的开源大模型系列,2025 年 4 月底首发。它能做的事和 ChatGPT、DeepSeek 属于同一类:聊天问答、写文章、写代码、做数学推理,还支持 100 多种语言和方言。与闭源产品最大的差别在于开放程度——全系列模型权重公开,采用 Apache 2.0 许可证,任何人都可以免费下载、修改、商用。对普通用户来说,用它不需要任何技术基础:打开官方对话站 Qwen Chat(chat.qwen.ai)就能直接开聊,国内可以正常访问,免费。
如果需求只是找一个免费的 AI 助手,网页版足以满足。这篇文章面向想再深入一步的读者:Qwen3 家族十几个型号分别是什么,名字里的 235B、30B-A3B 该怎么读,以及通过 API 或本地部署使用时的具体操作。文中的版本号和参数均核对自 Qwen3 官方 GitHub 仓库与官方文档。
型号命名怎么读:两种架构与思考模式
Qwen3 首发提供 8 个尺寸,分稠密(Dense)和混合专家(MoE,Mixture of Experts)两种架构。稠密模型有 0.6B、1.7B、4B、8B、14B、32B 六档,B 代表十亿参数,数字越大能力越强,对硬件的要求也越高。MoE 型号有两个:Qwen3-30B-A3B 和 Qwen3-235B-A22B,横线前是总参数量,A 后面是每次推理实际激活的参数量。以 30B-A3B 为例,模型总共 300 亿参数,但每生成一个词只调用其中约 30 亿,运行速度接近小模型,能力却向大模型看齐,这也是它成为本地部署热门型号的原因。
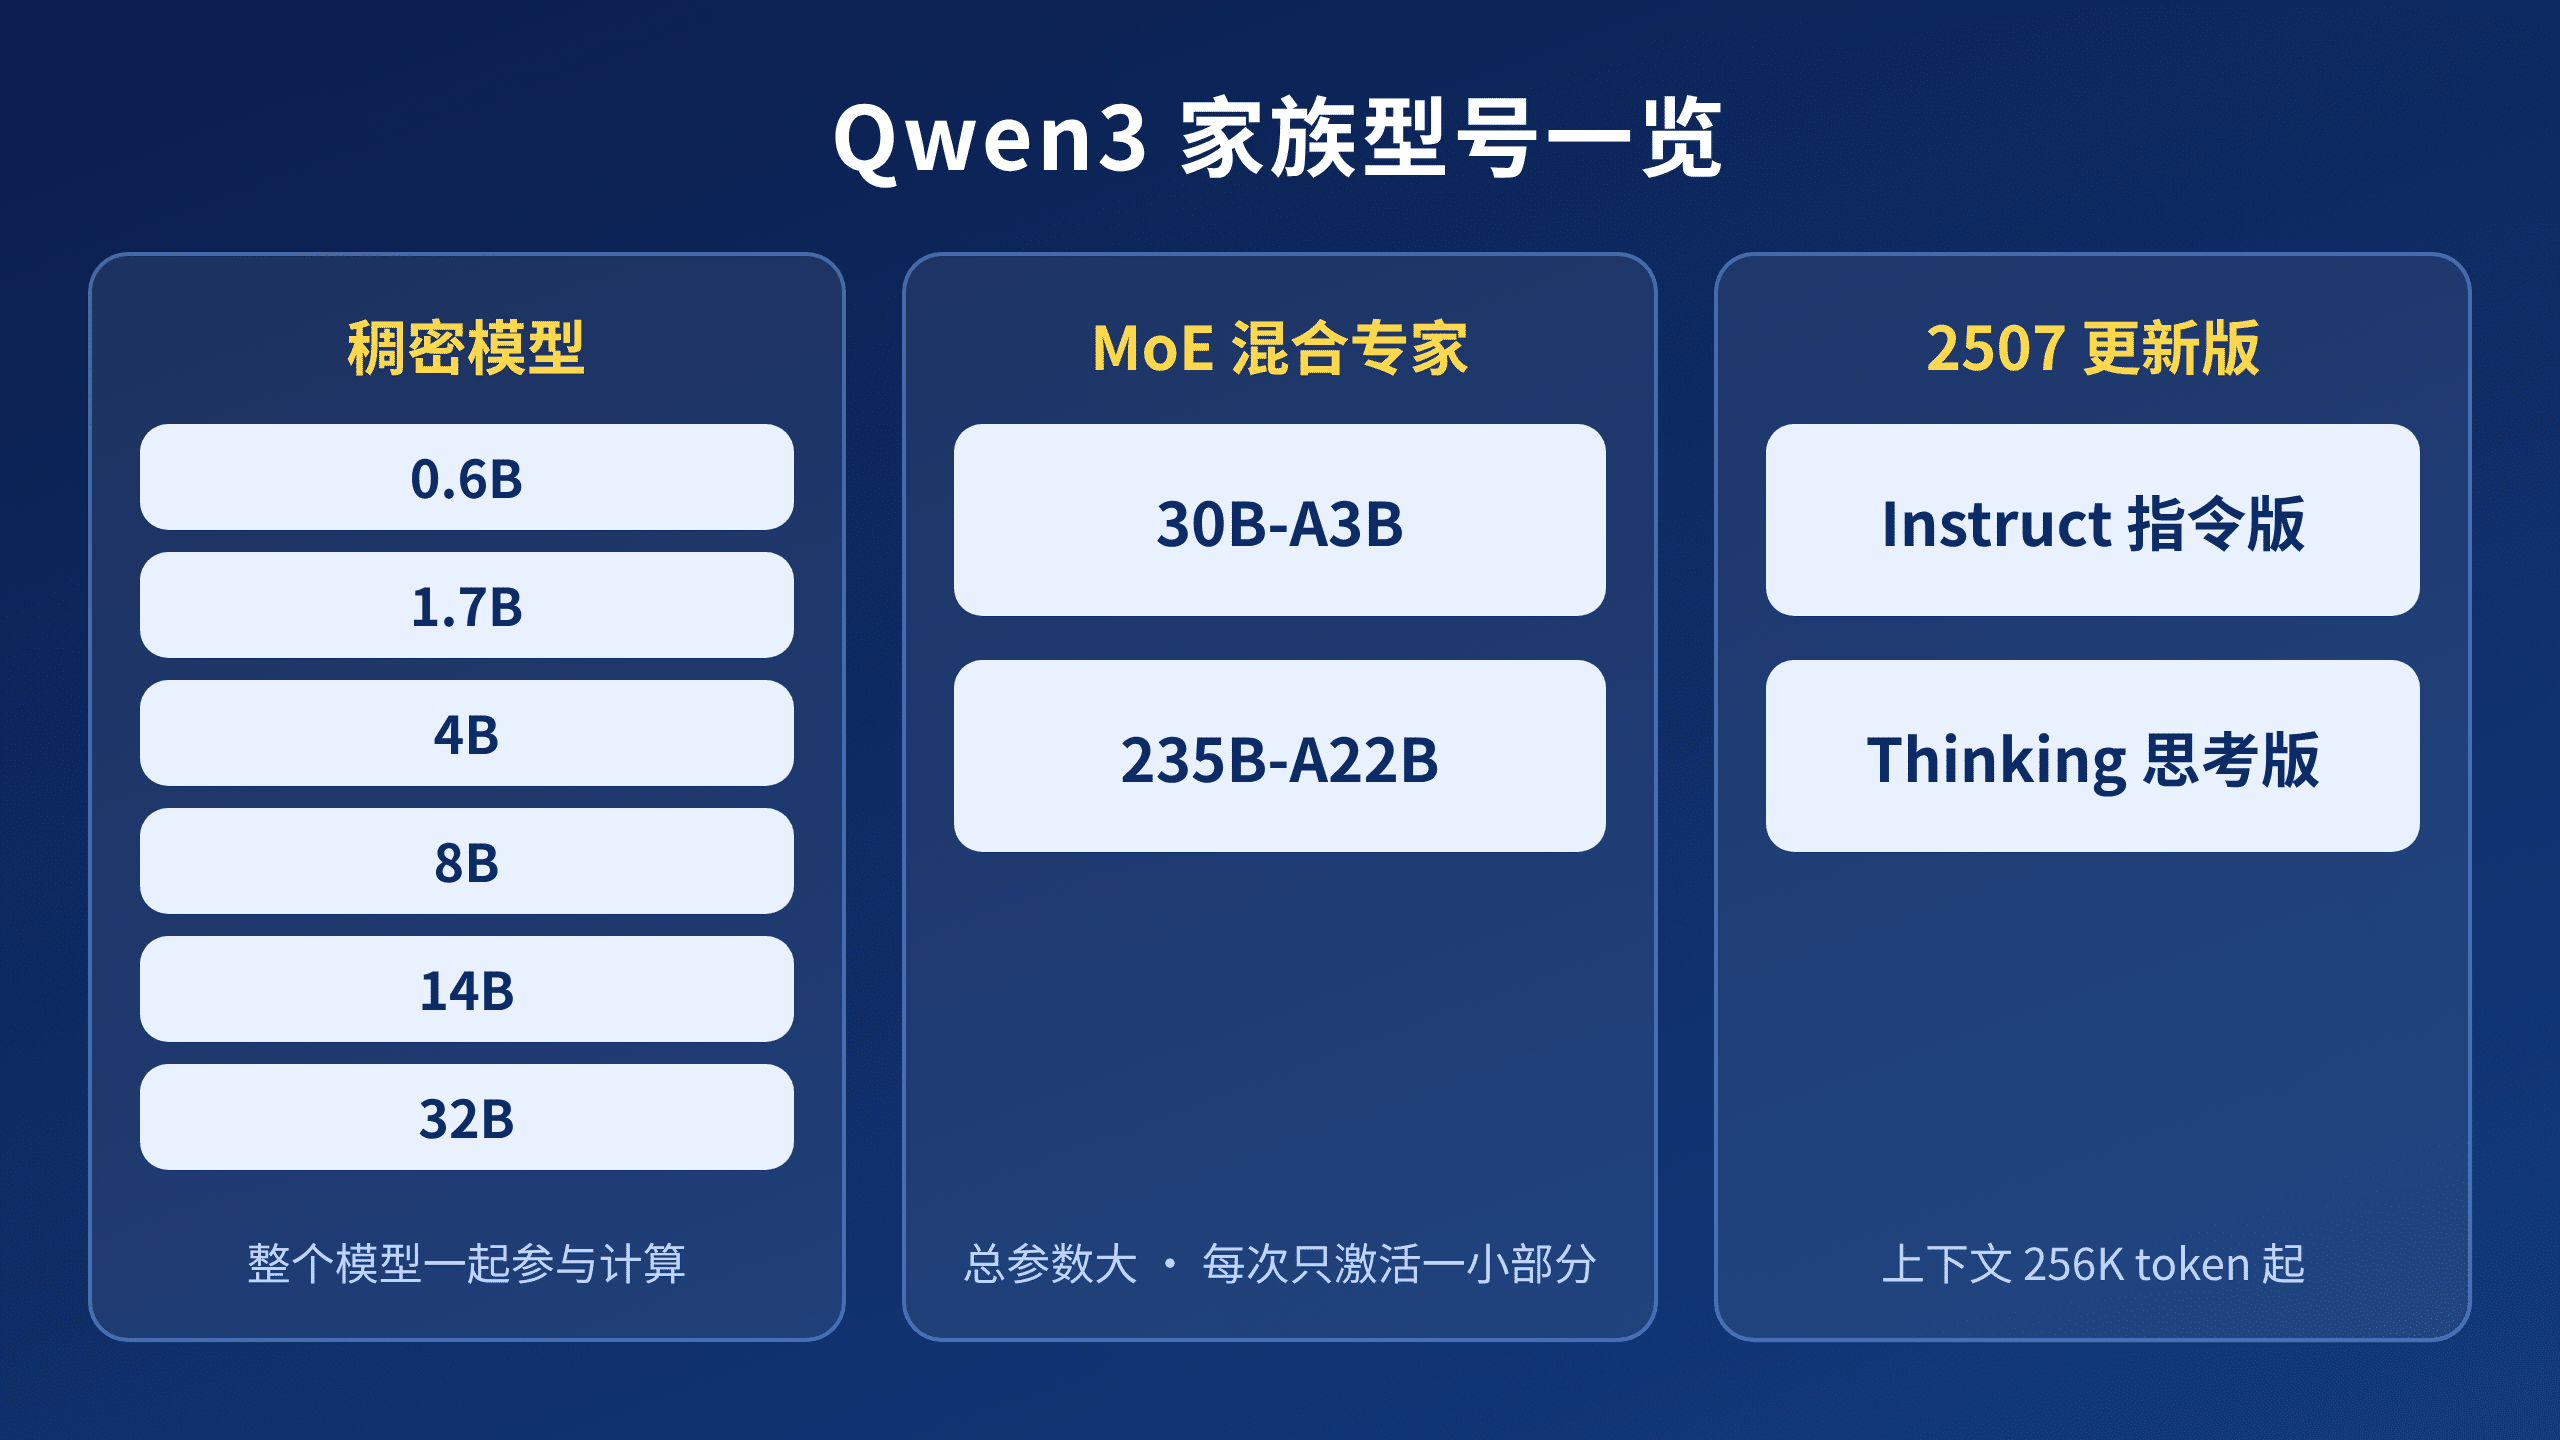
思考模式是 Qwen3 的另一个特色。首发版在一个模型里内置两种工作方式:思考模式先推理再回答,适合数学、代码和复杂逻辑;非思考模式直接回答,响应更快,在对话中输入 /think 或 /no_think 即可切换。2025 年 7 月起官方调整了产品线,推出更新版 Qwen3-2507,把两种模式拆成两个独立系列:Instruct(不思考,面向日常任务)和 Thinking(专注深度推理),各有 235B-A22B、30B-A3B、4B 三个尺寸,上下文长度 256K token,最高可扩展到 100 万 token,相当于一次塞给模型几本长篇小说。
怎么选:三类需求对应的型号
- 日常使用:不用纠结型号,直接上网页版,官方默认配置的就是当前主推版本。
- 本地部署:16GB 内存的普通笔记本从 4B 或 8B 起步,量化后的模型文件只有几个 GB;配备 32GB 以上内存的 Mac 或大显存显卡,可以上 30B-A3B——按 4bit 量化粗算,权重文件在 20GB 上下,MoE 架构让它跑起来比同级稠密模型快得多。
- 企业级部署:235B-A22B 面向多卡服务器集群,个人设备跑不动,不必考虑。
和同为国产开源路线的 DeepSeek 对比一句:DeepSeek 的 V3、R1 只提供 671B 规格的旗舰款,个人本地部署基本不现实;Qwen3 的差异化在于 0.6B 到 235B 全尺寸覆盖,想在笔记本甚至手机上跑开源模型,现阶段它的选择面最宽。
用法一:网页版,零门槛
chat.qwen.ai 是官方对话站,国内直接打开即用,可以选用 Qwen3 系列的不同型号。不确定要不要折腾部署的用户,从这里开始是最合理的路径。
用法二:API 接入,OpenAI 兼容
做应用开发又不想自己架服务器,可以走阿里云的模型服务平台百炼(海外版叫 Alibaba Cloud Model Studio),Qwen3 系列均已上架,按 token 用量计费,具体价格以阿里云官网为准,国内开通没有网络障碍。接口兼容 OpenAI 格式,已有的 GPT 应用代码通常改一下 base_url 和模型名就能切换过来。
自建推理服务的团队可以用 vLLM(官方建议 0.9.0 以上)或 SGLang 启动一个 OpenAI 兼容服务,以 8B 型号为例:
vllm serve Qwen/Qwen3-8B --port 8000 --max-model-len 131072 --enable-reasoning --reasoning-parser qwen3启动后 API 地址是 http://localhost:8000/v1。
用法三:本地部署,Ollama 最省事
本地部署适合在意数据隐私、或者想离线使用的场景。最简单的方案是 Ollama:到 ollama.com 下载安装(官方建议 v0.9.0 以上),然后两条命令:
ollama serve
ollama run qwen3:8b
模型下载完成后就能在终端对话,想换尺寸改后缀即可,比如 qwen3:4b、qwen3:30b-a3b。偏好图形界面可以用 LM Studio,直接加载官方 GGUF 文件;Apple Silicon 的 Mac 另有 mlx-lm 方案(0.24.0 以上);喜欢轻量命令行的用 llama.cpp(建议 b5401 以上版本)。
本地部署的三个常见坑
这三条都写在官方文档里,但容易被忽略。
一、Ollama 默认上下文只有 2048 token。这个默认值对 Qwen3 明显偏小,长回答容易出问题,官方明确建议手动调大。进入对话后输入:
/set parameter num_ctx 40960
/set parameter num_predict 32768
二、Ollama 的标签和官方命名对不上。比如 qwen3:30b-a3b 这个标签,按官方 README 的记载(2025 年 8 月),指向的是 2507 思考版的 4bit 量化模型,并非首发版。下载前先到 ollama.com/library/qwen3/tags 页面核对清楚。
三、Hugging Face 在大陆无法直接访问。模型文件优先从魔搭 ModelScope 下载,这也是官方对大陆用户的明确建议。命令行工具用 modelscope download;vLLM 和 SGLang 分别设置环境变量 VLLM_USE_MODELSCOPE=true、SGLANG_USE_MODELSCOPE=true,就会自动改从魔搭拉取模型。
许可证与配套生态
Apache 2.0 属于商业上最宽松的一类开源许可证:可以商用、可以修改、可以基于它开发自己的产品,只需保留版权声明,也不要求开源衍生作品。对想把大模型接进自家业务的中小团队,这一条比性能参数更重要。
配套生态方面,微调可以用 LLaMA-Factory、Unsloth 等框架;做工具调用和智能体开发,官方推荐自家的 Qwen-Agent 框架,支持 MCP 协议。Qwen3 的参数规格与资料入口汇总在站内 Qwen3 模型页。部署好模型后想搭建知识库或智能体应用,站内的 RAG 原理拆解和 Agent 设计模式解析可以接着读;想补大模型背后的系统知识,参考机器学习系统设计入门。
© 版权声明
文章版权归作者所有,未经允许请勿转载。