DeepSeek V3 是杭州深度求索(DeepSeek)在 2024 年 12 月发布的开源大语言模型,写文章、翻译、写代码、解数学题都能处理,也可以当成日常问答助手来用。它当年凭”性能追平闭源旗舰、训练花费只有对方零头”的反差走红,后来大名鼎鼎的推理模型 DeepSeek R1 也是在它的基础上训练出来的。普通人不需要懂任何技术:打开官方网页或手机 App,注册后就能免费对话;开发者则可以调用 API,或者下载完整的模型权重自己部署。
本文依据 DeepSeek-V3 官方 GitHub 仓库(超过 10.4 万星标)和官方技术报告整理,回答三个问题:这个模型强在哪,放到 2026 年它处于什么位置,想用它有哪几条路。模型的参数规格和跑分数据可以直接看站内的 DeepSeek V3 模型页。
模型是什么:6710 亿参数,每次只动用 370 亿
V3 的总参数量是 6710 亿(671B),但它采用了混合专家架构(Mixture-of-Experts,简称 MoE):模型内部由大量”专家”子网络组成,处理每个字词时只挑选其中一小部分参与计算,实际激活的参数量是 370 亿(37B)。可以把它理解成一家有 671 名员工的公司,每接一单只派最合适的 37 个人上场——账面规模很大,日常开销却接近一个中型模型。这套设计让 V3 在保持大模型能力的同时,把推理成本压得比同规模稠密模型低得多。
其他几项关键规格:上下文窗口 128K token,一次能装下十几万字的资料;预训练数据量 14.8 万亿 token;注意力机制用的是自研的 MLA(Multi-head Latent Attention,多头潜在注意力),这套 MLA 加 MoE 的组合在上一代 V2 上已经验证过。训练时还引入了多 token 预测目标(MTP),既提升了模型效果,也能用于推理加速。
最出圈的数字是训练成本。官方技术报告披露,V3 完整训练只用了 278.8 万 H800 GPU 时,按每卡时 2 美元的租用价估算约 557.6 万美元,按当时汇率折合人民币 4000 万元上下——而同级别闭源模型的训练投入普遍以亿美元计。这背后是 FP8 混合精度训练框架的功劳:V3 第一次在这种超大规模的模型上验证了 FP8 训练可行,配合算法、框架、硬件的协同设计绕开了跨节点通信瓶颈。官方还提到,整个训练过程没有出现过无法恢复的损失异常,也没有回滚过一次。
能力水平:数学、代码、中文是长板
按官方公布的评测结果,V3 发布时是成绩最好的开源模型,多项指标追平甚至超过当时的 GPT-4o 和 Claude 3.5 Sonnet。几个有代表性的数字:数学测试 MATH-500 得分 90.2(GPT-4o 为 74.6),竞赛数学 AIME 2024 得分 39.2,编程竞赛 Codeforces 百分位 51.6,都大幅领先当时的对手;中文评测 C-Eval 得分 86.5,中文事实问答 C-SimpleQA 得分 64.8,同样超过 GPT-4o。
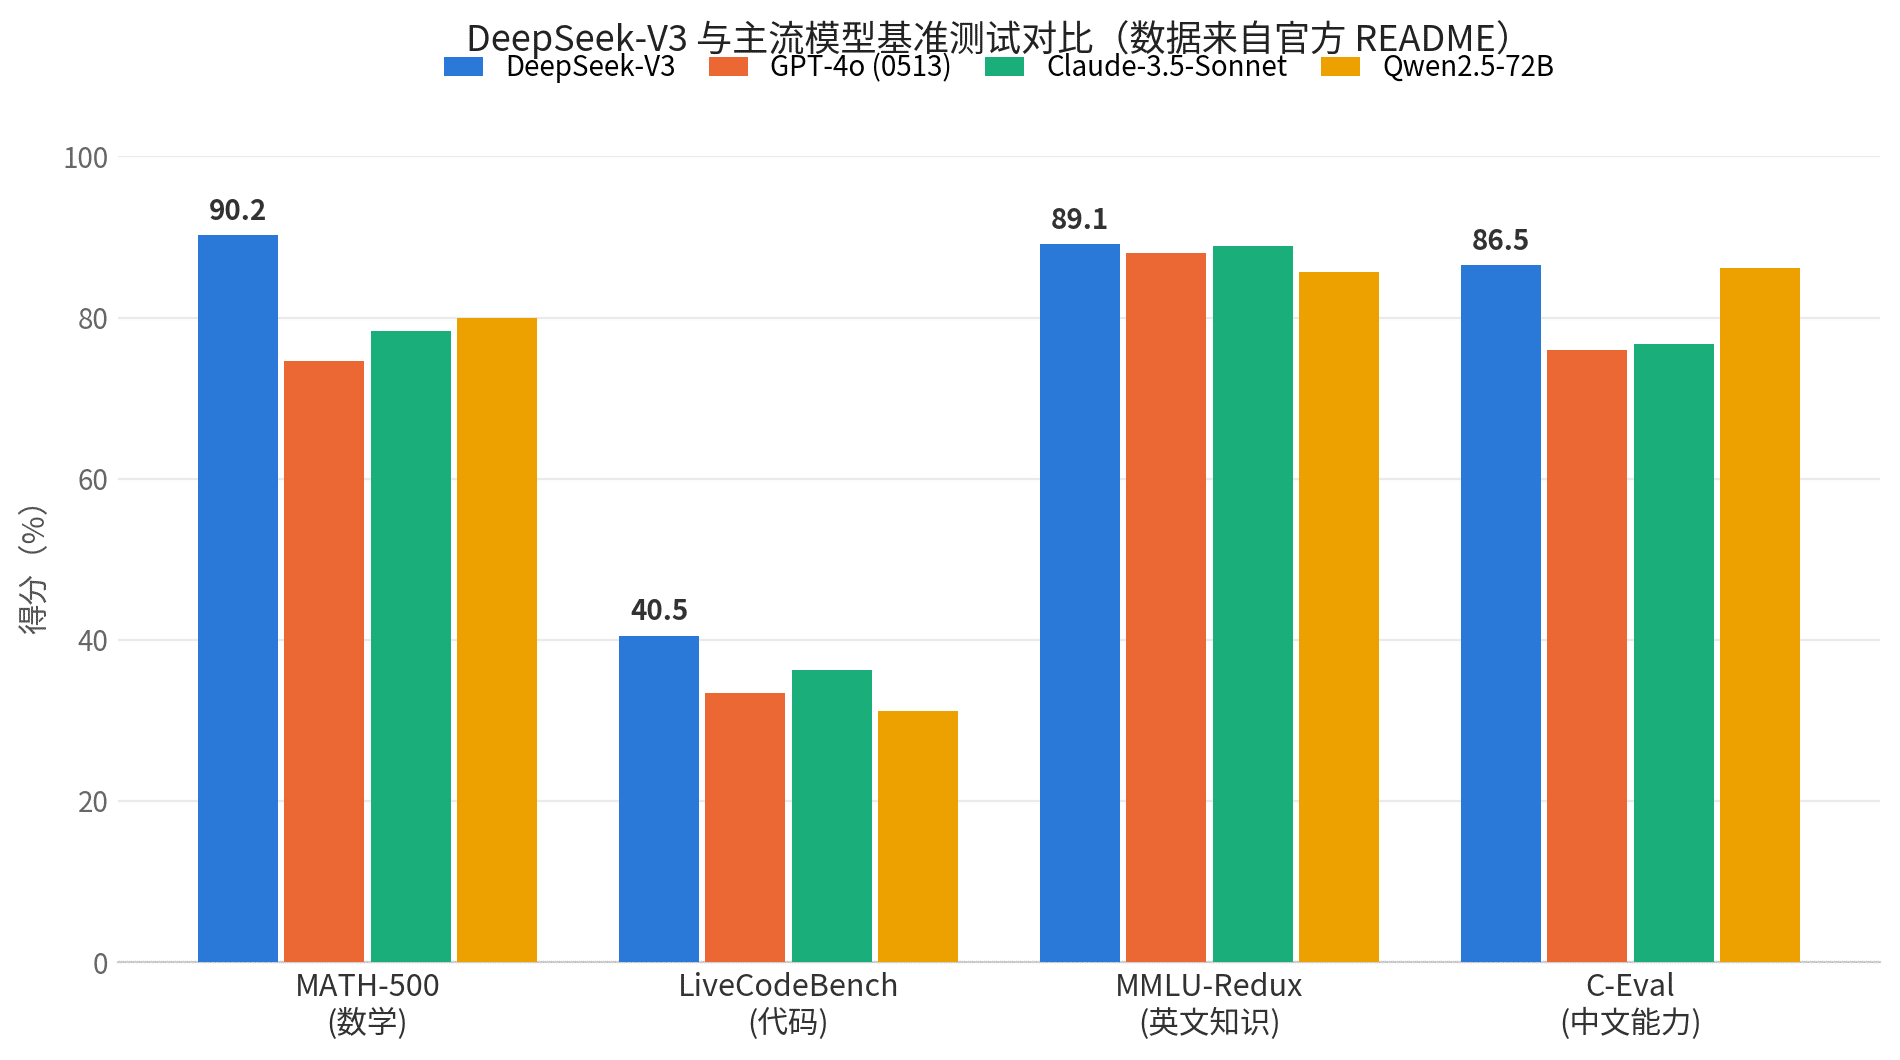
图:DeepSeek-V3 与主流模型基准测试对比,数据来自官方 README
短板也要说清楚。英文事实问答 SimpleQA 只有 24.9,明显低于 GPT-4o 的 38.2,拿它查英文世界的具体事实,答错的概率不小,重要信息需要复核;博士级科学问答 GPQA-Diamond 得分 59.1、软件工程测试 SWE-bench Verified 得分 42.0,均落后于 Claude 3.5 Sonnet。这些数字如今已被新一代模型(包括 DeepSeek 自家的后续版本)超过,但作为理解当前开源模型格局的起点,V3 的成绩单仍有参考价值。
普通人怎么用:三条路径
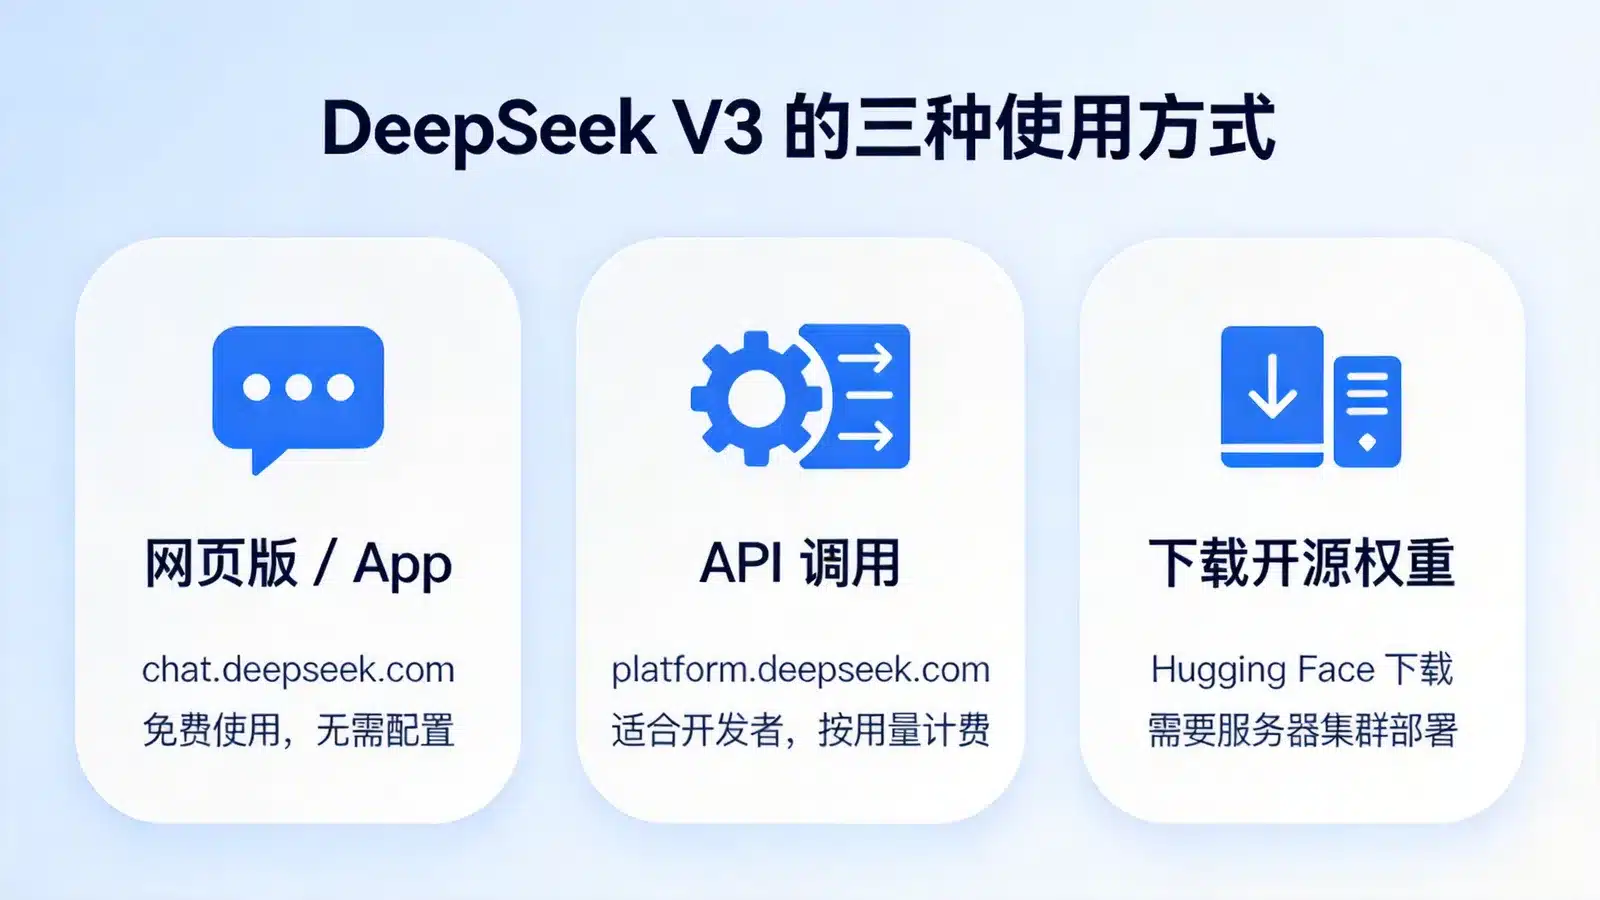
图:DeepSeek V3 的三条使用路径
路径一:官方网页和 App。访问 chat.deepseek.com 或下载 DeepSeek 手机应用,注册后免费使用,国内网络直接访问,没有任何门槛。需要说明的是,官方线上服务一直跟着版本走,现在网页版背后运行的已经不是 2024 年的 V3 本体,而是更新的后续模型——对只想”用上 DeepSeek”的普通用户来说这反而是好事,打开就是当前最好的版本。站内的 DeepSeek 工具页收录了官方入口。
路径二:API 调用。开发者在 platform.deepseek.com 申请密钥后,用 OpenAI 或 Anthropic 兼容格式接入,按用量计费。按官方 API 文档的现行说明,主线模型已更新为 deepseek-v4-flash 和 deepseek-v4-pro,V3 已从官方 API 退役;想调用 V3 本体的话,可以找托管开源权重的第三方推理平台,具体型号以各平台现行模型列表为准。
路径三:下载开源权重。完整权重在 Hugging Face 上开放下载,分 DeepSeek-V3-Base(基座版)和 DeepSeek-V3(对话版)两个模型,文件总规模 685B 参数,其中 671B 是主模型、14B 是 MTP 模块。Hugging Face 在国内访问不稳定,可以改用 hf-mirror.com 镜像站下载。
三条路怎么选:普通用户走网页版足够;需要批量处理文本、做应用集成的开发者走 API 最省事;下载权重自己部署只适合有服务器集群的团队,原因见下一节。
本地部署的现实门槛
V3 只有 671B 一个尺寸,没有官方小杯版本。Ollama 虽然收录了 deepseek-v3,但模型文件 404GB,个人电脑连权重都装不下;官方演示的推理配置是两台 8 卡服务器节点。这一点和阿里 Qwen3 从 0.6B 到 235B 全尺寸开源的做法完全不同——想在自己笔记本上跑开源模型的读者,可以看站内的 Qwen3 入门指南,那个系列有能在消费级设备上运行的小尺寸型号。
对有硬件条件的团队,官方 README 列出了八条部署途径:
- SGLang:官方重点推荐,完整支持 BF16 和 FP8 推理,NVIDIA 和 AMD 显卡都能跑,还支持多机张量并行;
- LMDeploy:支持 FP8 和 BF16,提供离线批处理和在线服务两种模式,与 PyTorch 工作流衔接顺畅;
- vLLM:支持 FP8 和 BF16,可做张量并行和流水线并行;
- TensorRT-LLM:支持 BF16 推理和 INT4/8 量化,FP8 支持当时尚在开发中;
- LightLLM:支持 FP8 和 BF16 的单机或多机部署;
- DeepSeek-Infer:官方自带的轻量演示程序,仅限 Linux 加 Python 3.10 环境,Mac 和 Windows 不支持;
- AMD GPU:经 SGLang 支持 BF16 和 FP8 两种模式;
- 华为昇腾 NPU:支持 INT8 和 BF16 运行——国产芯片能跑 V3,这在当时的开源大模型里并不多见。
有两个技术细节容易踩坑。一是 V3 训练时原生采用 FP8 精度,官方只提供 FP8 权重,需要 BF16 权重做实验的话要用官方脚本转换:
cd inference
python fp8_cast_bf16.py --input-fp8-hf-path /path/to/fp8_weights --output-bf16-hf-path /path/to/bf16_weights
二是 Hugging Face 的 Transformers 库当时尚未直接支持 V3,不能像多数开源模型那样几行代码加载,必须走上面列出的推理框架。以官方演示程序为例,完整流程是克隆仓库、安装依赖、转换权重格式,然后用 torchrun 启动:
git clone https://github.com/deepseek-ai/DeepSeek-V3.git
cd DeepSeek-V3/inference
pip install -r requirements.txt
python convert.py --hf-ckpt-path /path/to/DeepSeek-V3 --save-path /path/to/DeepSeek-V3-Demo --n-experts 256 --model-parallel 16
torchrun --nnodes 2 --nproc-per-node 8 --node-rank $RANK --master-addr $ADDR generate.py --ckpt-path /path/to/DeepSeek-V3-Demo --config configs/config_671B.json --interactive --temperature 0.7 --max-new-tokens 200
启动命令里的 –nnodes 2 –nproc-per-node 8 就是两台 8 卡节点的意思,部署规模由此可见。
许可证与版本脉络
许可证分两层:仓库代码用 MIT 许可证,完全自由;初版模型权重用的是 DeepSeek 自定的模型许可协议,允许商用但附带使用限制。2025 年 3 月发布的更新版 V3-0324 起,模型权重也改成了 MIT 许可证,商用障碍基本清零。拿开源权重做商业产品的团队,建议直接选 V3-0324 之后的版本,许可证问题最少。
版本脉络上,V3 之后经历了 V3-0324 等多次迭代,官方主线目前已进入 V4 世代。V3 的架构组合——MLA 注意力、MoE 专家路由加 FP8 训练——被后续各代沿用,这也是为什么讲开源大模型绕不开它。另一条支线同样重要:推理模型 DeepSeek R1 以 V3 为底座训练,官方又反过来把 R1 的长链条推理能力蒸馏回 V3,提升了它的推理表现。V3 与 R1 的关系、推理模型到底特殊在哪,后续文章会单独展开。
相关资源
- 官方仓库:github.com/deepseek-ai/DeepSeek-V3
- 技术报告:DeepSeek-V3 Technical Report(arXiv)
- 站内模型页:DeepSeek V3 / DeepSeek R1
- 官方对话入口:chat.deepseek.com(见站内 DeepSeek 工具页)
© 版权声明
文章版权归作者所有,未经允许请勿转载。