openai-whisper 是 CocoLoop 商店中的一款语音识别 Skill,通过封装 OpenAI 开源的 Whisper 命令行工具,将本地音频转换为文字。它无需 API 密钥,适合整理录音、制作字幕和处理多语言音频,但离线使用需要提前准备运行依赖与模型文件。
它是什么:围绕 Whisper 的配置型 Skill
这款 Skill 的作用是为调用 Whisper 提供使用说明与配置指引,语音识别仍由本地安装的 Whisper 工具完成。它不是独立训练的新模型,也不是安装后便能直接使用的云端转录服务,使用前需要确认设备具备相应运行环境。
来源页面将其列在 steipete 名下,因此应区分底层项目与封装层:Whisper 是 OpenAI 官方开源项目,页面中的 Skill 是围绕该项目提供的封装,不能据此认定 Skill 本身由 OpenAI 官方发布。
按本次编辑指定信息,这款 CocoLoop Skill 属于技术开发方向,下载数为 934,安全等级为 S+。下载量属于动态数据,安全等级则是商店给出的评估信息,两者都不能代替对本地依赖和实际使用环境的检查。
主要能力:转录、字幕与翻译为英文
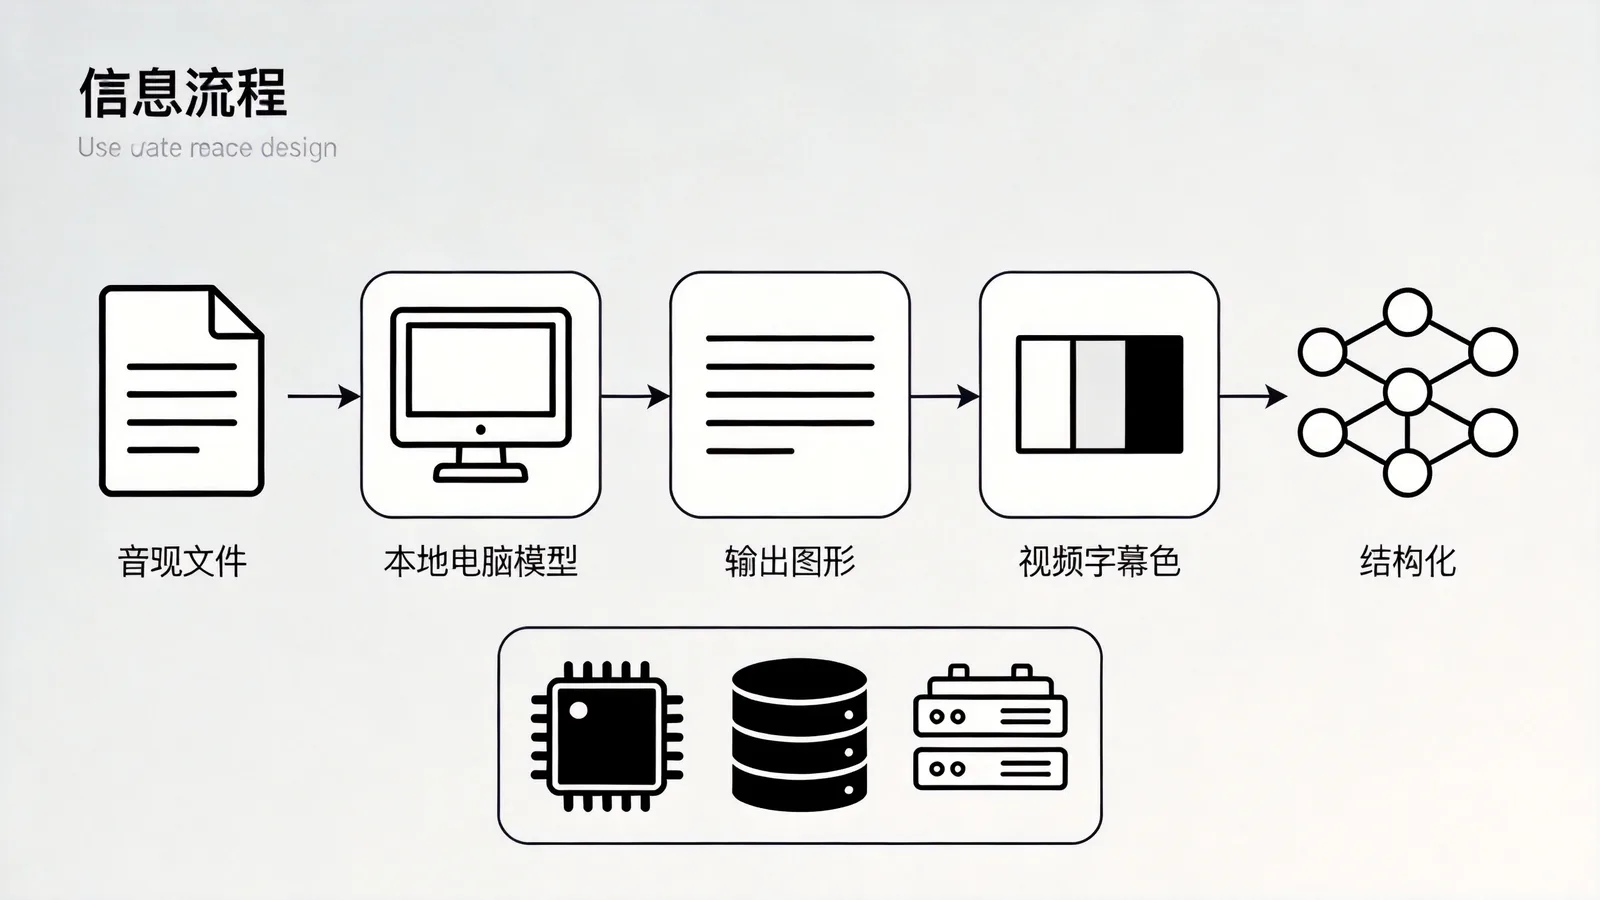
它可以处理 MP3、M4A 等常见音频文件,将语音整理为文字,并输出 TXT、SRT、JSON 等格式。纯文字适合编辑会议记录或访谈稿,字幕格式适合后续视频制作,结构化输出则方便接入其他处理流程。
任务分为转录与翻译两类。转录用于识别原音频中的语言内容;翻译任务则将非英语音频转换为英文。这里的翻译目标有明确边界,不应理解为可以直接在任意两种语言之间互译。
来源介绍 Whisper 覆盖 99 种语言,支持自动语言检测,也可以指定源语言。多语言支持并不意味着不同语言、口音和录音条件下效果一致,涉及人名、数字与专业术语时,输出仍需要人工复核。
使用路径:先准备环境,再处理音频
开始使用时,需要先安装可运行的 Whisper 命令行工具,再通过 Skill 的说明选择音频、模型、任务类型和输出格式。来源列出了 Homebrew 与官方 PyPI 两类安装渠道,因此使用门槛主要在本地环境准备,而不是申请服务账号。
首次选择某个模型时,通常需要联网下载模型文件。模型缓存到设备后,才具备对应模型的离线处理条件;如果计划在隔离网络中使用,应提前准备所需依赖和模型,并完成一次实际转录验证。
处理会议录音可以选择文字输出,制作视频字幕可以选择字幕输出,处理非英语素材时再按需要选择英文翻译任务。完成识别后,还应检查时间轴、断句和内容遗漏,再将结果交给编辑或后续程序使用。
模型与硬件:按设备条件选择处理方案
来源列出了从 tiny、base、small 到 medium、large 和 turbo 的多种模型选择。不同模型在处理速度、识别表现和资源占用之间有所取舍,选型时应同时考虑录音长度、设备配置与可接受的等待时间。
较大模型需要更多内存或显存,使用 CPU 处理长录音可能等待较久。首次下载也会占用时间与存储空间,保留多个模型时,缓存体积会继续增加,需要根据使用情况清理不再需要的模型。
这套命令行使用方式以已录制文件的批量处理为主,不直接提供麦克风实时流式转写。若需求是边说边显示字幕,单靠该 Skill 所描述的基础流程并不足够,还需要额外工具配合。
适用场景与边界:本地处理仍需校对和管理
它适合希望在设备上整理访谈、播客、会议录音的用户,也适合提前准备好环境后,在无稳定网络的场景中处理音频。无需 API 密钥意味着不依赖云端接口调用,但设备计算、电力、存储和维护仍有成本。
本地处理减少了上传录音的需要,但不能据此断言数据绝无泄露风险。录音文件、输出文稿和模型缓存仍保存在设备上,其保护程度也取决于设备权限、文件共享方式以及本地软件来源。
商店标注的 S+ 评级应作为来源信息理解,不能直接延伸为所有使用场景的安全或合规保证。嘈杂背景、重度口音和专业术语也可能影响识别;对于需要准确引用的内容,应结合原录音逐项核对。
延伸阅读
© 版权声明
文章版权归作者所有,未经允许请勿转载。