byterover 是一个装在 AI 编程助手里的 Skill,作用是给项目配一份能跨会话保留的知识库。日常写代码时,AI 助手每开一个新会话就等于失忆一次,上一轮聊清楚的目录结构、命名约定、踩过的坑,下一轮还得从头解释。byterover 的做法是在动手之前让助手先查一遍这个项目已经记下的结论,收尾时再把新的决定写回去。使用方式不用学新工具:装好之后,让助手”先查一下 ByteRover”或者”把这个决定记下来”就行,剩下的命令由它自己调。
它对应的是哪个具体麻烦
把项目约定写进 CLAUDE.md、AGENTS.md 这类规则文件是常见做法,但规则文件是一份静态长文,内容越堆越多,每次会话都要整篇塞进上下文,检索不了也淘汰不了。byterover 换成了一棵可检索的上下文树:知识按主题分块存放,用的时候按问题取相关的几条,不用的时候不占上下文预算。这套思路和 AI Agent 记忆与状态设计里讲的分层记忆是同一条路线,byterover 把它做成了现成的工具。
官方给的定位是项目级的记忆层,面向长周期迭代的代码库。团队里新人上手一个陌生模块,或者半年前的架构决定又被翻出来讨论,这种场景下攒下的知识才有复利。
两个核心动作:查询与整理
Skill 文档把工作方式概括成「查询—整理」(Query-Curate)双模式。三条命令构成全部日常操作:
brv query "question"        # 开工前检索已有知识
brv curate "context" -f file # 收尾后把新结论存进去
brv status                   # 检查前置条件是否就绪
查询用在需要搞清楚某件事的时候——这个功能在代码库里是怎么实现的、有没有现成的模式可以照抄、命名和分层有没有约定。整理用在有东西值得留下的时候:按某种模式实现了一个功能、定位到一个缺陷的根因、做了一次架构选型。
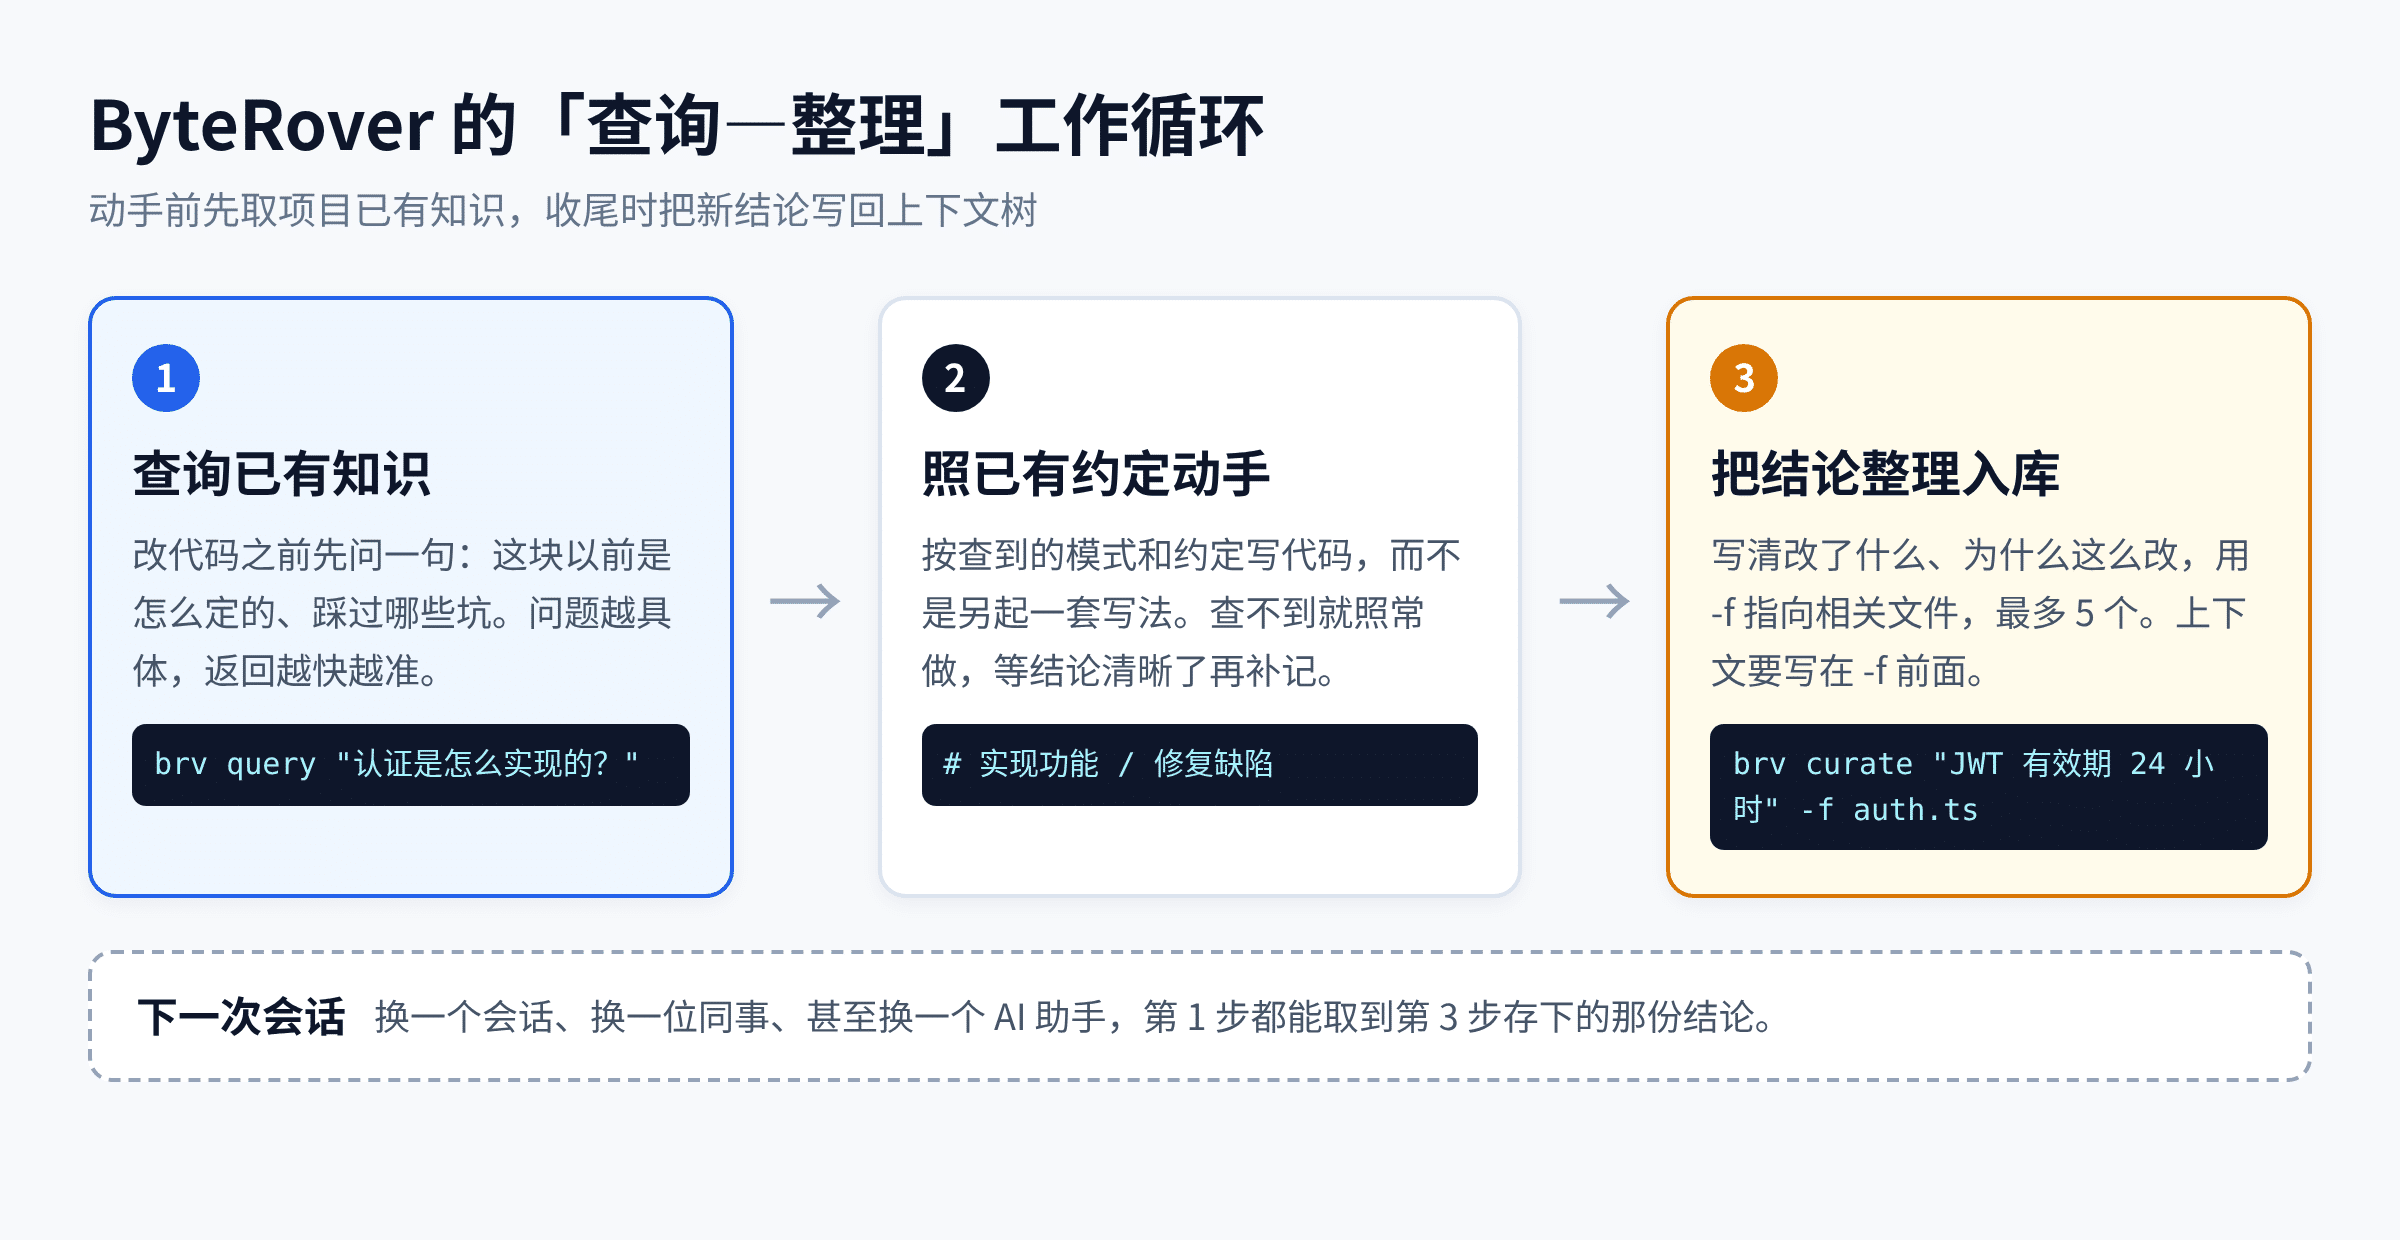
官方示例把两种写法的差别摆得很直白:
# 好的写法 —— 具体,交代了位置和原因
brv curate "Auth uses JWT 24h expiry, tokens in httpOnly cookies" -f src/auth.ts

# 差的写法 —— 太笼统
brv curate "Fixed auth"
有两个参数细节容易出错:上下文文本必须写在 -f 之前,单条命令最多带 5 个文件。
写好上下文的五条做法
Skill 里列了五条最佳实践,每一条都对应一个实际会遇到的问题。
一是把大段内容拆开。一个复杂主题分成几条 curate 写,比压成一条巨型上下文更好检索,日后更新也只动其中一条。
二是别自己先读文件。用 -f 把文件交给 ByteRover 去读,助手自己先读一遍再 curate,同样的内容会进两次上下文,额外消耗一份额度。
# 好 —— 由 ByteRover 读文件
brv curate "Auth implementation details" -f src/auth.ts -f src/middleware/jwt.ts三是查询要问得具体。查询会阻塞助手当前的工作流,问题写得精确,返回更快也更相关。”API 请求结构用的是哪个校验库”这种问法,比”校验是怎么做的”有用得多。
四是主动标记过时内容。新结论替换旧结论时,要在文本里明确告诉 ByteRover 清理掉旧的:
brv curate "OUTDATED: Previous auth used sessions. NEW: Now uses JWT with refresh tokens. Clean up old session-based auth context." -f src/auth.ts五是可以指定组织方式。知识怎么分主题、写到多细,都能在命令里直接要求,比如让它按 JWT 校验、刷新令牌流程、登出处理拆成三个独立主题,或者要求错误处理部分至少写满 30 行覆盖所有错误类型。
WORKFLOWS.md 里另给了五种成套的用法,涵盖新功能开发前的模式调研、缺陷修复后的根因归档、跨文件改动的分条记录、重构后的旧知识替换,以及复杂系统的成体系文档化。跨文件那一条值得单拎出来:一次 API 加服务层加前端 Hook 加组件的改动,官方建议在一条命令里带上全部四个文件,同时在文本里指明要拆成哪几个主题。
报错了由谁来处理
这个 Skill 采用客户端—服务端结构:用户在终端跑 brv 起一个交互式服务进程,助手执行的 query、curate、status 都是连到这个进程上。服务没起来,助手什么也做不了,而且它没有权限自己修。TROUBLESHOOTING.md 把错误明确分成了两类。
需要用户自己动手的:提示没有实例在运行,要另开一个终端跑 brv;提示未认证,要在 brv 交互界面里执行 /login;提示项目未初始化,执行 /init;提示连接失败,按 Ctrl+C 停掉再重开。文档还给了助手一句固定的回复模板——请在你的 brv 终端里完成某项操作,然后我重试。
助手能自己解决的是参数层面的问题:文本没写在 -f 前面、文件数超过 5 个、路径写错、查询没命中内容换个问法再试。退出码是 0 成功、1 一般错误、2 连接错误。
这套分工设计得算清楚,但也意味着它多了一个常驻进程要管。单人开发的小项目,为此额外维护一个终端窗口,收益不一定盖得过成本;更划算的场景是代码库体量大、迭代周期长、同一块逻辑会被反复改动的项目。
官方已经换到了 V4,命令口径对不上
核实官方文档时出现了一处需要提醒的偏差。CocoLoop 上这份包标注的版本是 1.2.1(商店元数据里记的最新版本为 1.2.2),正文写的是 brv query / brv curate 这套 V3 命令行口径。而 byterover.dev 的文档站目前主推的是 V4,形态换成了桌面端加 Skill:动作名从 curate 改成了 record,另外多了 bind(把项目文件夹绑定到指定空间)和 dream(审阅记忆的清理与合并建议),旧版本的文档被归到了「Archived(v2.6.0 及更早)」一栏。
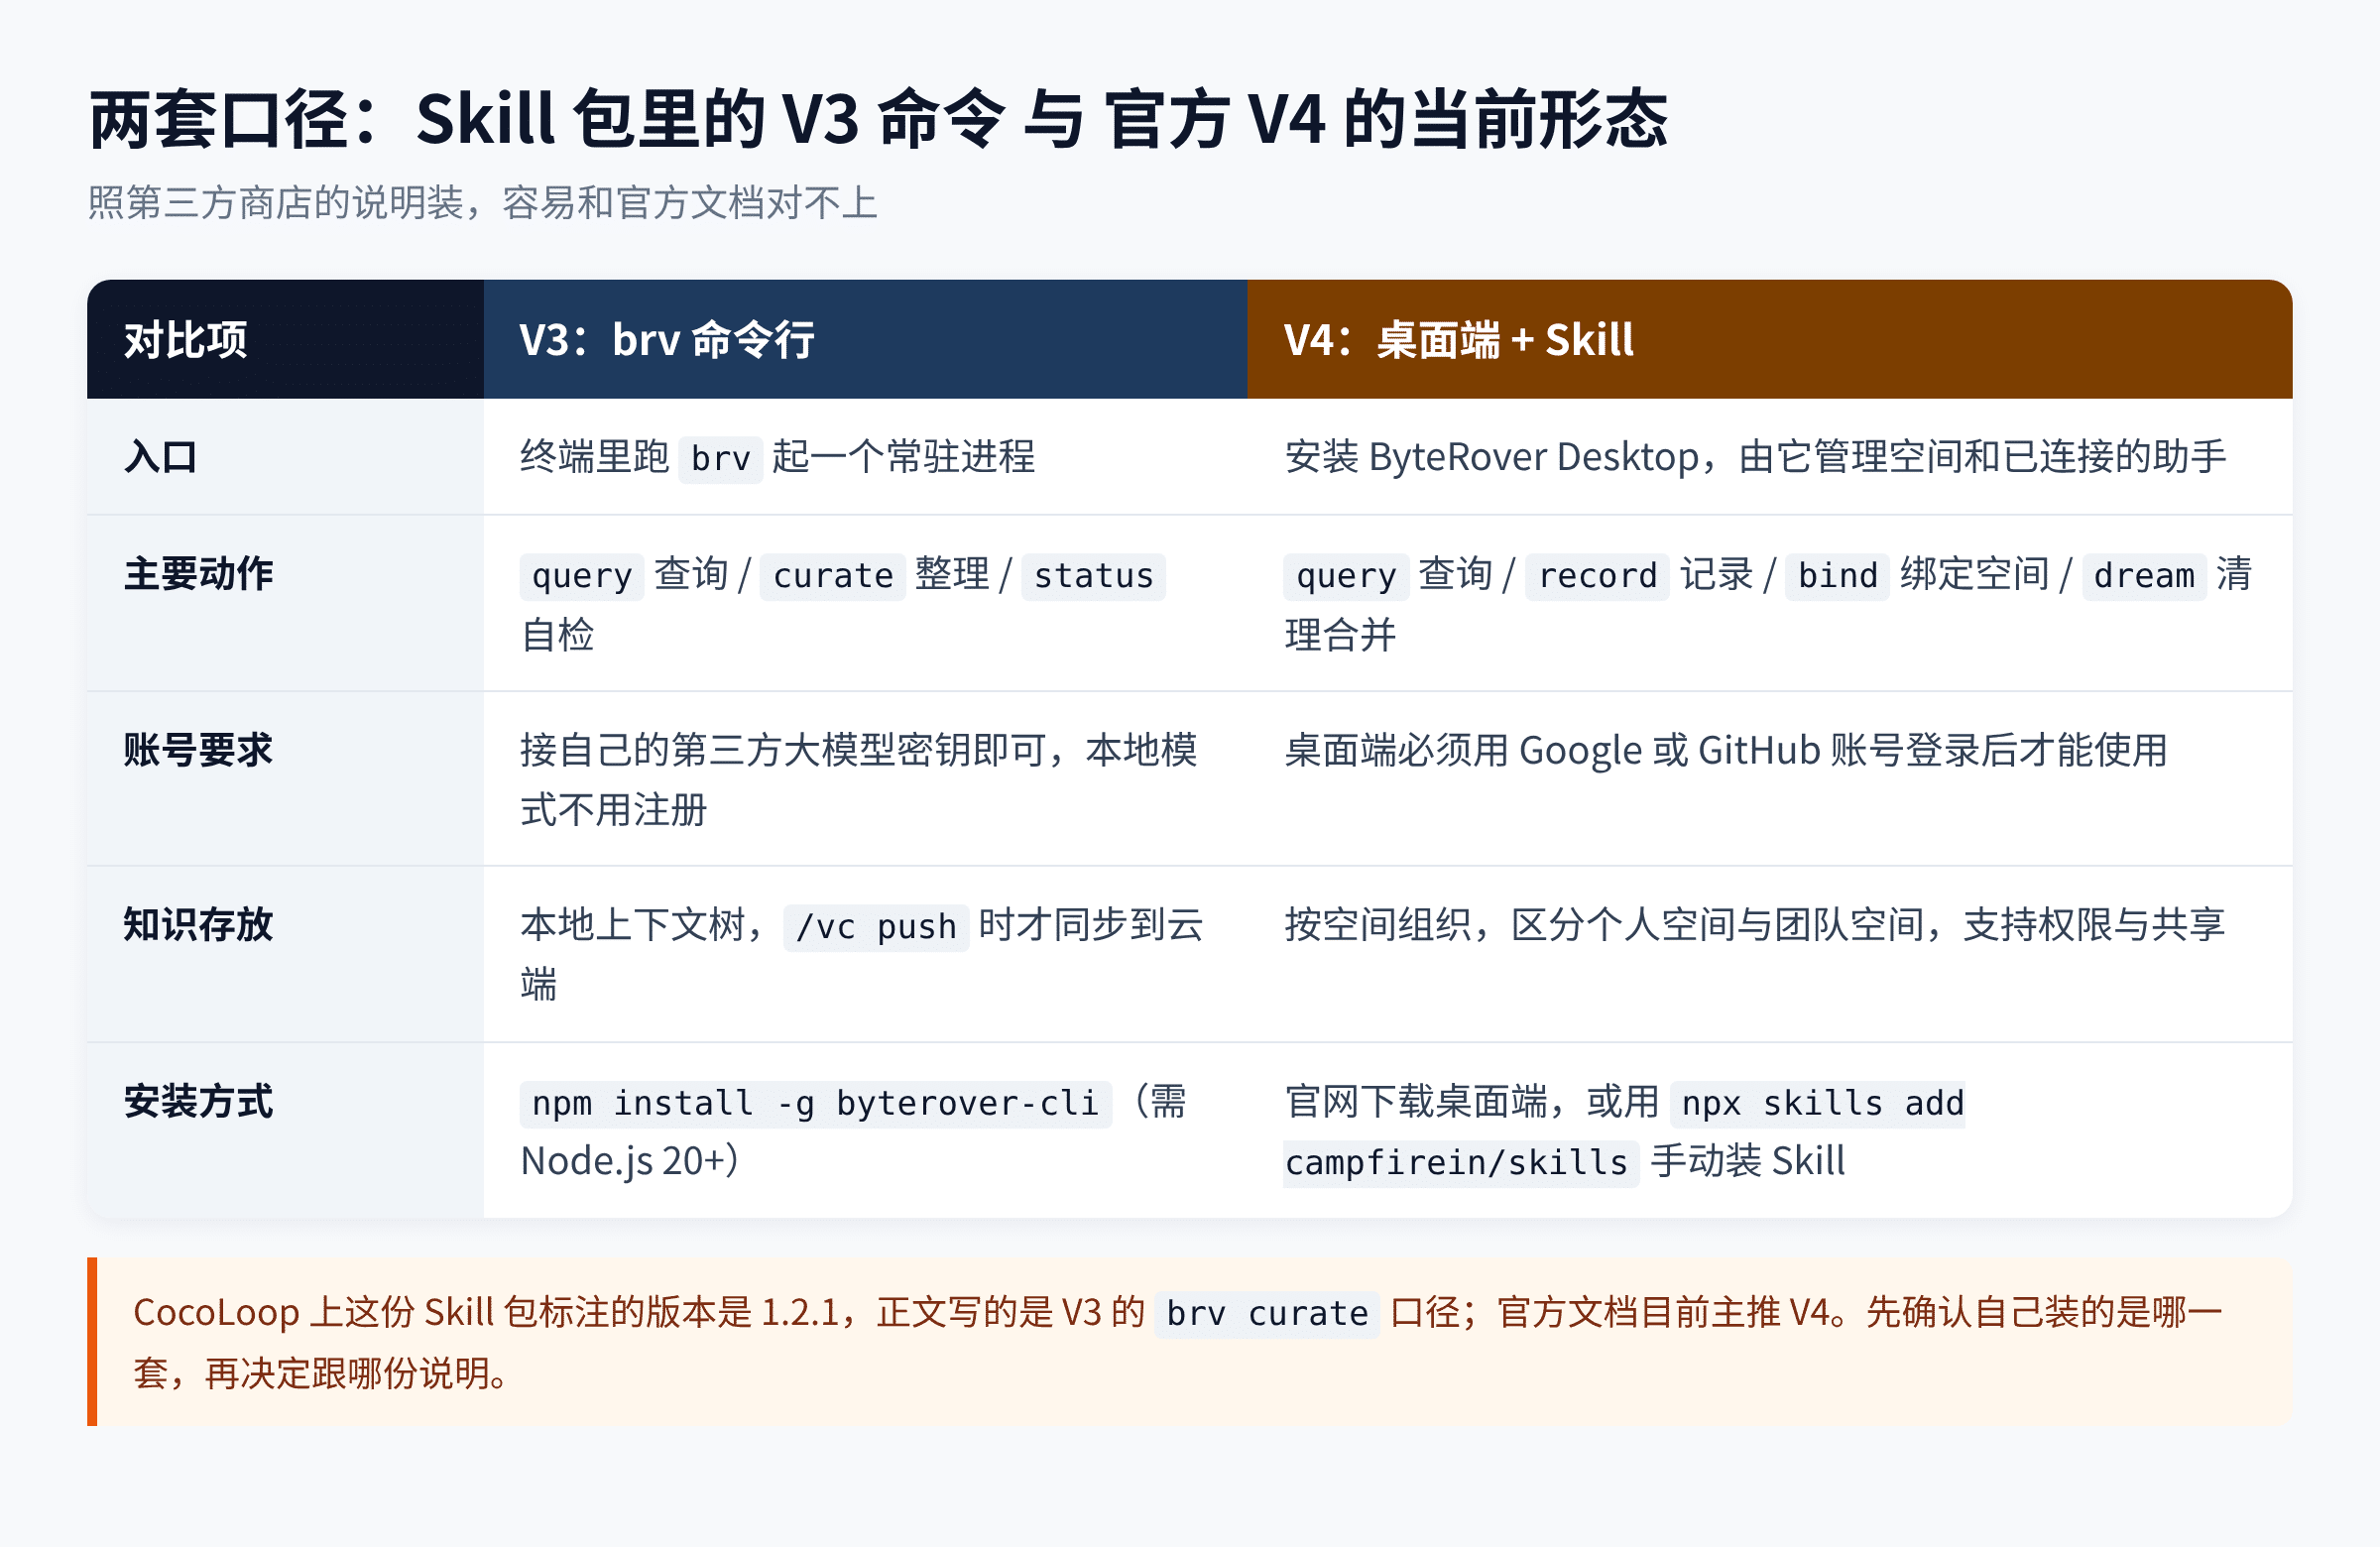
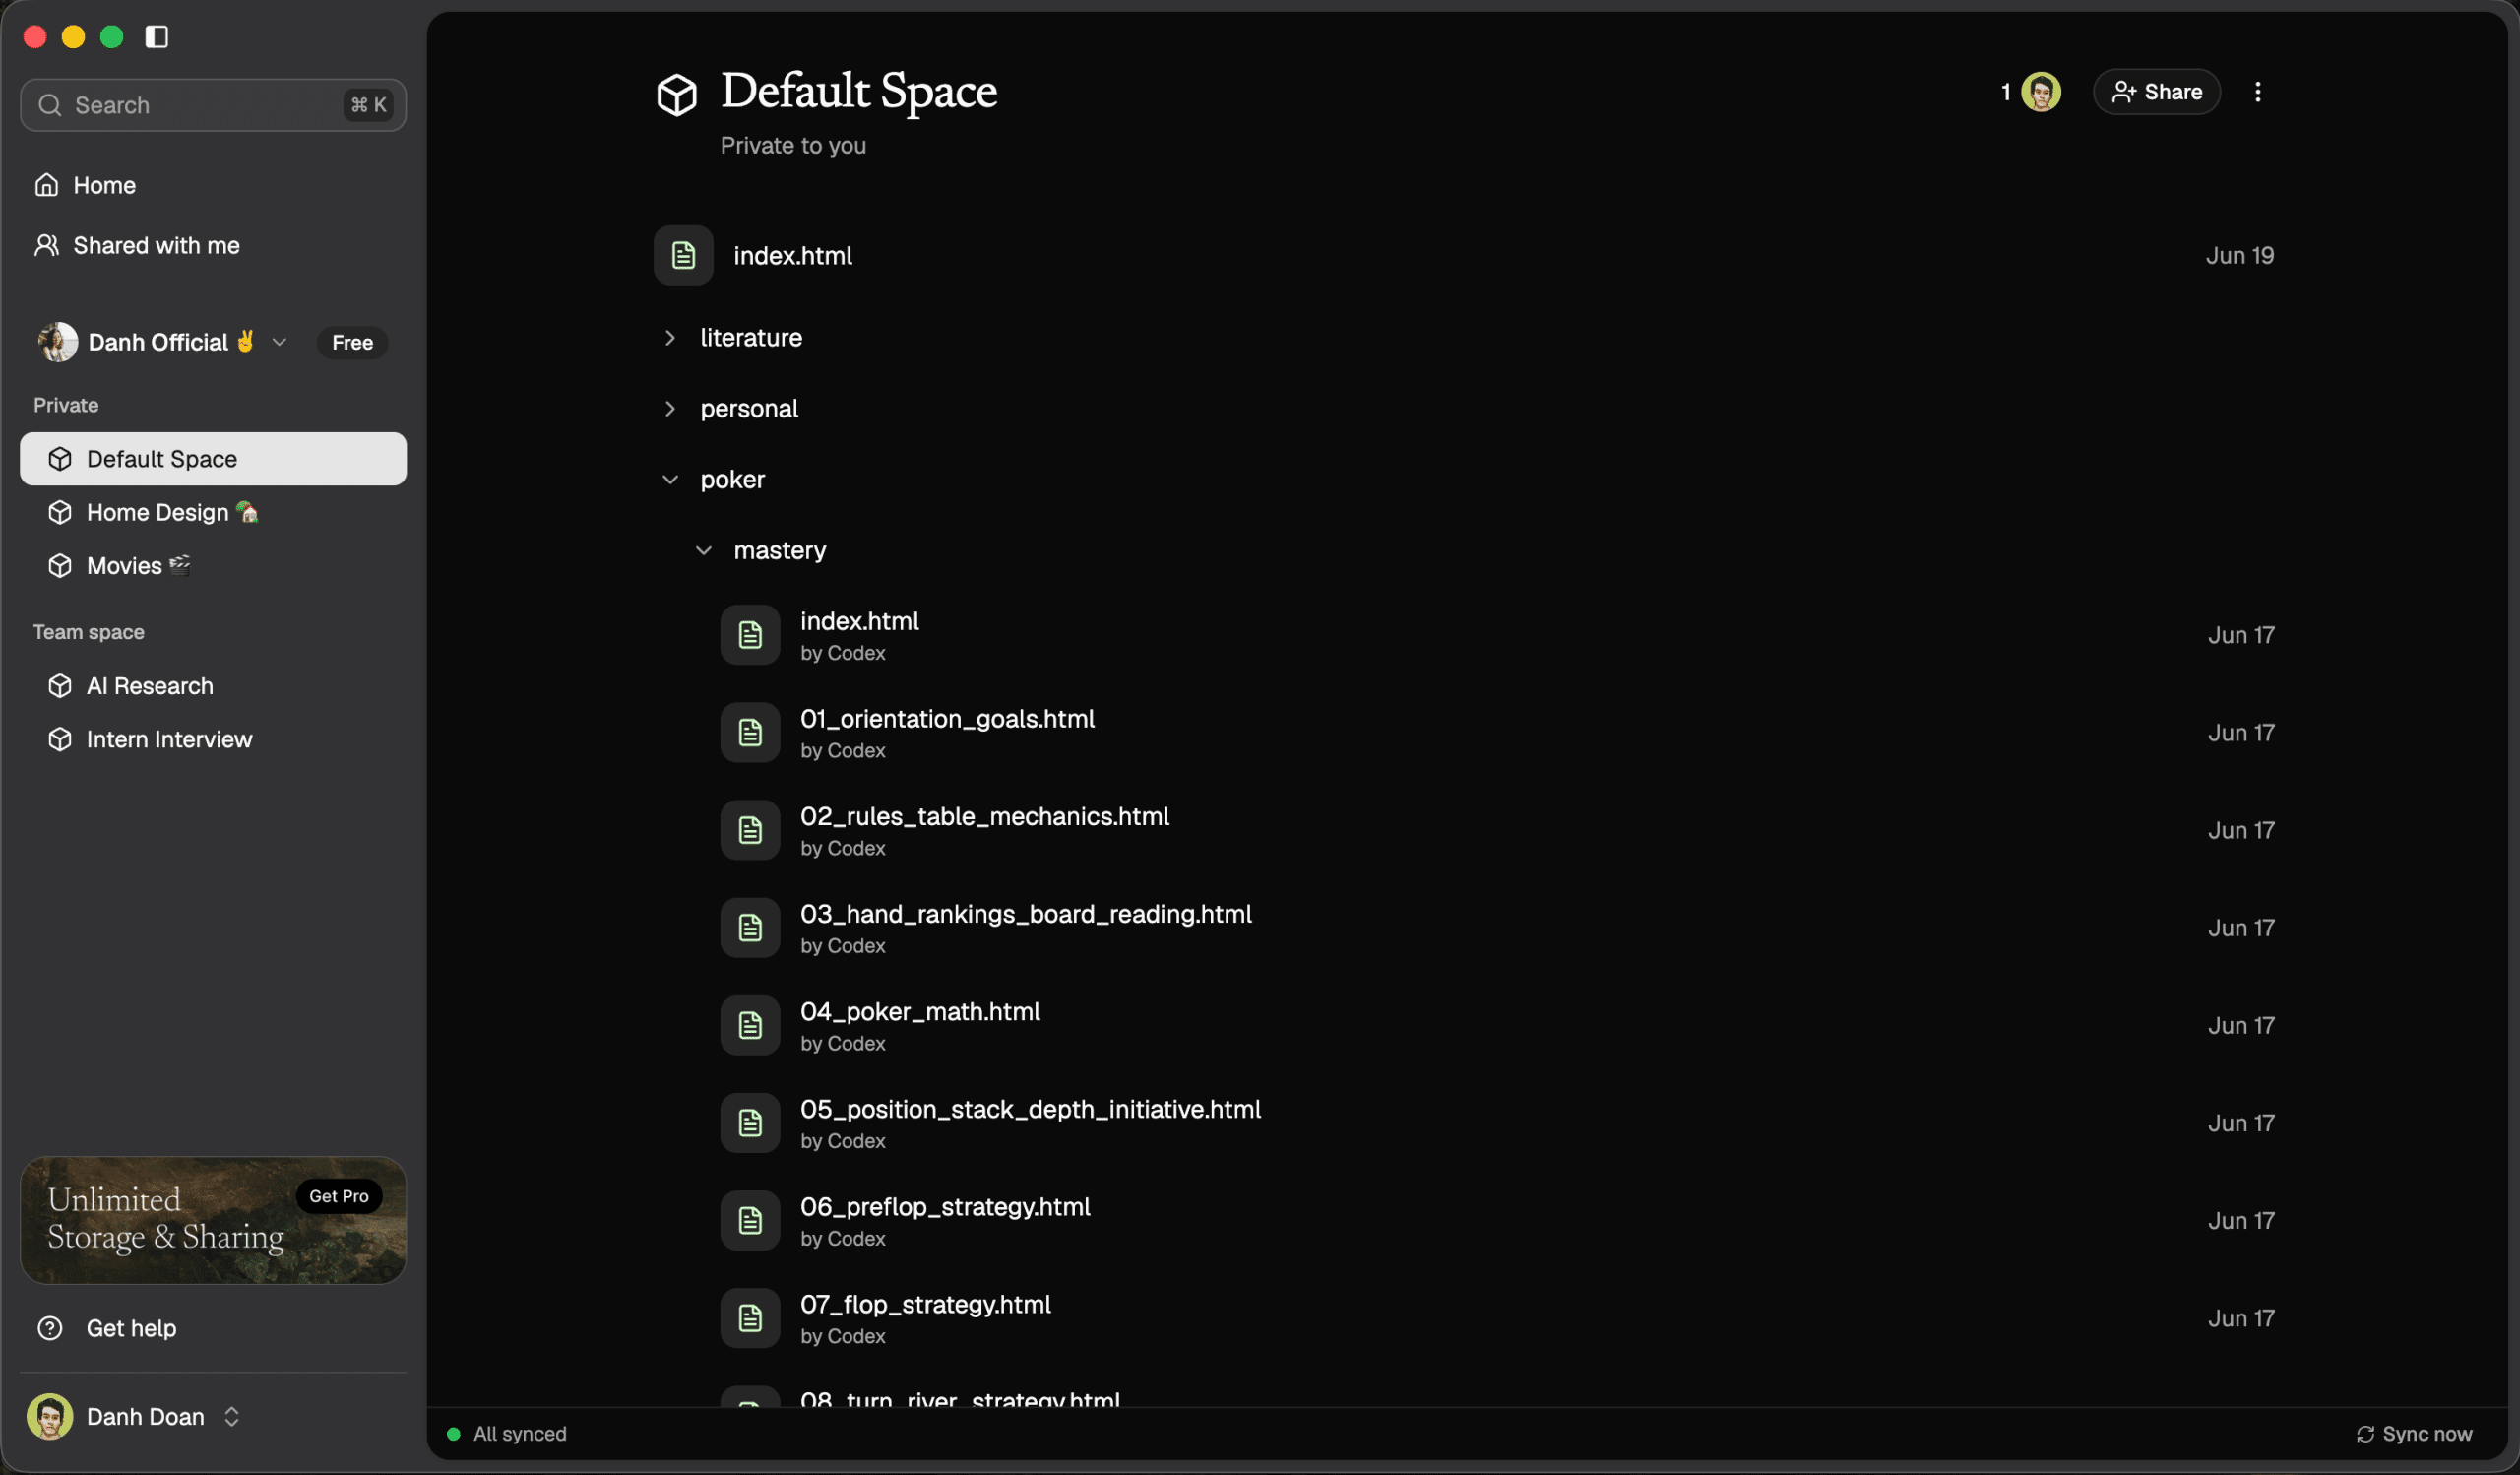
V4 的知识按「空间」组织,分个人空间和团队空间,桌面端负责管理登录、空间、团队成员和权限。
桌面端里能一键连接的助手,官方界面上列出的有 OpenClaw、OpenCode、GitHub Copilot、Cursor、Devin(Windsurf)、Gemini CLI、Claude Code、Claude Desktop、Codex 和 Hermes,覆盖面比大多数同类工具宽。
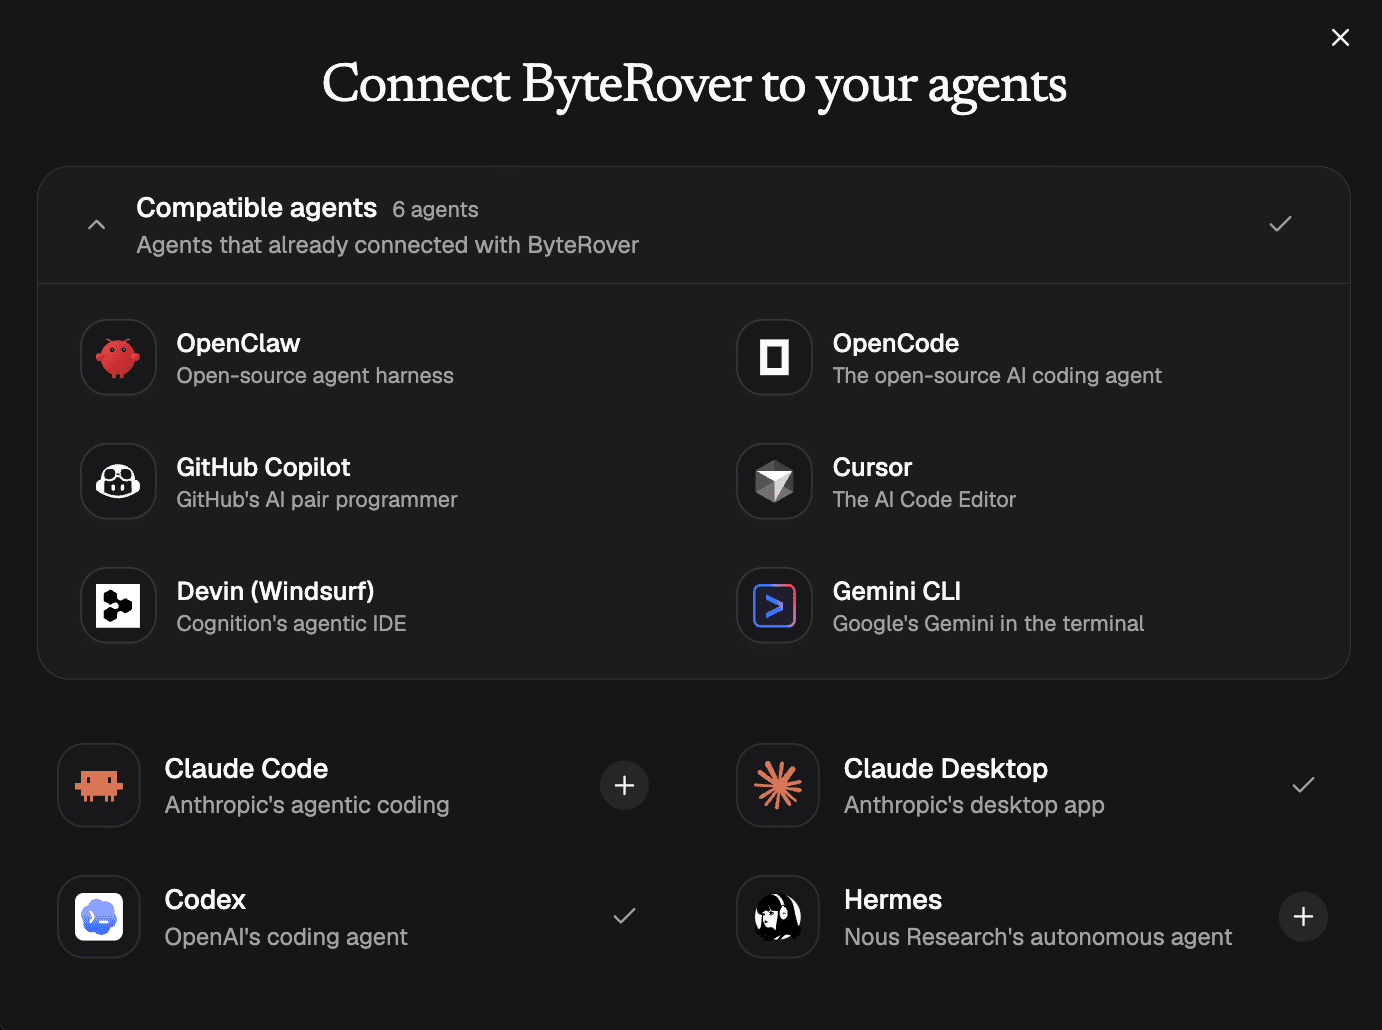
所以从第三方商店装这份包之前,先弄清楚自己要走哪条路:跟着包里的说明走,得先有 V3 的 brv 命令行;照官方 V4 的流程走,包里的 curate 写法就得换成 record。这类第三方 Skill 市场的收录都有滞后,CocoLoop 是社区性质的 Skill 商店,不是 ByteRover 官方渠道,页面上的安全评级、收藏数一类标注也都是该平台自己的口径,可以当参考,不宜当作客观事实引用。find-skills 这类技能发现工具同样存在版本滞后的问题,装之前核对一遍上游仓库的现状,能省掉后面的返工。
两条安装路径
走 V3 命令行的,macOS(Apple Silicon 与 Intel)和 Linux(x86_64 与 ARM64)可以用官方安装脚本:
curl -fsSL https://byterover.dev/install.sh | sh装完重开终端,或者执行安装程序打印出来的那行 export PATH。Windows 走 npm,需要 Node.js 20 及以上版本:
npm install -g byterover-cli然后进项目目录执行 brv 起服务,AI 助手就能调 query 和 curate 了。
走 V4 的路径是:从官网下载 ByteRover Desktop 安装,用 Google 或 GitHub 账号登录,在桌面端的连接页里给自己用的助手装上 Skill,最后在项目里对助手说一句 onboard with ByteRover,它会检查当前项目、关联到对应空间,然后告诉你记忆已经就绪。不方便装桌面端的服务器环境可以手动装 Skill:
npx skills add campfirein/skillsOpenClaw 用户官方另给了一条设置脚本,会一并装上 Skill 和上下文引擎。
账号与价格
V3 命令行是本地优先的设计,接自己的第三方大模型密钥(OpenAI、Anthropic、OpenRouter 等)就能用,不需要注册 ByteRover 账号。curate、query、切换模型提供商、管理助手连接器、浏览 Skill 这些核心动作都在本地模式覆盖范围内。要登录的只有两种情况:用官方内置的大模型,以及用 /vc push、/vc pull 做云端同步和团队共享。V4 桌面端则把登录变成了硬性前置,且只提供 Google 和 GitHub 两种登录方式,国内团队上手前要先确认这两个账号体系在自己的网络环境下走不走得通。
官网定价页列了三档:免费版 0 美元,含 100 个上下文文件的云端同步、多设备同步、团队协作与共享、社区支持;Pro 版年付价格为每月 15 美元,按当前汇率约合人民币 107 元,上下文文件数量不限,邮件支持承诺 24 小时内响应;企业版价格另谈,包含 SOC 2、SSO / SAML、RBAC 和私有化部署。100 个文件对个人项目够用,多人团队共用一个空间的话会消耗得比预想中快。
适合谁,什么时候可以先放一放
值得试的情况有三类:代码库体量大、历史包袱重,新人和 AI 助手都需要反复补课;团队内部有大量不写在代码里的约定和历史决定;同时使用多个 AI 助手,希望它们共用一份项目认知。第三类在实际使用中最能体现价值,毕竟每个助手各自维护一份规则文件是笔重复劳动。
可以先放一放的情况也很明确。短周期的小项目,项目还没跑到需要记忆的阶段就结束了。对数据出境有严格要求的环境,V4 的登录前置和云端空间是绕不开的限制,这种情况下 V3 的本地模式反而更合适。另外要留意,知识质量完全取决于人工整理的习惯——这个工具没有自动识别失效知识的机制,全靠用户在 curate 时手动标 OUTDATED。团队里如果没人坚持这个习惯,上下文树积到一定规模就会开始返回过期结论,那时候的排查成本比不用还高。多人同时 curate 也没有内置的冲突处理策略,团队用之前最好先约定好谁负责哪块主题。
还有一条安全提醒来自官方文档之外的常识:上下文树会原样保存用户写进去的内容,API 密钥、数据库连接串这类东西一旦被顺手 curate 进去,就等于多了一处泄露面。团队使用前建立一条审查规范是必要的。
把工具本身的能力和使用习惯分开看,byterover 解决的是知识存取的工程问题,知识值不值得存、存得准不准,仍然是人的事。想先把这件事的原理弄明白,可以对着上下文工程入门补一遍背景;想看看别的 Skill 是怎么组织工作流的,n8n-workflow-automation Skill 入门是另一个方向的样本。
© 版权声明
文章版权归作者所有,未经允许请勿转载。