DeepSeek R1 是国内公司深度求索(DeepSeek)在 2025 年 1 月开源的第一代推理模型。用大白话说:普通 AI 模型收到问题后直接给答案,R1 则会先在草稿纸上把题目拆开、一步步推导、自己检查有没有算错,确认之后才给出最终回答。这套「先想后答」的机制让它在数学、编程、逻辑推理这类难题上的表现远超同期的普通模型,发布时的成绩与 OpenAI 的 o1 相当。普通人想体验它不需要任何门槛——DeepSeek 官网的对话页面免费可用,打开深度思考模式就是推理模型在工作。
这篇文章讲清楚三件事:推理模型到底是什么、R1 和 DeepSeek V3 的区别在哪、现在有哪几种方式能用上它。文中的版本参数、评测数据均来自 DeepSeek 官方 GitHub 仓库。
推理模型和普通模型的区别
两类模型的差别可以用答题方式来理解。V3 这样的通用模型相当于「抢答型选手」,收到问题立即组织语言输出,速度快,日常问答、写作、翻译都够用。R1 这样的推理模型则是「草稿纸型选手」:回答前先生成一段很长的思考过程(术语叫思维链,Chain-of-Thought),在这段过程里拆解问题、逐步推导、自我验证,发现错误还会回头修正,最后才输出结论。
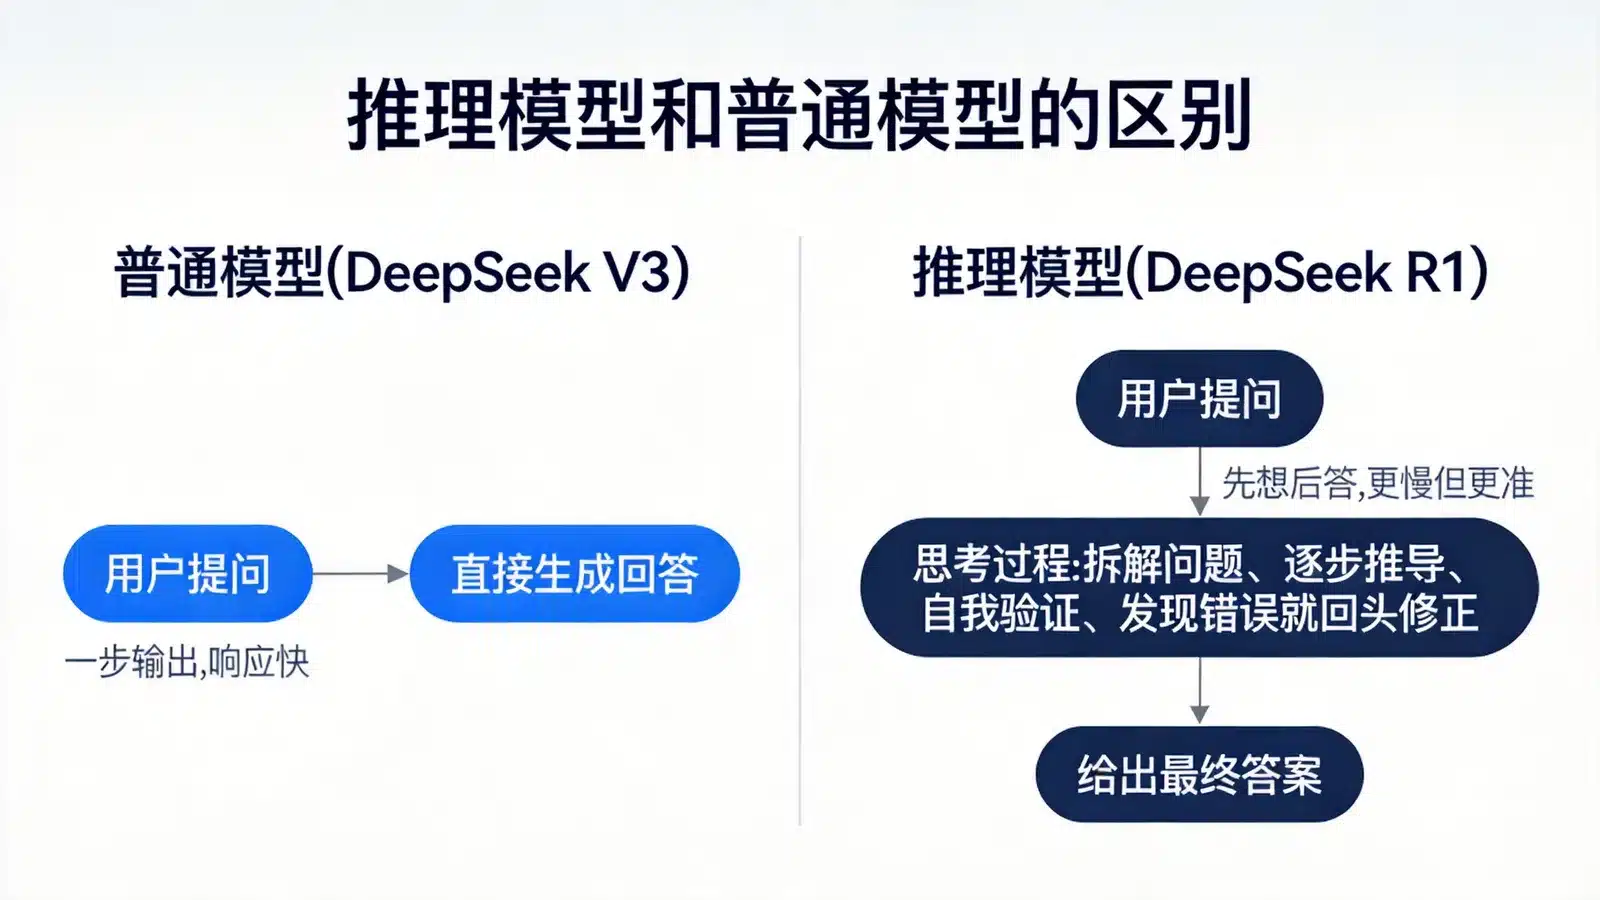
图:推理模型与普通模型的回答流程对比
代价也很直接:思考过程本身要消耗大量文字输出,所以推理模型响应更慢、算力开销更大。这决定了它的适用边界——日常聊天、写邮件、总结文档,用 V3 这类通用模型体验更好;数学推导、竞赛编程、需要多步逻辑的分析题,才值得让 R1 慢慢想。把简单问题丢给推理模型,得到的不是更好的答案,而是更长的等待。
R1 和 V3 的关系:同一副身体,不同的训练
一个容易误解的地方:R1 并不是比 V3「更大」的模型。两者参数规模完全相同——总参数 671B(6710 亿)、每次推理实际激活 37B、上下文窗口 128K,都采用混合专家(MoE)架构。R1 就是在 V3 的基座模型(V3-Base)之上,用不同的训练方法练出来的:V3 练的是「见多识广、快速应答」,R1 练的是「深度思考」。
R1 的创新集中在训练方法上。DeepSeek 先做了一个实验版本 R1-Zero:跳过监督微调(SFT),直接对基座模型做大规模强化学习(RL)。结果模型自发长出了自我验证、反思、生成长思维链这些推理行为——这是公开研究中第一次证明,不靠人工标注的示范数据、纯靠强化学习就能激发出大模型的推理能力,R1 论文(arXiv 2501.12948)也因此成为 2025 年被引用最多的 AI 论文之一。不过 R1-Zero 有明显毛病:输出容易无限重复、可读性差、中英文混杂。正式版 R1 为此加了一道「冷启动」工序,先用少量高质量数据打底,再走两轮强化学习加两轮监督微调的完整管线,把推理能力和正常表达能力都练齐了。
性能差距:数学与编程基准对比
官方评测数据把两者的差距量化得很清楚。美国数学邀请赛 AIME 2024 上,V3 的通过率是 39.2%,R1 达到 79.8%,翻了一倍还多;Codeforces 编程竞赛中 R1 拿到 96.3 百分位,意味着超过 96% 的人类参赛者,V3 只有 58.7;中文考试基准 C-Eval 上 R1 也拿下 91.8 分。这些数字与 OpenAI 当时的旗舰推理模型 o1 基本持平。
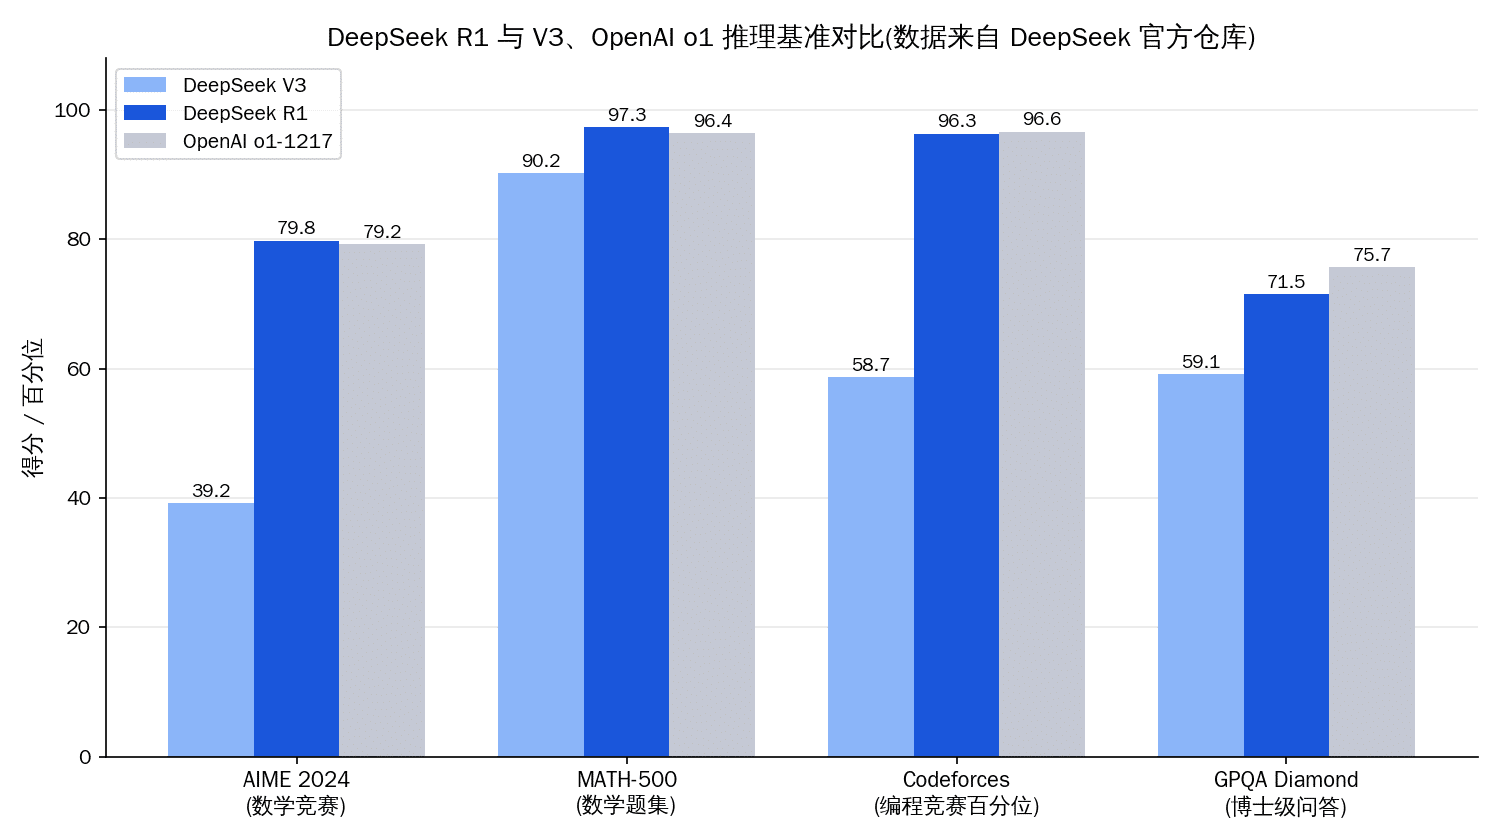
图:R1 与 V3、OpenAI o1 的官方评测数据对比(按 DeepSeek 仓库公布数据绘制)
通用能力上两者各有胜负:指令遵循基准 IF-Eval 上 R1(83.3)反而略低于 V3(86.1),中文事实问答 C-SimpleQA 也是 V3 更高。推理模型的提升集中在深度思考类任务上,通用对话能力并没有同步变强。
六个蒸馏版:普通电脑也能跑的小号 R1
671B 的满血 R1 个人跑不动,DeepSeek 的解法是蒸馏:用 R1 生成的 80 万条推理数据去微调 Qwen2.5 和 Llama3 系列的开源小模型,让小模型学会大模型的推理套路。官方一口气放出了六个蒸馏版:基于 Qwen 的 1.5B、7B、14B、32B,以及基于 Llama 的 8B 和 70B。效果超出很多人预期——蒸馏 32B 版在多项基准上超过了 OpenAI o1-mini,AIME 通过率 72.6%。
这六个版本的选择思路:32B 是效果和硬件成本最平衡的一档,适合有一两张专业显卡的团队;7B 和 8B 量化之后一张主流游戏显卡就能带动,是个人本地体验推理模型的合理起点;1.5B 在没有独立显卡的笔记本上也能跑起来,适合纯尝鲜。14B 和 70B 介于其间,除非硬件正好卡在这两档,一般直接选 32B 或 8B。
怎么用上 R1
网页版(零门槛):打开 chat.deepseek.com,注册后开启「深度思考」开关即可,免费且国内直接访问。需要说明的是,官网的深度思考功能已随 DeepSeek 模型迭代升级——2026 年的今天,官方 API 的现役模型是 V4 系列(deepseek-v4-flash / deepseek-v4-pro),推理能力通过 thinking 参数内置在主线模型里,不再单独挂「R1」的名字。R1 开创的「先想后答」路线已经成了行业标配,阿里的 Qwen3 采用的混合推理也是同一思路。
开源权重(自部署):R1 全系权重开放下载,Hugging Face 上的 deepseek-ai 主页可以找到全部版本;国内访问 Hugging Face 不稳定的话,魔搭社区(ModelScope)有同步镜像,下载速度也更快。满血版的部署方法参考 DeepSeek-V3 仓库(两者架构相同),注意官方明确提示 Hugging Face 的 Transformers 库尚未直接支持满血 R1。蒸馏版就简单多了,当作普通的 Qwen 或 Llama 模型用即可,官方给了 vLLM 的启动命令:
vllm serve deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --tensor-parallel-size 2 --max-model-len 32768 --enforce-eager用 SGLang 也可以:
python3 -m sglang.launch_server --model deepseek-ai/DeepSeek-R1-Distill-Qwen-32B --trust-remote-code --tp 2官方使用建议
DeepSeek 在仓库里给出了几条容易踩坑的配置要点,自部署时值得照做:
- 温度设在 0.5–0.7 之间,推荐 0.6。设得不对容易出现无限重复或语无伦次的输出。
- 不要设置系统提示词(system prompt),所有指令直接写进用户消息里。
- 数学题在提示词里加上「请逐步推理,并把最终答案写在 \boxed{} 中」,能明显提高准确率。
- R1 系列偶尔会跳过思考直接作答(输出空的 think 标签),影响效果。官方的对策是强制模型以「<think>\n」开头生成,确保每次都完整思考。
另外,官方网页版和 App 不用系统提示词,但为文件上传和联网搜索设计了两套固定的提示词模板(仓库里有完整原文),网页版温度同样固定在 0.6——想在自己的应用里复刻官网体验,可以直接照抄这两个模板。
许可证与版本更新
R1 全系采用 MIT 许可证,代码和模型权重都允许商用、允许修改和二次开发,官方明确写了「包括拿去蒸馏训练其他模型」——这在大模型开源里是相当彻底的授权。唯一要留意的是蒸馏版继承了各自底模的许可:Qwen 系列底模是 Apache 2.0,Llama 系列底模则要遵守 Meta 的 Llama 许可条款。
版本方面,R1 在 2025 年 5 月底发布过一次重要更新 R1-0528,推理能力进一步增强,同样是 MIT 许可,Hugging Face 上与初版并列提供。此后 DeepSeek 的推理路线并入了主线模型(V3.1 起融合思考模式,再到现在的 V4 系列),R1 作为独立模型不再迭代,但它仍是理解推理模型原理、研究强化学习训练最重要的开源样本,蒸馏版也依然是本地部署推理模型的常见选择。
相关链接
- 官方仓库:github.com/deepseek-ai/DeepSeek-R1
- 在线体验:chat.deepseek.com(开启深度思考)
- 站内模型页:DeepSeek R1 | DeepSeek V3
- 延伸阅读:DeepSeek V3 入门指南:671B 开源大模型能干什么、普通人怎么用
© 版权声明
文章版权归作者所有,未经允许请勿转载。