Gemma 3 是谷歌 DeepMind 在 2025 年 3 月发布的一组开放权重模型,和 Gemini 出自同一套研究与技术路线,区别在于权重可以下载到本地,不必联网调用云端 API。它能做的事情和常见的对话模型一致:回答问题、总结长文、改写与翻译、写代码、看图并描述图片内容。对普通用户来说,最实际的用法是在自己的笔记本或台式机上装一个 Ollama,输入一行命令把模型拉下来,此后所有对话都在本机完成,数据不出设备,也不产生调用费用。
这一代模型一共有五个尺寸,从 270M 到 27B,跨度很大。选错尺寸是新手最容易踩的坑——挑小了答非所问,挑大了机器带不动。下面按官方模型卡和 Ollama 官方模型库的数据,把选型、部署和适用边界讲清楚。站内的 Gemma 3 模型页收录了各版本的下载入口,可以对照着看。
五个尺寸各自的位置
Gemma 3 提供 270M、1B、4B、12B、27B 五种参数规模,每种都有预训练版(PT)和指令微调版(IT)。日常使用一律选指令微调版,预训练版是给要自己做微调的开发者准备的。
尺寸之间的能力差距比参数数字看起来更悬殊。官方模型卡给出的预训练版基准成绩里,MMLU(5-shot)从 1B 的 26.5 一路涨到 4B 的 59.6、12B 的 74.5、27B 的 78.6;GSM8K 小学数学题上,1B 只有 1.36 分,4B 是 38.4,27B 达到 82.6。这组数字说明一件事:1B 和 270M 不适合用来做推理、数学或知识问答。它们适合的位置是文本流水线里的轻量环节,比如按固定格式抽取字段、给短文本打标签、做简单的分类和改写,这类任务对知识储备要求低,对响应速度和内存占用要求高。谷歌在 2025 年 8 月单独放出 270M 版本,定位也正是这类嵌入式场景。
4B 是一般用户的合理起点,它是第一个支持图像输入的尺寸,在 Ollama 上也被设为 gemma3 的默认标签。12B 在知识密度和代码能力上有明显提升,HumanEval 从 4B 的 36.0 上到 45.7。27B 是这一代的上限,单卡能跑,成绩在当年的开放权重模型里属于第一梯队,但对显存的要求已经不是普通笔记本能满足的了。
上下文长度、语言与图像输入
4B、12B、27B 三个尺寸的上下文窗口是 128K token,足够一次塞进一份长报告或一整个代码文件夹的核心文件。270M 和 1B 是 32K,处理长文档时要自己做分段。
图像输入这块要分清楚:只有 4B 及以上支持,270M 和 1B 是纯文本模型。图片进入模型前会被统一缩放到 896×896 分辨率,再编码成 256 个 token。这个细节对估算成本有用——一张图约等于 256 个 token 的上下文开销,连续喂十几张图就会明显吃掉窗口。
多语言方面,官方标注训练数据覆盖 140 种以上语言,中文包含在内。实际体感是中文能用但不算强项,尤其在成语、古文和中文特有的表达习惯上,和专门针对中文优化的国产模型有差距。中文为主的场景下,Qwen3 或 GLM-4.5 是更稳妥的选择,Gemma 3 的优势在于同等体积下英文与代码任务的表现,以及极小尺寸带来的部署灵活度。
本地部署:Ollama 路线
本地跑 Gemma 3 最省事的方式是 Ollama。先到官网装好客户端,注意版本要求——官方说明写明需要 Ollama 0.6 或更高版本,老版本拉不动这一代模型。装好之后一行命令就能开始:
ollama run gemma3这条命令拉取的是默认标签,也就是 4B 版本。想指定尺寸就在冒号后面写清楚:
ollama run gemma3:270m
ollama run gemma3:1b
ollama run gemma3:4b
ollama run gemma3:12b
ollama run gemma3:27b
模型拉完会直接进入交互式对话,输入问题回车即可。想接进自己的程序,Ollama 在本机 11434 端口提供了 HTTP 接口:
curl http://localhost:11434/api/chat \
  -d '{
  "model": "gemma3",
  "messages": [{"role": "user", "content": "Hello!"}]
}'
Python 侧的写法同样简洁,装好 ollama 包之后:
from ollama import chat
response = chat(
    model='gemma3',
    messages=[{'role': 'user', 'content': 'Hello!'}],
)
print(response.message.content)
下载体积是选型时的硬约束。按 Ollama 官方模型库页面标注的默认量化版本,270M 只有 292MB,1B 是 815MB,4B 为 3.3GB,12B 涨到 8.1GB,27B 则是 17GB。
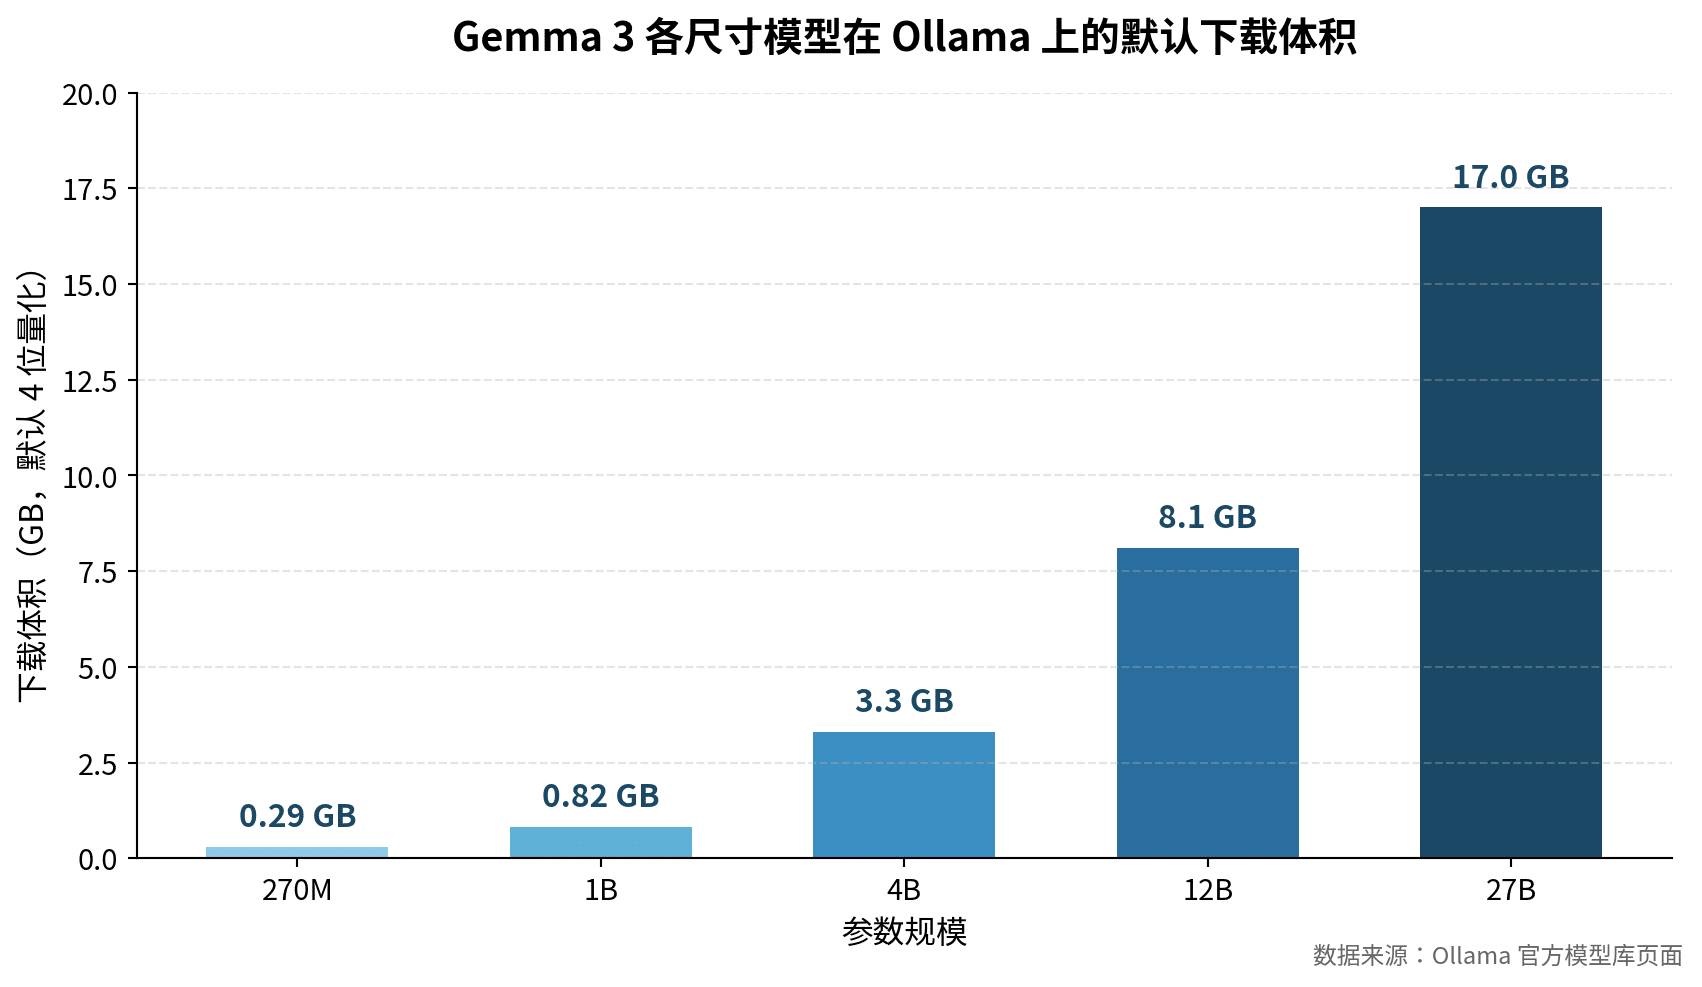
这里要区分两个概念:下载体积是磁盘占用,实际运行时还需要额外的显存或内存来放上下文缓存,输入越长占用越高。粗略的经验是留出比模型体积多三到五成的余量。8GB 显存的显卡跑 4B 从容、跑 12B 勉强;27B 需要 24GB 级别的显卡,或者用统一内存较大的 Mac。
量化版本与质量取舍
如果默认版本跑不动,优先试官方的量化感知训练版本(QAT),而不是随便找个第三方量化文件。两者的区别在于:常规的训练后量化是把已经训好的模型硬压缩,质量会有可感知的下滑;QAT 是在训练过程中就让模型适应低精度表示,官方说明称其内存占用降到非量化版本的三分之一左右,质量仍接近 BF16 半精度版本。
Ollama 上的 QAT 标签是这样拉的:
ollama run gemma3:1b-it-qat
ollama run gemma3:4b-it-qat
ollama run gemma3:12b-it-qat
ollama run gemma3:27b-it-qat
对显存卡在临界线上的机器,这是一条值得优先尝试的路径——用 QAT 版本跑 12B,往往比用默认量化跑 4B 更划算。
不想装环境的在线路径
不愿意在本机折腾环境,可以走 Google AI Studio,在浏览器里直接选 Gemma 模型试对话;需要接进服务端的话,Gemma 也在 Google 的 API 体系和 Vertex AI Model Garden 里提供。权重文件本身托管在 Hugging Face 和 Kaggle 上,做微调或离线分发时从这两处下载。
这几个入口在中国大陆的可达性不一样,事先要有准备:ai.google.dev 官方文档站、Google AI Studio 和 Hugging Face 都需要相应的网络环境才能打开;Ollama 拉模型走的是它自己的镜像分发,一般不受影响,这也是国内用户首推 Ollama 路线的现实原因。确实需要从 Hugging Face 取原始权重的,可以用 hf-mirror.com 这类国内镜像站替代。
Gemma 4 发布之后,这一代还值得用吗
需要交代清楚的背景是:谷歌已于 2026 年 4 月发布 Gemma 4,覆盖 E2B、E4B、12B、26B A4B 和 31B 五种规格,加入了音频输入、多 token 预测加速和原生 system 角色支持,中大尺寸的上下文窗口提升到 256K。Gemma 3 已经不是最新一代。
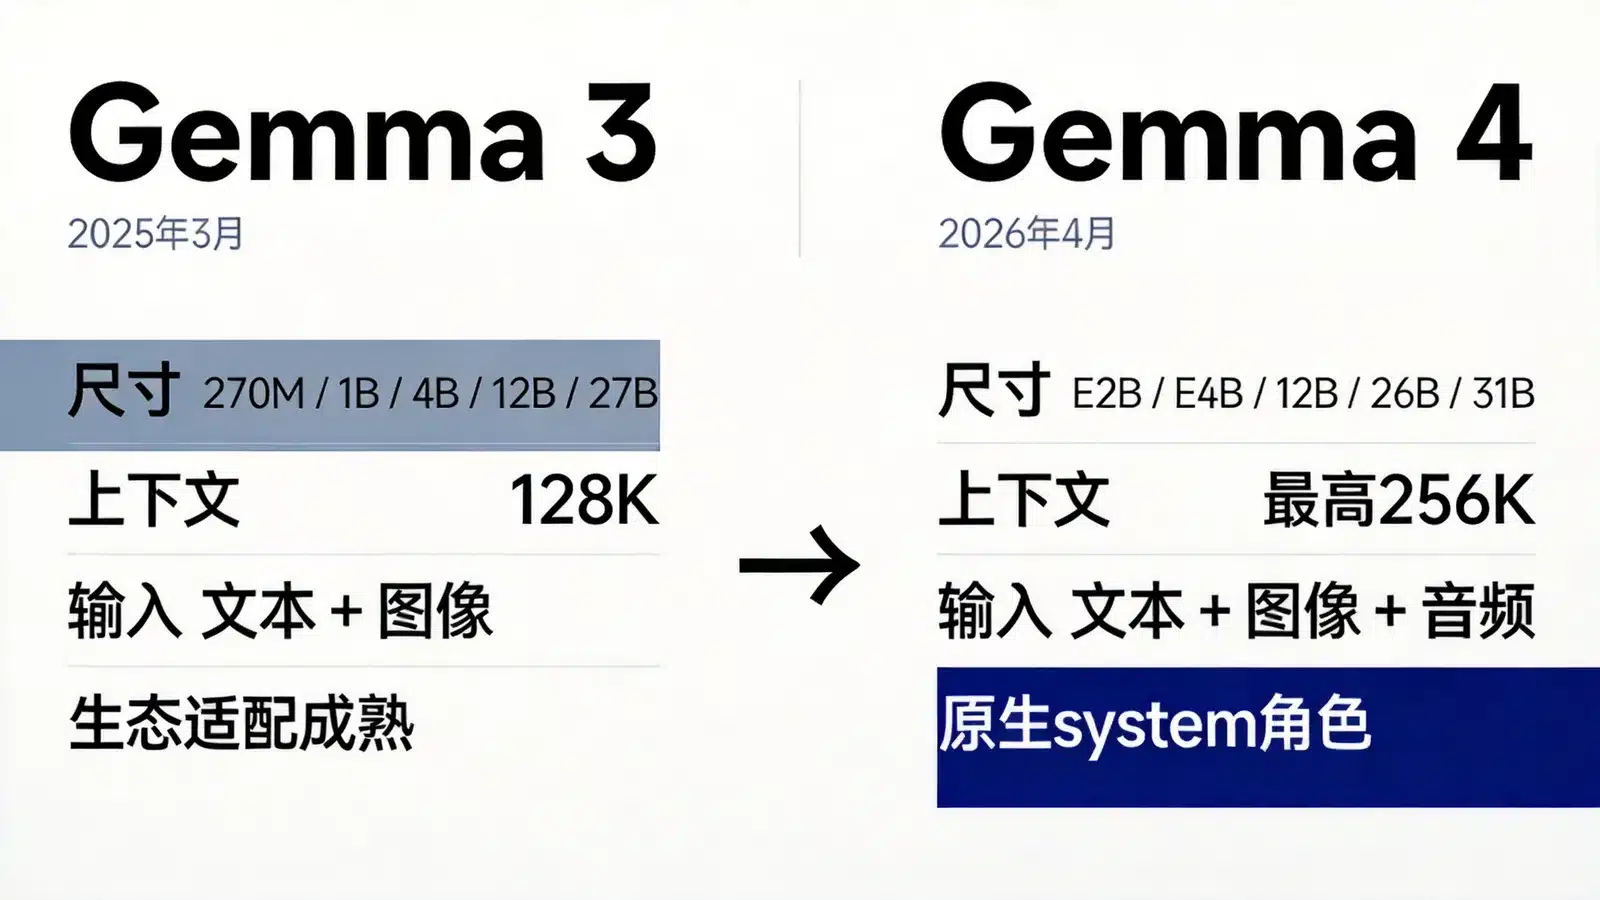
即便如此,Gemma 3 在几种情况下仍然是合理选择。一是存量部署已经跑通、上下游工具链都适配好,没有必然的升级理由;二是手上的推理框架版本较老,新架构(尤其是 MoE 结构的 26B A4B 和无编码器的 12B)支持还不完善,而 Gemma 3 的兼容面经过一年多沉淀已经很广,llama.cpp、vLLM、MLX 一类常见框架都有成熟支持;三是 270M 这类超小尺寸,新一代并没有完全对应的替代型号。反过来说,如果是从零起步的新项目,硬件也够,直接上 Gemma 4 更合适。
另一项需要留意的限制是知识截止时间。Gemma 3 的训练数据截止到 2024 年 8 月,此后发生的事情它一概不知道,涉及时效信息的场景必须外挂检索或手工提供资料,不能指望模型自己答对。
许可条款与商用前的确认
Gemma 系列采用的是谷歌自己的 Gemma 使用条款,不是 Apache 2.0 或 MIT 这类标准开源许可。条款允许负责任的商业使用,同时附带一份禁止用途政策,并要求下游分发时把使用限制一并传递下去。个人学习和内部试用不需要在这上面费心,但把模型嵌进对外的商业产品之前,应当完整读一遍条款原文,或者交由法务确认。这一点和 Llama 4 的社区许可属于同一类情况,都不能按标准开源许可的惯例直接套用。
想深入了解训练方法与完整评测数据的,官方技术报告在 arXiv 上公开(编号 2503.19786),模型卡页面也列出了全部基准成绩和安全评估结果。
快速上手清单
- 普通笔记本、只想试试:装 Ollama 0.6 以上版本,执行
ollama run gemma3,拉的是 4B 多模态版本,3.3GB。 - 需要看图:至少选 4B,270M 和 1B 不支持图像输入。
- 显存 8GB 左右想上 12B:用
gemma3:12b-it-qat,比默认量化更省内存且质量损失更小。 - 做字段抽取、文本分类这类流水线活:270M 或 1B 足够,别用它们做问答。
- 新项目且硬件充裕:直接评估 Gemma 4,Gemma 3 更适合存量环境和老框架。
相关阅读:Llama 4 入门、Qwen3 入门、Gemma 3 模型页。
© 版权声明
文章版权归作者所有,未经允许请勿转载。