nano-banana-pro 是一个给 AI 编程助手用的图像生成 Skill(技能包)。装上之后,Claude Code、OpenClaw 这类 Agent 可以直接调用谷歌的 Gemini 3 Pro Image 模型(官方昵称 Nano Banana Pro)来画图、改图,或者把多张图合成一张。普通用户的用法很简单:在对话里用中文说清楚要什么图,助手会代为执行脚本,把生成好的 PNG 文件存到本地。
这个 Skill 的作者署名为 steipete,最早收录在开源 Agent 项目 OpenClaw 的技能目录里。本文介绍的版本来自第三方 Skill 市场 CocoLoop(并非官方商店),内容与 OpenClaw 仓库中的原版一致:一份 SKILL.md 说明文件加一个 Python 脚本,总共不到 10 KB。
Skill 与模型的关系
理解 nano-banana-pro,先要分清两层东西。底层的 Nano Banana Pro 是谷歌的图像模型,正式名称是 Gemini 3 Pro Image,擅长根据上下文理解生成图片,并支持以对话方式修改已有图片。上层的 nano-banana-pro 只是一层很薄的封装,本身不含任何模型,作用是把“调用谷歌接口、传参数、存文件”这套流程写成固定脚本,再用 SKILL.md 告诉 AI 助手何时调用、怎么传参。
因此它的能力上限完全取决于谷歌模型,费用也按谷歌 API 的标准计。Skill 的价值在于省掉写调用代码的工作,让不懂编程的用户也能在 Agent 里直接出图。
三种核心用法
脚本名为 generate_image.py,通过 uv 运行(uv 是一款 Python 包管理工具,会自动安装脚本声明的依赖)。SKILL.md 里给出的三类命令如下,{baseDir} 代表 Skill 所在目录。
文字生成图片,默认输出 1K 分辨率:
uv run {baseDir}/scripts/generate_image.py --prompt "your image description" --filename "output.png" --resolution 1K单图编辑用 -i 传入原图,提示词写修改要求,例如换背景、改风格、补元素:
uv run {baseDir}/scripts/generate_image.py --prompt "edit instructions" --filename "output.png" -i "/path/in.png" --resolution 2K多图合成把多个 -i 叠在一起,最多支持 14 张输入图,适合把产品图、人物、场景拼进同一画面:
uv run {baseDir}/scripts/generate_image.py --prompt "combine these into one scene" --filename "output.png" -i img1.png -i img2.png -i img3.png需要固定画幅时再加 --aspect-ratio(简写 -a),比如竖版人像:
uv run {baseDir}/scripts/generate_image.py --prompt "portrait photo" --filename "output.png" --aspect-ratio 9:16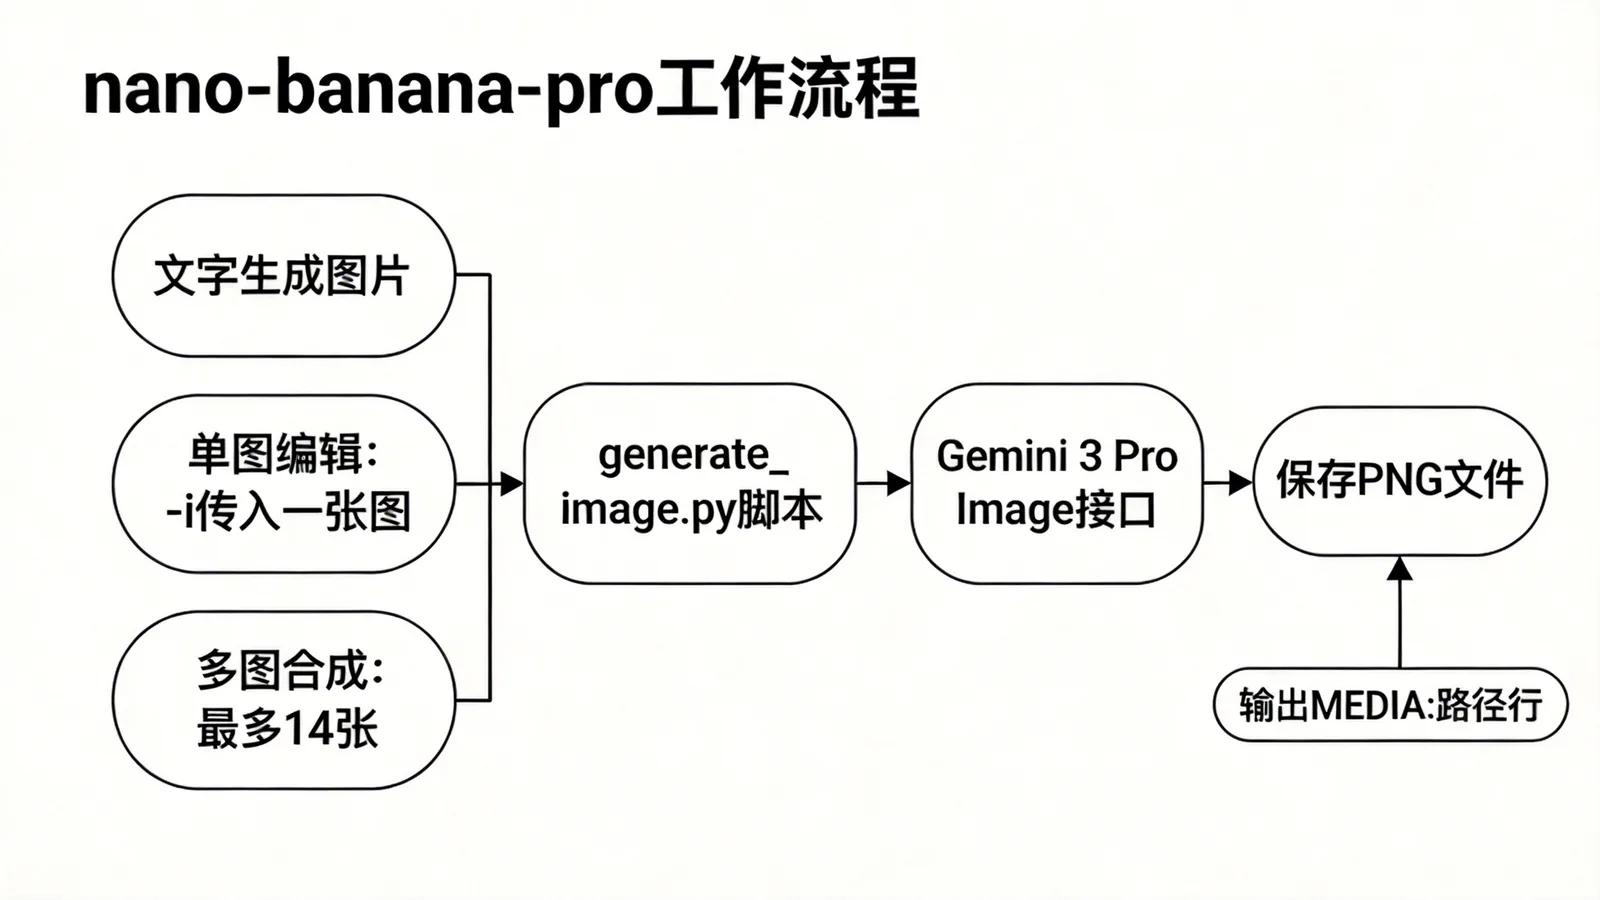
参数与输出细节
脚本的参数不多,完整列表如下:
--prompt/-p:图片描述或修改指令,必填。--filename/-f:输出文件名,必填,目录不存在时会自动创建。--input-image/-i:输入图片路径,可重复填写,超过 14 张会直接报错退出。--resolution/-r:1K、2K、4K 三档。--aspect-ratio/-a:可选 1:1、2:3、3:2、3:4、4:3、4:5、5:4、9:16、16:9、21:9,不填则由模型自行决定构图。--api-key/-k:临时指定密钥,优先级高于环境变量。
分辨率的默认规则值得单独说明。纯文字生图时默认 1K;带输入图且没有手动指定分辨率时,脚本会按输入图最长边自动推断:3000 像素及以上用 4K,1500 像素及以上用 2K,其余用 1K。手动写了 --resolution 就以手动值为准,这一点是 OpenClaw 在 2026 年 3 月的一次提交中修正的。
输出方面,脚本一律保存为 PNG,带透明通道的图会被铺上白底转成 RGB。保存成功后,脚本会额外打印一行 MEDIA: 加文件完整路径,OpenClaw 读到这一行会把图片作为附件发到所接入的聊天平台。SKILL.md 还给助手定了两条规矩:文件名建议带时间戳(格式为 yyyy-mm-dd-hh-mm-ss-name.png),出图后只报告保存路径,不要把图片读回对话。前一条可以避免同名文件被覆盖,因为脚本本身并不检查目标文件是否已存在;后一条能省下不少上下文。
安装与密钥配置
运行环境要求 Python 3.10 以上,脚本头部声明了两个依赖:
dependencies = [
    "google-genai>=1.0.0",
    "pillow>=10.0.0",
]
google-genai 是谷歌官方的 Gemini SDK,pillow 负责读写图片。只要装好 uv,第一次运行时依赖会自动装进隔离环境,不会污染系统 Python。macOS 用户可以用 Homebrew 安装 uv,这也是 SKILL.md 元数据里写明的安装方式。
密钥有两种配置方法。通用做法是设置环境变量 GEMINI_API_KEY;OpenClaw 用户也可以写进 ~/.openclaw/openclaw.json,对应字段为 skills."nano-banana-pro".apiKey 或 skills."nano-banana-pro".env.GEMINI_API_KEY。密钥在 Google AI Studio 申请。
在 Claude Code 里使用时,把整个 nano-banana-pro 文件夹放进 ~/.claude/skills/ 目录即可被识别。需要注意,{baseDir} 是 OpenClaw 的占位写法,其他 Agent 不一定会自动替换,稳妥的做法是在 SKILL.md 里把它改成脚本的实际路径。想让助手自己搜索并安装技能,可以参考站内的 find-skills 入门教程。
费用与国内使用条件
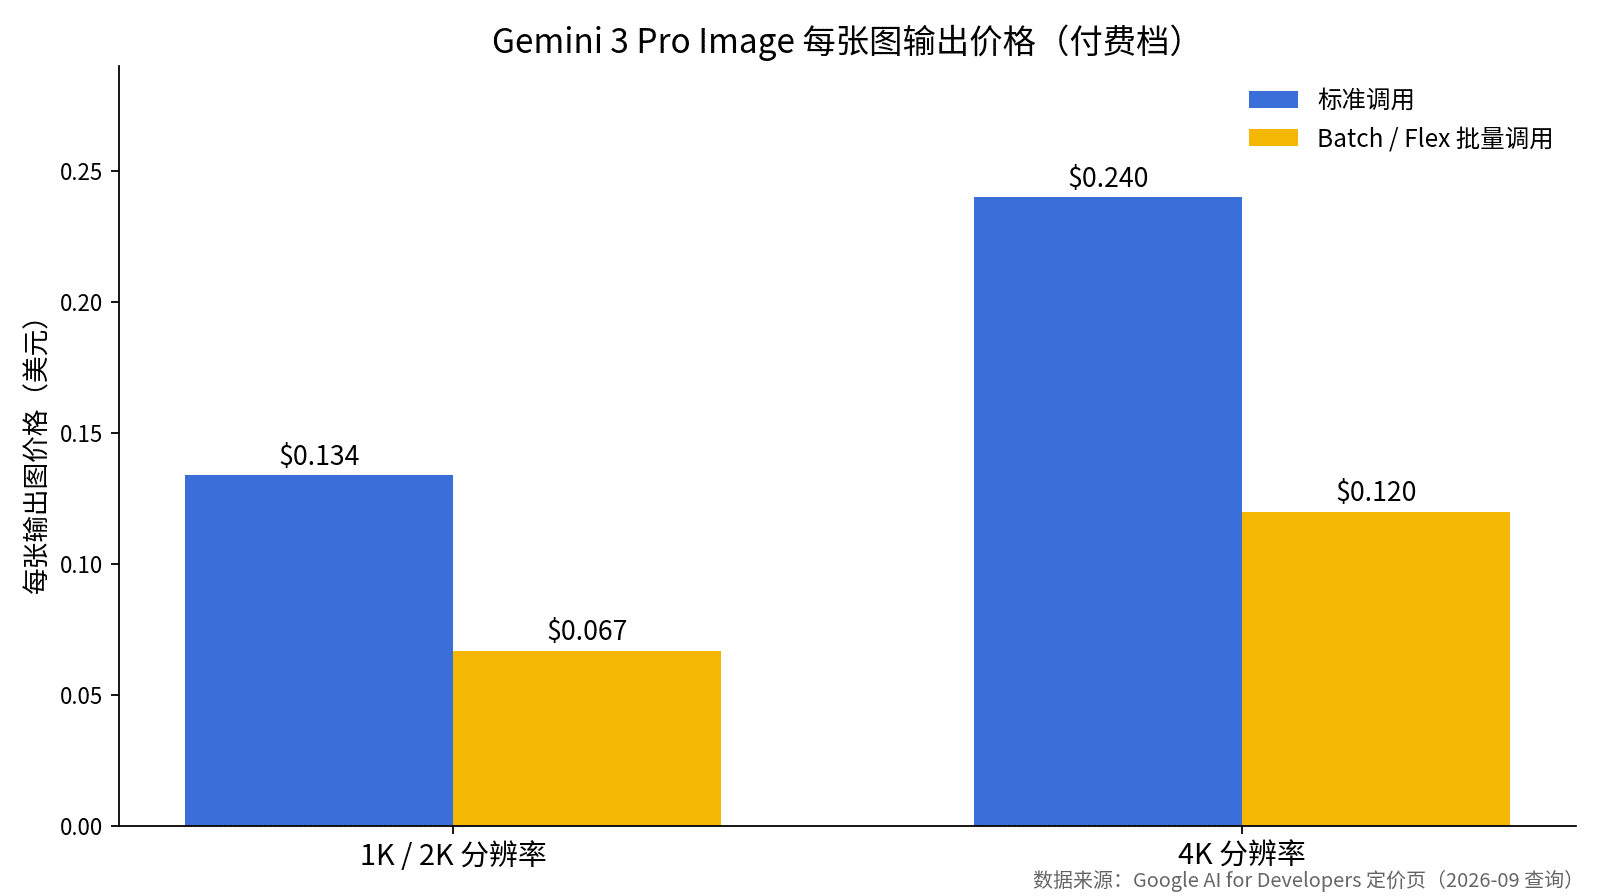
Gemini 3 Pro Image 的 API 没有免费额度,必须开通付费账户。按谷歌开发者文档的定价页,标准调用下 1K 和 2K 图每张约 0.134 美元,4K 图每张约 0.24 美元,按当前汇率约合人民币 0.95 元和 1.7 元;每张输入图另计约 0.0011 美元。对时效要求不高的批量任务走 Batch 或 Flex 通道,单价约为标准价的一半。按这个价格,日常配图用 1K 或 2K 足够,4K 留给印刷和大尺寸海报更划算。
国内使用有两道门槛。第一,Google AI Studio 和 Gemini API 在中国大陆无法直接访问,需要相应的网络环境;第二,付费账户需要绑定境外支付方式。这两点对个人用户并不轻松。国内的同类选择是字节跳动的 Seedream 系列图像模型,在豆包、即梦中可直接使用,也有火山引擎的 API,中文文字渲染表现稳定,更适合没有海外账户的团队。
适用人群与局限
这个 Skill 最适合已经在用 Claude Code、OpenClaw 等 Agent 处理日常工作、并且手上有 Gemini 付费密钥的用户,写文档、做演示稿时顺手让助手配图,省去在网页和终端之间来回切换。同样在 Agent 里扩展能力的思路,还可以参考站内介绍的 frontend-design Skill 和 copywriting Skill,前者负责界面设计,后者负责营销文案,与生图技能搭配可以覆盖一套落地页的主要产出。
局限同样明确。所有图片都要上传到谷歌服务器处理,涉及隐私或商业机密的素材不宜使用;编辑完全依赖提示词,做不了蒙版和像素级的局部修改;输出只有 PNG 一种格式;生成内容受谷歌使用政策约束,部分题材会被拒绝。CocoLoop 页面给该 Skill 标注了 S+ 安全等级,这是该平台自己的评估口径。从源码看,密钥只从参数或环境变量读取,依赖只有两个官方库,代码量也小,自行通读一遍只需几分钟。
另有两个版本变化需要留意。其一,OpenClaw 已在 2026 年 3 月把这个 Skill 从主仓库移除,改为内置原生图像生成能力,OpenClaw 新版用户直接用内置功能即可,nano-banana-pro 更适合 Claude Code 等其他 Agent。其二,脚本里写死的模型名是 gemini-3-pro-image-preview,而谷歌当前的定价页列出的模型 ID 为 gemini-3-pro-image;如果调用时报模型不存在,把脚本中 model= 一行改成官方文档当前给出的 ID 即可。谷歌模型页还列出了主打速度和低成本的 Nano Banana 2 系列,大批量出图的场景可以一并比较。
对只想体验模型效果、不打算接入 Agent 的用户,直接在 Gemini 应用里使用图像生成功能门槛更低,确认效果后再考虑通过 API 和这个 Skill 做自动化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。