Llama 4 是 Meta 在 2025 年 4 月发布的一代大模型,已经公开放出权重的有两个型号:Scout 和 Maverick。它们既能读文字也能看图片,日常拿来做问答、写作、代码辅助、长文档分析都没问题。和 ChatGPT、豆包这类产品不同的地方在于,Meta 把模型文件本身放了出来——你可以下载到自己的服务器上运行,也可以直接调用第三方托管好的接口,按用量付费。对绝大多数人来说,后一条路省事得多。
下面按「有哪些型号、怎么用上、许可证有什么限制、中文场景合不合适」四件事讲清楚。
已经放出权重的两个型号
Scout 和 Maverick 都采用混合专家架构(Mixture of Experts,简称 MoE)。这种架构可以理解成模型内部养了一批分工不同的「专家」网络,每处理一个词只唤醒其中少数几个,其余的暂时闲置。好处是计算量被压下来了,模型规模却能做得很大。
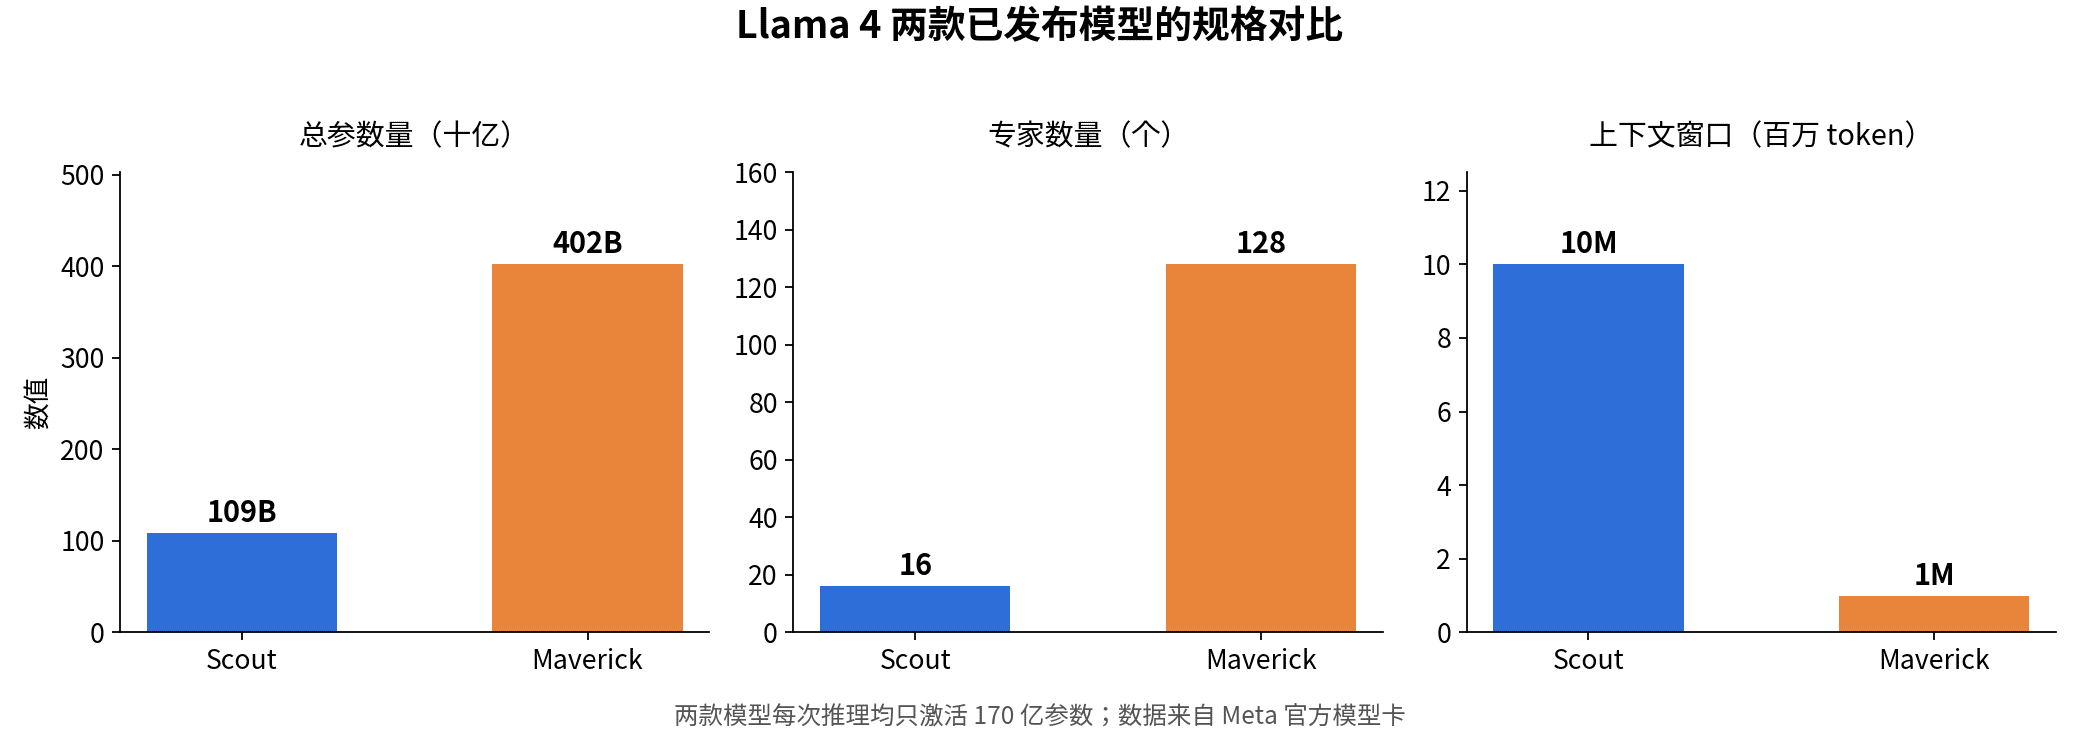
图:Scout 与 Maverick 的规格差异(数据来自 Meta 官方模型卡)
Scout 有 16 个专家、1090 亿总参数,每次推理激活 170 亿。它最突出的规格是 1000 万 token 的上下文窗口,在同代模型里属于顶格配置,整本技术手册或者几十万行日志可以一次性塞进去。
Maverick 把专家数量提到 128 个,总参数约 4020 亿,激活参数同样是 170 亿,上下文窗口 100 万 token。它是这一代里对标闭源旗舰的那一档,综合质量比 Scout 更高,代价是部署规模大了将近四倍。
两者共同的几项事实值得先记下来:原生多模态,支持文字和图片输入、文字输出;官方模型卡注明图像理解能力测试到 5 张输入图为止,超过这个数量属于未验证范围;训练数据截止到 2024 年 8 月,问 2025 年之后的事情必须自己配检索,否则回答不可信。
Behemoth 去哪了,Meta 现在在做什么
发布会上 Meta 还预告过第三个型号 Behemoth,超过 2 万亿参数,定位是给前两个型号做知识蒸馏的教师模型。它至今没有公开发布。2025 年 5 月起该模型的发布计划被推迟,此后 Meta 对 AI 部门做了大规模重组,成立 Meta Superintelligence Labs,并在 2026 年 4 月推出闭源的 Muse Spark 接替 Llama 承担自家产品里的对话能力。
连带的一个变化是入口。原来的 llama.com 现在会 301 跳转到 developer.meta.com/ai/,文档和下载入口都搬到了 Meta 的开发者站点下。老链接暂时还能自动跳过去,收藏夹里存的地址建议更新一下。
这些变动对已经放出的权重没有影响——Scout 和 Maverick 的文件还在,许可条款也没变。但把 Llama 4 当成一条会持续迭代的技术路线来规划,眼下缺少足够的依据。Meta AI 开发者站点上关于下一代开源模型的公开信息仍然是空白。
三条上手路径怎么选
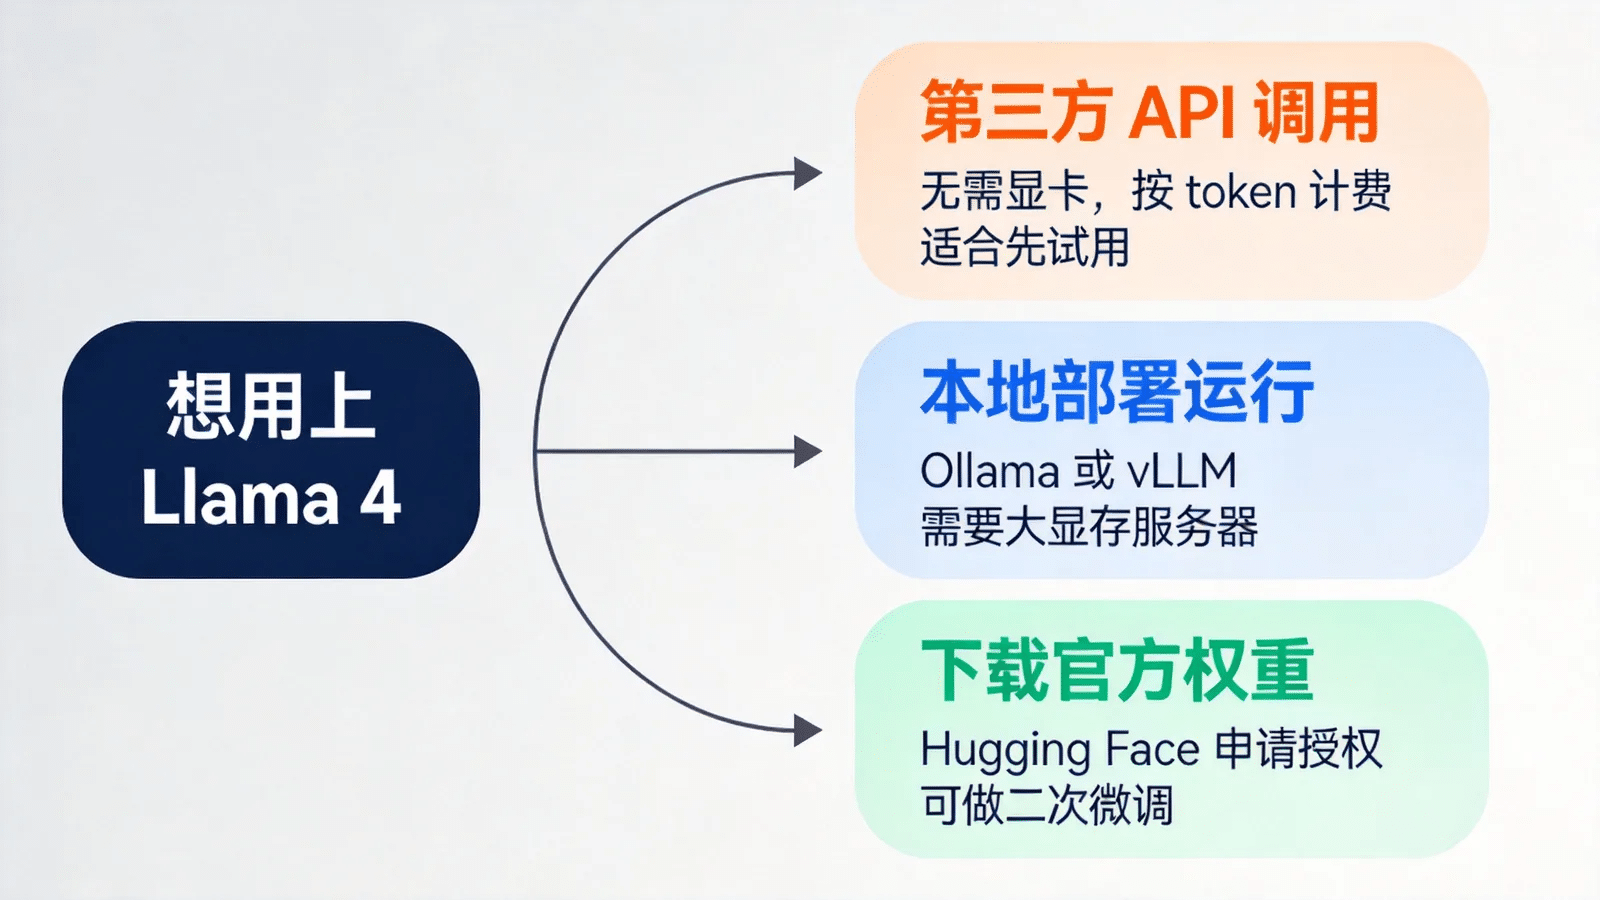
图:三条上手路径各有取舍
调第三方 API:最快见效
Meta 自己不直接零售 Llama 的调用额度,市面上提供服务的是各家托管平台。价格差异不小,公开的价格聚合数据给出的区间大致是:Scout 每百万输入 token 约 0.08 美元、输出约 0.30 美元;Maverick 对应 0.20 美元和 0.60 美元。按当前汇率换算,Scout 约合 0.57 元和 2.1 元,Maverick 约合 1.4 元和 4.3 元,属于同规模模型里偏低的一档。具体报价以所选平台当日公示为准,聚合站的数字会滞后。
这些平台多数在境外,从国内直连需要相应的网络环境;国内几家云厂商也上架过 Llama 系列,如果项目要走合规采购,优先看国内云的模型市场。
本地跑:先算清楚硬件账
Ollama 已经收录了这一代模型,命令很短:
ollama pull llama4:scout
ollama run llama4:scout
Maverick 换成 llama4:maverick 即可。需要留意的是体积——Ollama 官方库标注的下载量是:16x17b(对应 Scout)67GB,128x17b(对应 Maverick)245GB。
这里有个常见误解需要澄清。「只激活 170 亿参数」说的是每次推理的计算量,不是加载量。所有专家的权重都必须驻留在显存或内存里,随时准备被路由选中。所以 Scout 的门槛是几十 GB 级别的显存,多卡服务器或者大内存的 Mac Studio 才谈得上流畅,普通消费级单卡跑不动。网上流传的「12GB 显存跑 Llama 4」之类说法,与官方发布的模型体积对不上。
要做生产环境的推理服务,vLLM 和 SGLang 对这一代 MoE 的支持更成熟,吞吐和显存利用率都比 Ollama 好一截,Ollama 更适合本地试玩和小规模验证。
下载权重:要自己微调才有必要
官方权重托管在 Hugging Face 的 meta-llama 组织下,仓库名分别是 meta-llama/Llama-4-Scout-17B-16E-Instruct 和 meta-llama/Llama-4-Maverick-17B-128E-Instruct,后者另有一个 FP8 量化版本便于降低部署成本。下载前需要在页面上接受许可协议并提交申请,审核通过后才能拉取文件。
如果只是想用模型的能力,这条路没必要走;它的价值在于可以做继续预训练、领域微调、蒸馏出小模型这些改造动作。
许可证里必须看清的几条
Llama 4 用的是 Meta 自订的 Llama 4 Community License Agreement,不是 Apache 2.0 或 MIT 那类标准开源协议,开放源代码促进会(OSI)也不承认它属于开源许可。准确的说法是「权重可获取」。以下三条对实际使用影响最大:
- 月活 7 亿的红线:如果你的产品或服务在协议生效日的月活跃用户超过 7 亿,需要单独向 Meta 申请授权,Meta 有权自行决定是否批准。这条对大多数团队是纸面条款,但收购、并表之后用户量跨线的情况需要提前评估。
- 命名与署名:基于 Llama 4 训练出来的衍生模型,名称必须以「Llama」开头;分发时要在显著位置附上指定的版权声明,原文是
Llama 4 is licensed under the Llama 4 Community License, Copyright © Meta Platforms, Inc. All Rights Reserved. - 欧盟被排除在外:协议明确写明,对于 Llama 4 中的多模态模型,授权不给予居住在欧盟的个人,也不给予主营业地在欧盟的公司。普遍认为这与欧盟《人工智能法案》的合规义务有关。国内团队自用不受影响,但如果产品要在欧洲落地或者在欧洲设有实体,这条需要交给法务确认。
中文场景适不适合
这是中文用户最该先确认的一点。官方模型卡列出的支持语言是 12 种:阿拉伯语、英语、法语、德语、印地语、印尼语、意大利语、葡萄牙语、西班牙语、他加禄语、泰语、越南语——中文不在列表里。许可条款里还有一条要求,不得在官方声明支持范围之外的语言上部署。
实际测试中它能读写中文,Llama 系列历来如此,但中文语料在训练配比里的分量明显低于英语,成语理解、公文语体、中文长文写作这些任务上的表现不如同档国产模型稳定。中文为主的业务,同等投入下 Qwen3 系列、DeepSeek V3、GLM-4.5 是更稳妥的选择,许可条款也宽松得多。长上下文需求可以对比 Kimi K2,模型页收在 Qwen3 模型档案里可以顺手查规格。
一句话选型
没有硬性理由的话,先用第三方 API 调 Scout 试一轮,成本低、上下文长、不用碰硬件。质量不够再换 Maverick,仍然不够就说明需求超出了这一代开源模型的能力范围。要在本地部署,先按 67GB 这个数字核对手上的机器再动手。中文为主的项目跳过 Llama 4,直接看国产开源模型。要研究 MoE 架构或者做领域微调,Scout 的规模和文档完整度适合当入门标本。
© 版权声明
文章版权归作者所有,未经允许请勿转载。