Kimi K2 是月之暗面(Moonshot AI)在 2025 年 7 月开源的大语言模型,和国内用户熟悉的 Kimi 聊天助手出自同一家公司。它能聊天、写代码、解数学题,最突出的长处是会用工具:给它接上搜索、代码执行、文件读写这类外部工具,它可以自己判断下一步该做什么、该调用哪个工具,把一件多步骤的任务做完。模型权重公开,任何人都能免费下载。普通用户现在想用上 K2,比较现实的办法是通过 OpenRouter 这类第三方平台调用,或者下载权重自行部署。月之暗面官方 API 已在 2026 年 5 月下线 K2 系列,这一变化直接影响使用方式,下文单独说明。
模型规模与架构
K2 采用 MoE(Mixture of Experts,混合专家)架构,总参数 1 万亿,每处理一个 token 只激活其中 320 亿。模型内部一共有 384 个专家网络,每次挑出 8 个参与计算,另有 1 个共享专家始终参与。总参数决定模型能容纳多少知识,激活参数决定每次推理要花多少算力,K2 借助这种结构,在万亿规模下把单次计算量控制在 300 亿参数级别。
其余关键配置如下:
- 层数 61 层,其中 1 层为稠密层;注意力隐藏维度 7168,每个专家的隐藏维度 2048,注意力头 64 个;
- 注意力机制为 MLA,激活函数为 SwiGLU,词表大小 16 万;
- 首发版上下文长度 12.8 万 token,9 月更新版扩展到 25.6 万 token。
K2 的配置文件里,模型结构登记为 DeepseekV3ForCausalLM,也就是沿用了 DeepSeek V3 的模型实现框架。两者同为 MLA 注意力加细粒度 MoE 的路线,不同在于规模:DeepSeek V3 总参数 6710 亿、激活 370 亿,K2 总量更大、激活量略小、专家数更多。对部署者来说,熟悉 DeepSeek V3 部署流程的团队迁移到 K2 的成本相对较低。
训练层面,K2 在 15.5 万亿 token 上完成预训练。月之暗面把自研的 Muon 优化器首次推到万亿参数规模,并针对放大后出现的不稳定问题改进出 MuonClip,官方称整个预训练过程没有出现训练不稳定。这部分对使用者属于背景信息,关心底层细节的读者可以阅读官方技术报告(arXiv 编号 2507.20534)。
版本构成:从 Base 到 Thinking
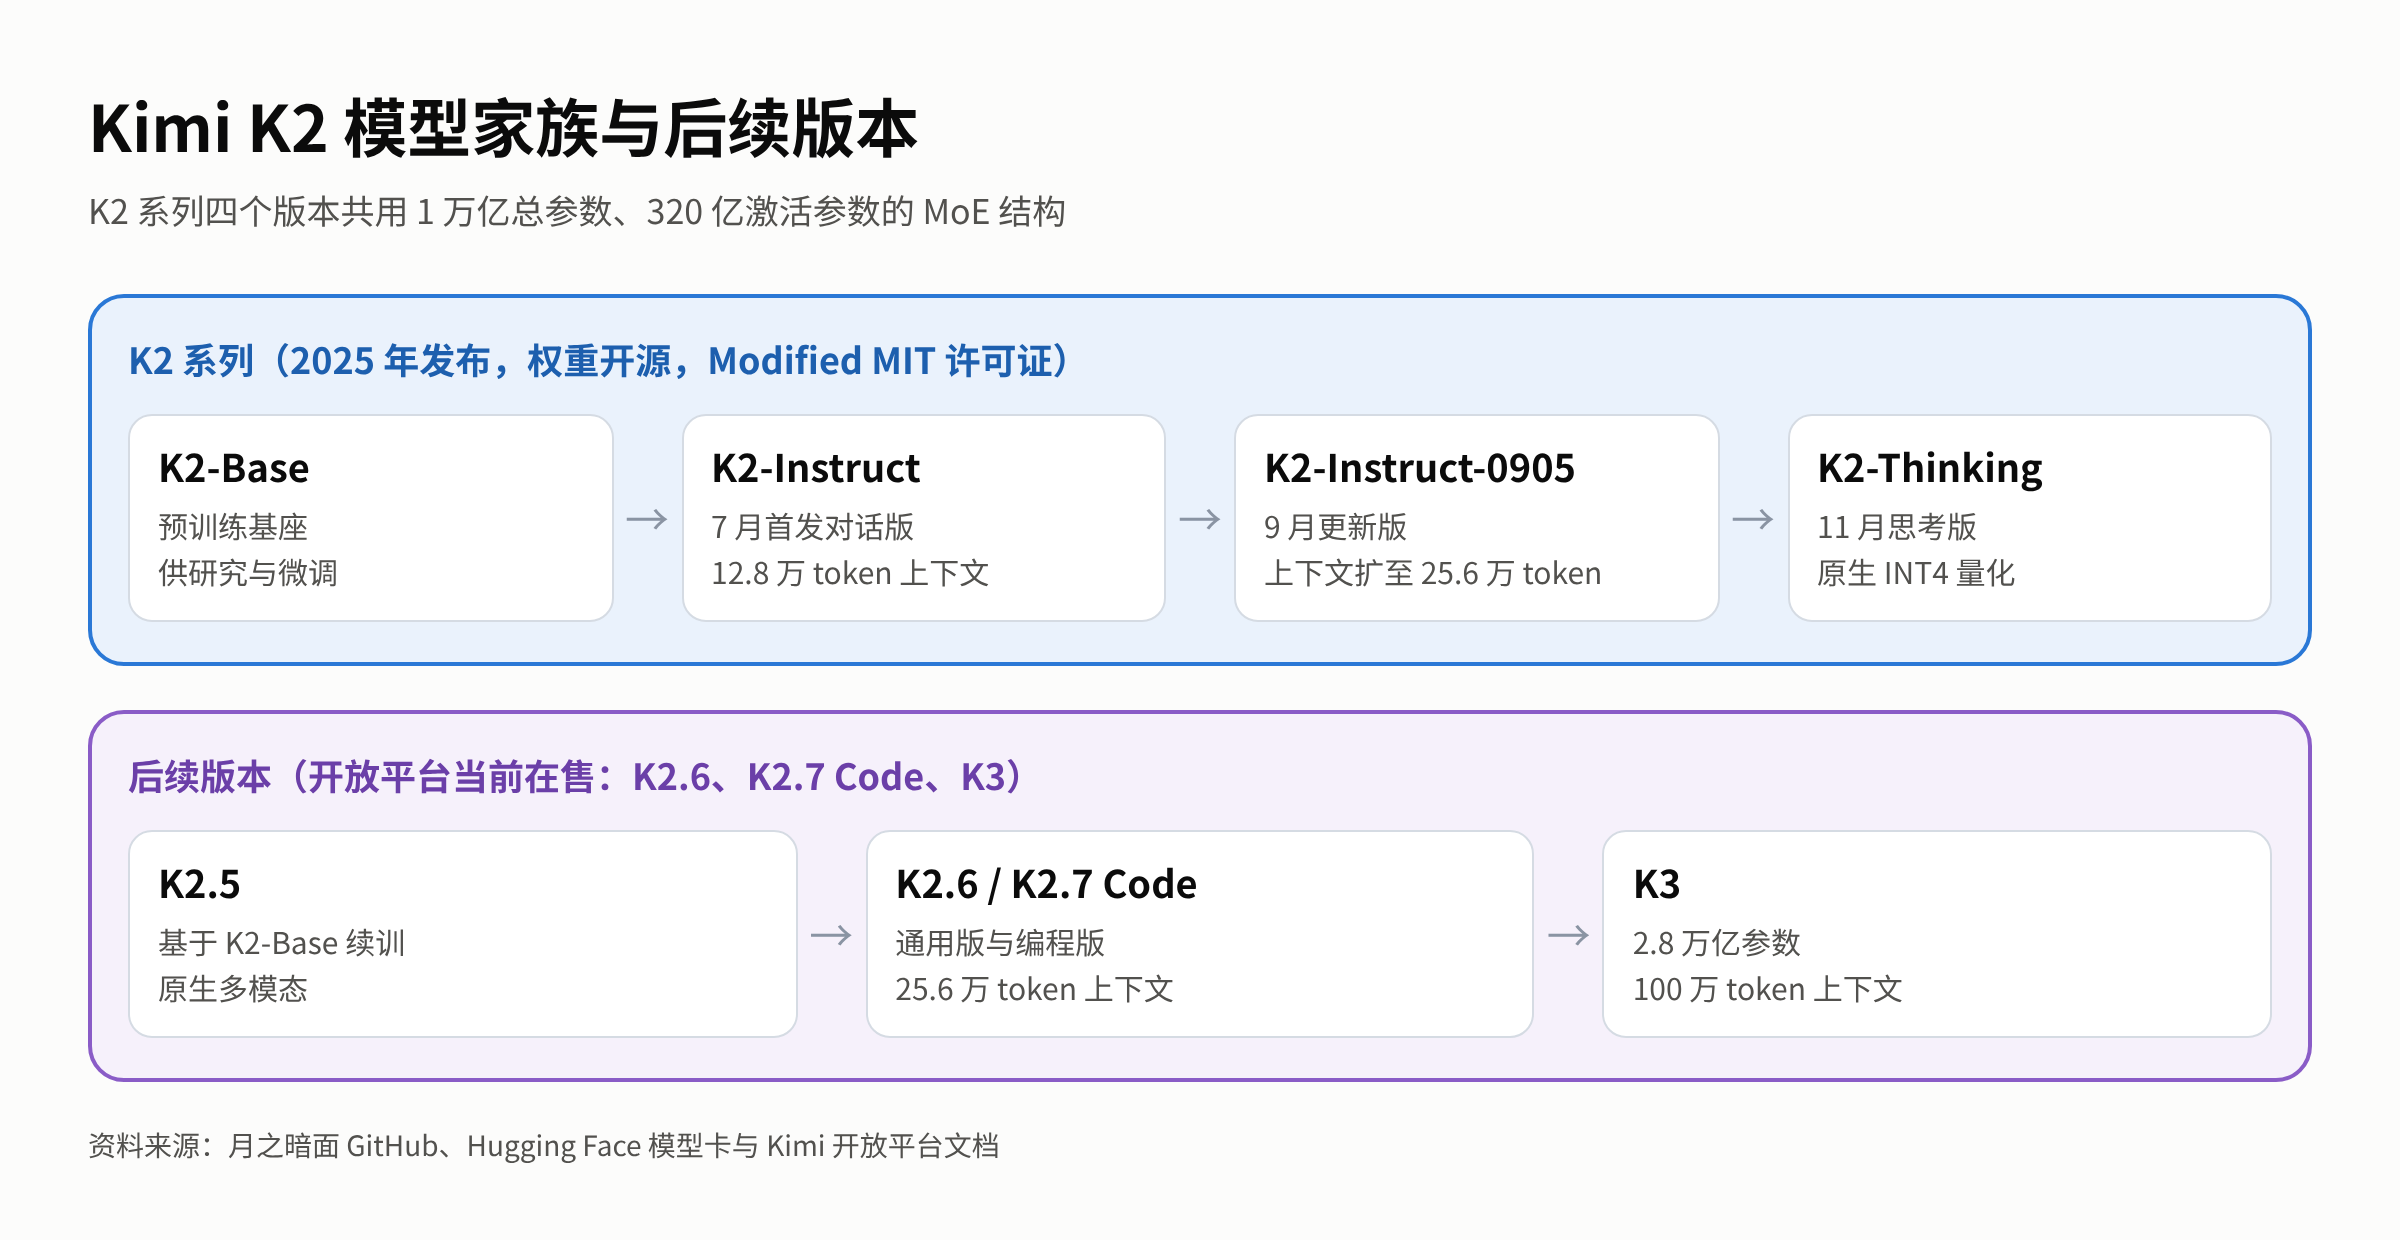
图:Kimi K2 系列四个开源版本与后续迭代,据官方 GitHub 与 Hugging Face 资料整理
K2 系列前后放出四个版本,规模和架构相同,差别在训练阶段和用途。
Kimi-K2-Base 是只做过预训练的基座模型,没有经过对话调优,面向需要完全掌控微调过程的研究者和开发者。普通用户直接拿它聊天效果不好,可以跳过。
Kimi-K2-Instruct 是 7 月的首发对话版。官方把它定位为”反射型”模型,收到问题直接作答,不做长时间思考,适合通用对话和智能体任务。
Kimi-K2-Instruct-0905 于 2025 年 9 月更新,官方称其为 K2 最强的版本。改进集中在三处:智能体编程的公开评测和真实任务表现明显提升,前端代码在美观度和实用性上更好,上下文从 12.8 万扩到 25.6 万 token。不需要深度推理的场景,0905 是 K2 系列里的首选。
Kimi-K2-Thinking 在 2025 年 11 月发布,是思考版。它会先一步步推理再作答,推理过程中还能穿插调用工具,官方称可以连续稳定调用工具 200 到 300 次,而此前的模型通常在三五十步之后就开始偏离目标。Thinking 版在后训练阶段做了量化感知训练,原生以 INT4 精度发布,权重体积约 600GB,明显小于 FP8 格式的 Instruct 版。
K2 之后,月之暗面又推出了基于 K2-Base 续训的原生多模态模型 K2.5,以及 K2.6、面向编程的 K2.7 Code 和 2.8 万亿参数的 K3。了解 K2 仍有价值,后续几代模型都建立在这套技术路线上。不过新接入的项目更适合直接评估 K2.6 或 K3。
能力表现与评测数据
首发时,官方把 K2-Instruct 与 DeepSeek-V3-0324、Qwen3-235B-A22B(非思考模式)、Claude Sonnet 4、Claude Opus 4(均未开启扩展思考)、GPT-4.1、Gemini 2.5 Flash 放在一起比较,评测覆盖编程、工具调用、数学与理工、通用知识四类。几项代表性数据如下:
- 编程:LiveCodeBench v6 得分 53.7,高于表中所有对比模型;SWE-bench Verified 在配备 bash 和编辑器工具、单次提交的条件下达到 65.8%,并行采样多条结果再择优时为 71.6%,同条件下 Claude Sonnet 4 分别为 72.7% 和 80.2%;
- 工具调用:Tau2 电信场景 65.8,领先对比组,零售与航空场景则低于 Claude Opus 4;
- 数学:AIME 2024 为 69.6,MATH-500 为 97.4,均为表中最高;
- 通用与指令遵循:IFEval 89.8、MMLU 89.5,SimpleQA 31.0 低于 GPT-4.1 的 42.3。
基座模型方面,K2-Base 与 DeepSeek-V3-Base、Qwen2.5-72B、Llama 4 Maverick 对比,在 MMLU、EvalPlus、MATH 等多数项目领先,中文评测 C-Eval 得分 92.5。官方说明,指令模型的评测输出长度统一限制在 8K token,只有 SWE-bench Verified 的无智能体测试放宽到 16K。
0905 版主要补强编程智能体能力,官方给出的对比数据如下图。其中 SWE-Bench 多语言版提升最明显,从 47.3 升到 55.9。
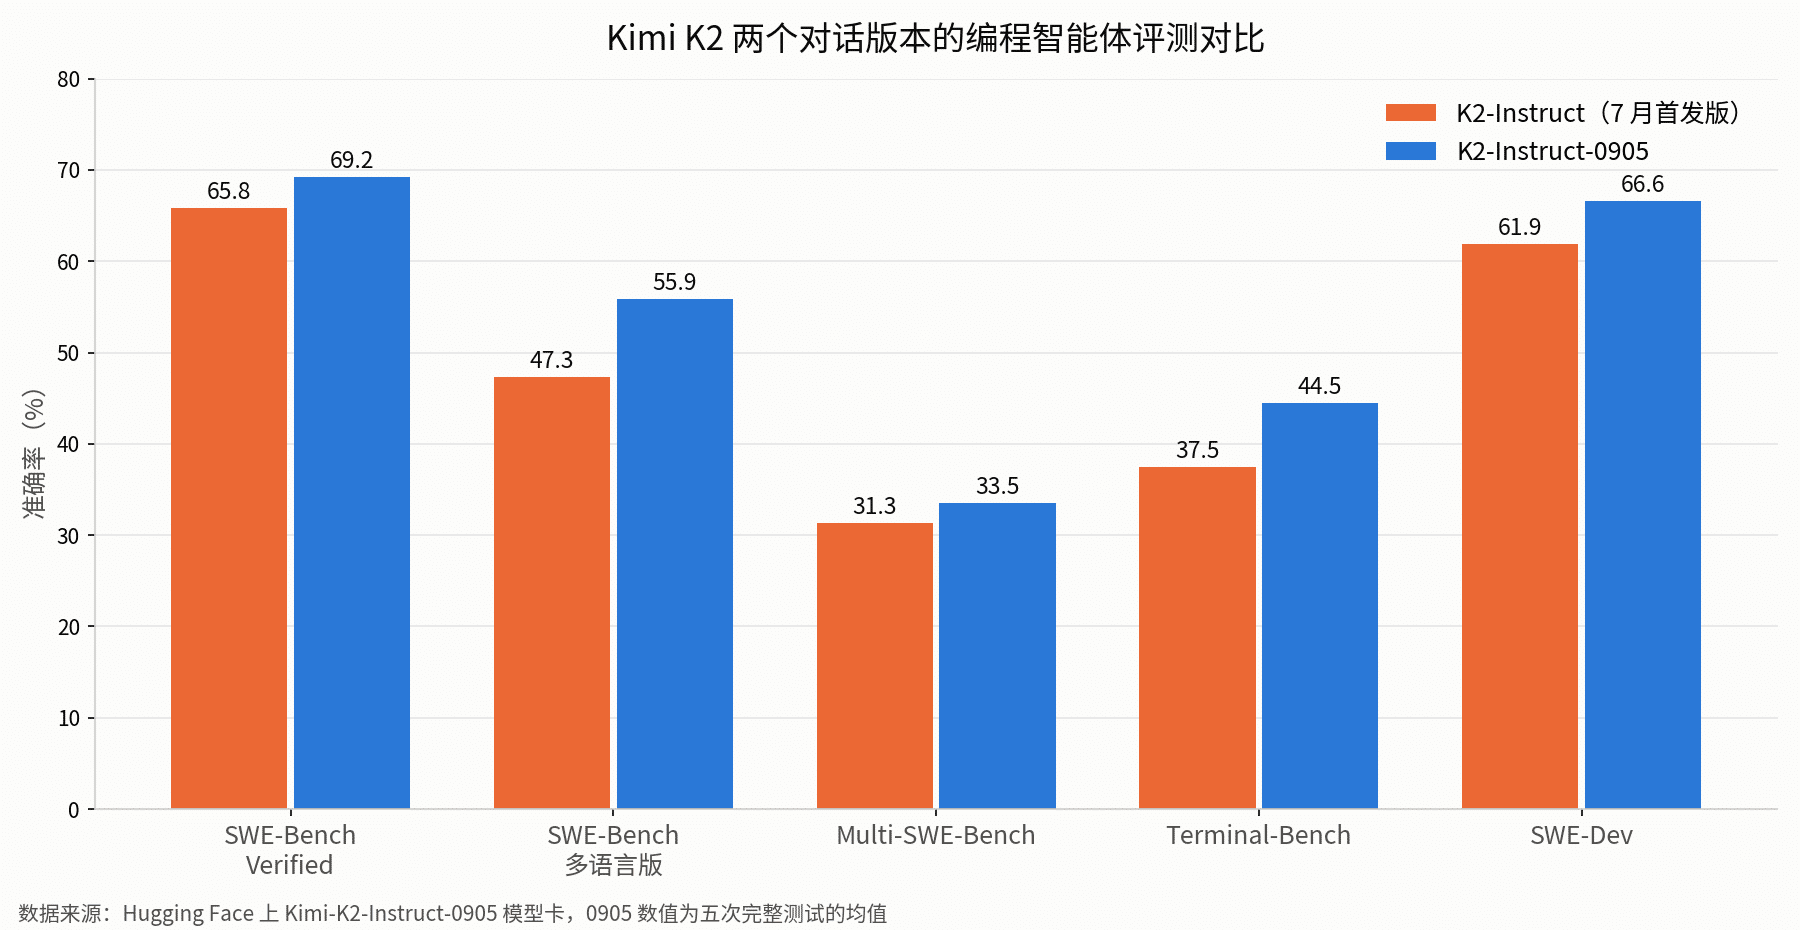
图:K2 首发版与 0905 版在五项编程智能体评测上的得分,按官方模型卡数据绘制
这些数据的对比对象停留在 2025 年年中,当时 K2 处于开源模型第一梯队,在编程和工具调用上与同期闭源旗舰差距不大。放到 2026 年,模型迭代已经过去好几代,榜单数字更适合用来理解 K2 的能力侧重,不宜作为今天选型的直接依据。
使用路径:官方 API 下线之后
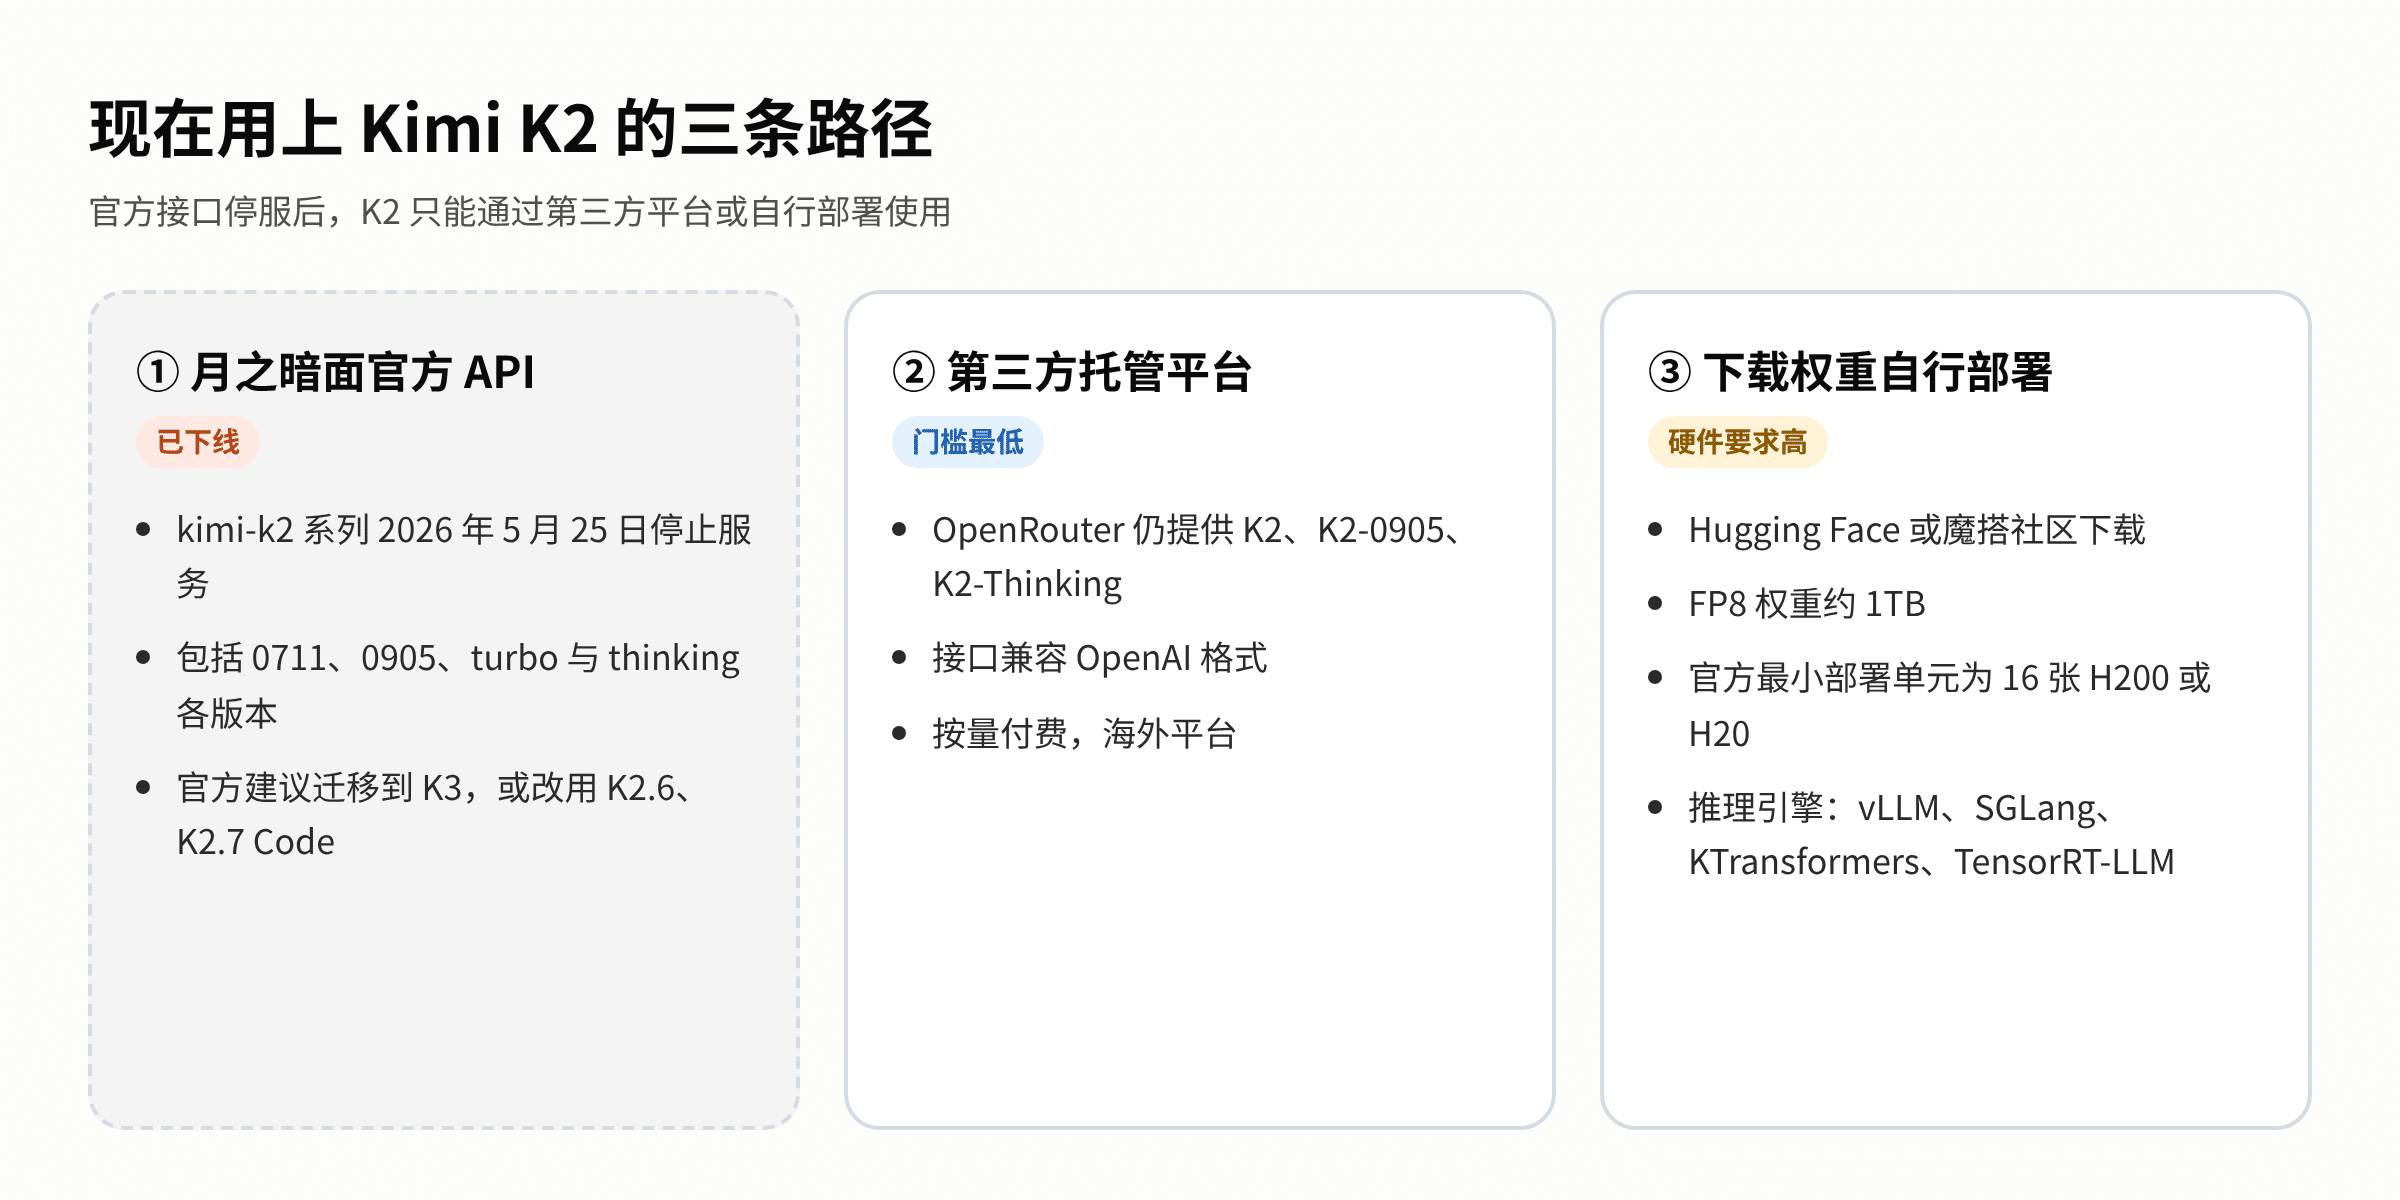
图:官方接口停服后,Kimi K2 的三种使用方式
官方 API 已停止服务
据 Kimi 开放平台文档,kimi-k2 系列模型已于 2026 年 5 月 25 日下线,涉及 kimi-k2-0905-preview、kimi-k2-0711-preview、kimi-k2-turbo-preview、kimi-k2-thinking 和 kimi-k2-thinking-turbo 五个接口,官方建议迁移到 K3。开放平台目前在售的是 kimi-k3、kimi-k2.7-code(含高速版)和 kimi-k2.6,官网标价以人民币计:K2.6 每百万 token 输入 6.5 元(缓存命中 1.1 元)、输出 27 元,K3 输入 20 元、输出 100 元。平台在大陆可直接访问,接口同时兼容 OpenAI 和 Anthropic 格式。K2 在线期间,官方 Anthropic 兼容接口会把请求里的 temperature 乘以 0.6 再交给模型,迁移老代码时需要留意这一换算。
只想体验月之暗面模型能力的普通用户,直接使用 Kimi 网页版或 App 即可,不必专门寻找 K2。
通过第三方平台调用
截至发稿,OpenRouter 仍在提供 moonshotai/kimi-k2、moonshotai/kimi-k2-0905 和 moonshotai/kimi-k2-thinking 三个模型,接口兼容 OpenAI 格式。以 kimi-k2-0905 为例,发稿时的标价为每百万 token 输入 0.6 美元、输出 2.5 美元,按当前汇率约合人民币 4.3 元和 18 元,具体以平台实时价格为准。OpenRouter 是海外平台,充值需要海外支付方式,大陆网络下的访问稳定性也无法保证。第三方托管的模型随时可能下架,不适合作为长期生产依赖。
官方 README 给出的对话示例可以直接复用,只需把客户端指向 OpenRouter:
def simple_chat(client: OpenAI, model_name: str):
    messages = [
        {"role": "system", "content": "You are Kimi, an AI assistant created by Moonshot AI."},
        {"role": "user", "content": [{"type": "text", "text": "Please give a brief self-introduction."}]},
    ]
    response = client.chat.completions.create(
        model=model_name,
        messages=messages,
        stream=False,
        temperature=0.6,
        max_tokens=256
    )
    print(response.choices[0].message.content)
from openai import OpenAI
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="<你的 OpenRouter API Key>")
simple_chat(client, "moonshotai/kimi-k2-0905")官方推荐 Kimi-K2-Instruct 的 temperature 设为 0.6;没有特殊需求时,示例里的系统提示词就是合适的默认值。
工具调用是 K2 的强项。做法是在每次请求里传入可用工具列表,由模型自行决定何时调用、如何调用。官方示例以查询天气为例,展示了从用户提问到执行工具、回填结果的完整循环:
# Your tool implementation
def get_weather(city: str) -> dict:
    return {"weather": "Sunny"}

# Tool schema definition
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Retrieve current weather information. Call this when the user asks about the weather.",
        "parameters": {
            "type": "object",
            "required": ["city"],
            "properties": {
                "city": {
                    "type": "string",
                    "description": "Name of the city"
                }
            }
        }
    }
}]

# Map tool names to their implementations
tool_map = {
    "get_weather": get_weather
}

def tool_call_with_client(client: OpenAI, model_name: str):
    messages = [
        {"role": "system", "content": "You are Kimi, an AI assistant created by Moonshot AI."},
        {"role": "user", "content": "What's the weather like in Beijing today? Use the tool to check."}
    ]
    finish_reason = None
    while finish_reason is None or finish_reason == "tool_calls":
        completion = client.chat.completions.create(
            model=model_name,
            messages=messages,
            temperature=0.6,
            tools=tools,          # tool list defined above
            tool_choice="auto"
        )
        choice = completion.choices[0]
        finish_reason = choice.finish_reason
        if finish_reason == "tool_calls":
            messages.append(choice.message)
            for tool_call in choice.message.tool_calls:
                tool_call_name = tool_call.function.name
                tool_call_arguments = json.loads(tool_call.function.arguments)
                tool_function = tool_map[tool_call_name]
                tool_result = tool_function(**tool_call_arguments)
                print("tool_result:", tool_result)

                messages.append({
                    "role": "tool",
                    "tool_call_id": tool_call.id,
                    "name": tool_call_name,
                    "content": json.dumps(tool_result)
                })
    print("-" * 100)
    print(choice.message.content)
循环会一直执行,直到模型不再请求工具、给出最终回答为止。这段流程要求推理服务支持 K2 原生的工具解析逻辑;流式输出和手动解析工具调用的写法,见官方仓库 docs 目录下的工具调用指南。
下载权重自行部署
K2 各版本权重在 Hugging Face 上公开,Instruct 版以 block-fp8 格式存储,体积约 1TB。国内下载可以走魔搭社区的镜像,速度通常比直连 Hugging Face 稳定。
硬件门槛是自部署的最大障碍。官方部署指南写明,在主流的 H200 或 H20 平台上以 FP8 权重、12.8 万上下文运行 K2,最小部署单元是 16 张 GPU 组成的集群,可采用张量并行,也可采用”数据并行 + 专家并行”。这一门槛把个人用户基本排除在外,自部署只适合有集群资源、对数据留存有要求的团队。
官方推荐四个推理引擎:vLLM、SGLang、KTransformers 和 TensorRT-LLM。vLLM 需要 v0.10.0rc1 或更新版本,并行度不超过 16 时可以用纯张量并行启动,先在两台节点上启动 Ray:
# start ray on node 0 and node 1

# node 0:
vllm serve $MODEL_PATH \
  --port 8000 \
  --served-model-name kimi-k2 \
  --trust-remote-code \
  --tensor-parallel-size 16 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k2
其中 --tensor-parallel-size 16 在 GPU 超过 16 张时需要搭配流水线并行;--enable-auto-tool-choice 和 --tool-call-parser kimi_k2 是启用工具调用的必需参数,漏掉后模型无法正常调用工具。
SGLang 同样支持张量并行和”数据并行 + 专家并行”两种方式。以两台 H200 节点跑 TP16 为例:
# Node 0
python -m sglang.launch_server --model-path $MODEL_PATH --tp 16 --dist-init-addr $MASTER_IP:50000 --nnodes 2 --node-rank 0 --trust-remote-code --tool-call-parser kimi_k2

# Node 1
python -m sglang.launch_server --model-path $MODEL_PATH --tp 16 --dist-init-addr $MASTER_IP:50000 --nnodes 2 --node-rank 1 --trust-remote-code --tool-call-parser kimi_k2
KTransformers 走 CPU 与 GPU 混合推理的路线,是资源有限时相对可行的选择。它需要 GGUF 格式的权重,把原模型除 .safetensors 以外的配置文件全部复制到 GGUF 权重目录后启动:
python ktransformers/server/main.py --model_path /path/to/K2 --gguf_path /path/to/K2 --cache_lens 30000CPU 支持 AMX 指令集时,可以加上优化配置:
python ktransformers/server/main.py --model_path /path/to/K2 --gguf_path /path/to/K2 --cache_lens 30000 --optimize_config_path ktransformers/optimize/optimize_rules/DeepSeek-V3-Chat-fp8-linear-ggml-experts-serve-amx.yamlTensorRT-LLM 需要从源码编译 v1.0.0-rc2 版本,并通过 mpirun 做多节点推理,节点之间要配置免密 SSH;SGLang 大规模的预填充与解码分离部署(4 个预填充节点加 12 个解码节点)命令较长。这两部分完整步骤见官方仓库的 docs/deploy_guidance.md。官方也提示,推理引擎更新频繁,指南中的参数未必是最优配置,追求性能时应以各引擎主页的最新说明为准。
许可证:修改版 MIT
K2 的代码和模型权重都以 Modified MIT License 发布。条款主体与标准 MIT 协议一致,允许免费使用、修改、分发和商用,唯一新增的限制针对大型商业产品:如果基于 K2 或其衍生模型的商业产品或服务月活跃用户超过 1 亿,或月收入超过 2000 万美元(按当前汇率约合人民币 1.4 亿元),需要在产品界面上显著标注”Kimi K2″。绝大多数团队达不到这个规模,实际约束与 MIT 协议无异。相比之下,GLM-4.5 采用的是不带附加条款的标准 MIT 协议。
适用人群与选型建议
研究开源大模型技术路线的读者,K2 值得细读:万亿参数 MoE、Muon 优化器的大规模应用、面向智能体的训练方式,都在后续一批国产模型中得到延续。
想用 K2 做开发的个人开发者,OpenRouter 上的 kimi-k2-0905 是门槛最低的入口,适合做原型验证;需要长链推理和多轮工具调用的任务则选 kimi-k2-thinking。
要长期上线产品的团队,更稳妥的做法是直接接入月之暗面开放平台的 K2.6 或 K3,接口有官方维护,也有人民币计价和国内网络直连的便利。确有私有化部署需求、手里又有 16 卡以上集群的团队,K2 的开源权重和宽松许可证仍然有吸引力。
横向比较国产开源模型,可以参考站内的 Qwen3 入门、DeepSeek V3 入门指南 和 GLM-4.5 入门。K2 的官方资料集中在 GitHub 仓库,包括模型说明、部署指南和技术报告。
© 版权声明
文章版权归作者所有,未经允许请勿转载。