做视频翻译和多语言配音,在线平台按分钟计费是常态:Maestra、ElevenLabs 这类服务效果不错,但一个月多做几条视频,账单就能涨到几十甚至几百美元。Voice-Pro 提供了另一条路:把 YouTube 视频下载、人声分离、Whisper 字幕识别、多语言翻译和语音克隆打包成一个免费开源软件,装在自己电脑上运行,不限时长、不限次数。这个项目在 GitHub 上已积累超过 1.2 万个 star,代码以 GPL-3.0 许可证完全开放。
产品定位:一台电脑上的配音流水线
Voice-Pro 由韩国团队 ABUS 开发,界面是跑在浏览器里的 Gradio WebUI(网页操作界面),计算全部在本机完成。它覆盖的是外语视频汉化(或中文视频出海)的完整链条:给它一个 YouTube 链接或本地视频文件,软件自动下载、用 Demucs 分离人声和背景音、用 Whisper 生成带时间轴的字幕、翻译成目标语言,最后合成配音。全程不需要把素材上传到任何云端服务器,半成品和成品都留在自己硬盘上。
各环节用的都是当前的主流开源模型。语音识别可以在 Whisper、Faster-Whisper、Whisper-Timestamped 三种引擎之间切换,字幕和翻译支持 100 多种语言。语音合成的选择更多:Edge-TTS 提供 400 多个现成音色,kokoro 主打轻量高音质,F5-TTS、E2-TTS 和 CosyVoice 负责零样本语音克隆——给一段十几秒的参考音频,就能用这个人的音色朗读任意文字。原视频博主的声音直接开口说中文,靠的就是这一层能力,官方仓库还自带了一批名人参考音色,马斯克、MrBeast 都在列。
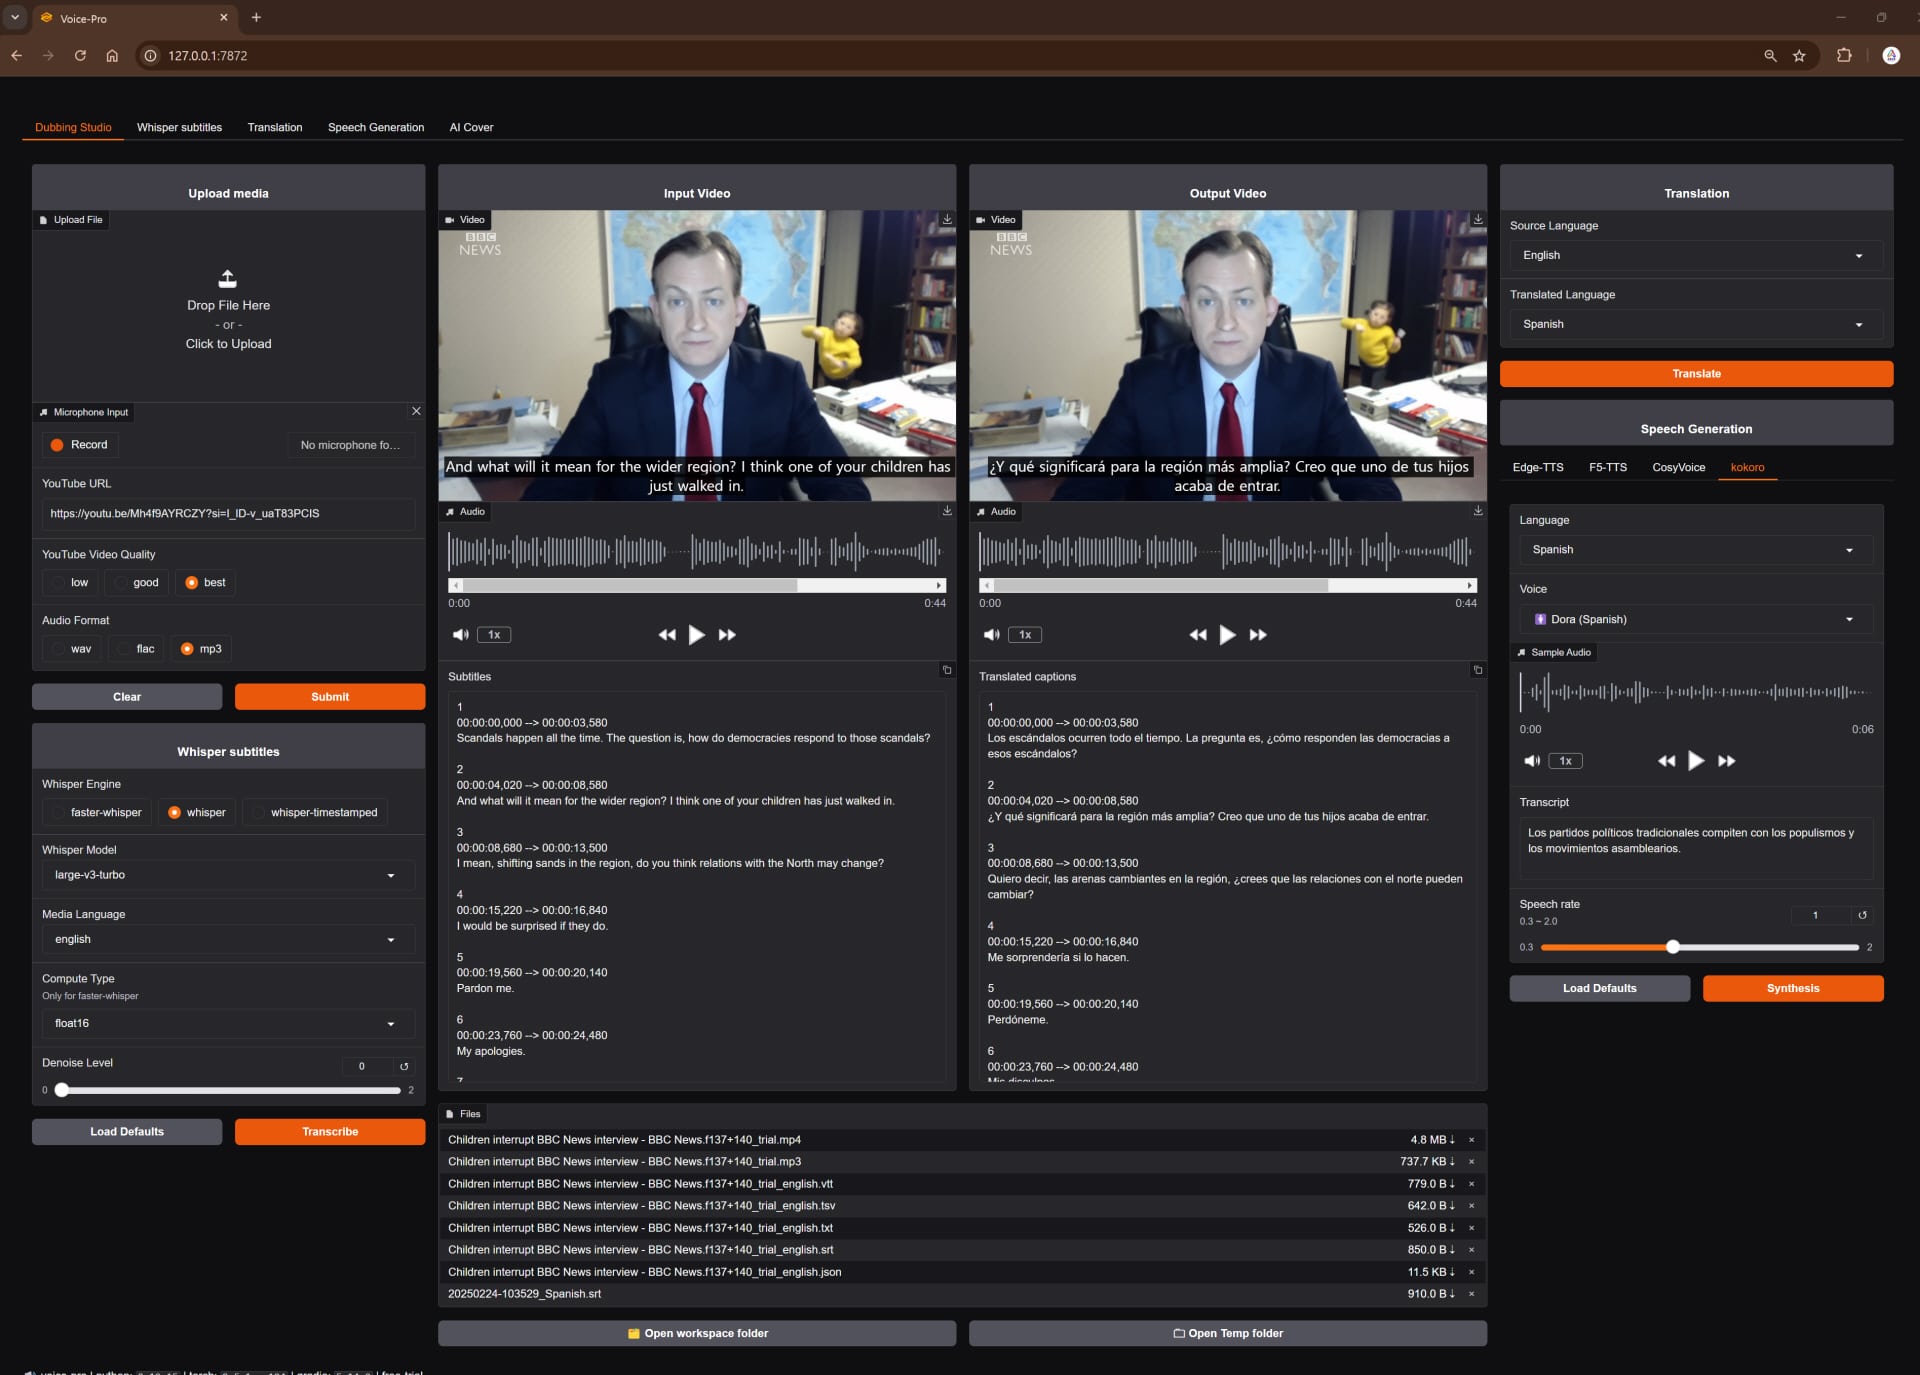
图:Voice-Pro 配音工作室界面,左侧填 YouTube 链接,中间对照原片与译制片,右侧完成翻译和配音(来源:官方仓库)
四个功能页签的分工
WebUI 按工序分成几个页签。Dubbing Studio(配音工作室)是主战场,从下载到出片的全流程都在这一页完成,输出支持 WAV、FLAC、MP3 和所有 ffmpeg 兼容的视频格式;Whisper Caption 专管字幕,支持 90 多种语言,能做词级高亮和降噪;Translate 页签除了翻译字幕文件(SRT、ASS 等格式直接导入),还能实时听译——播放一段英文新闻,字幕和译文同步滚出来;Speech Generation 负责纯语音生成,配好音色后可以直接产出多人对话式的播客音频。
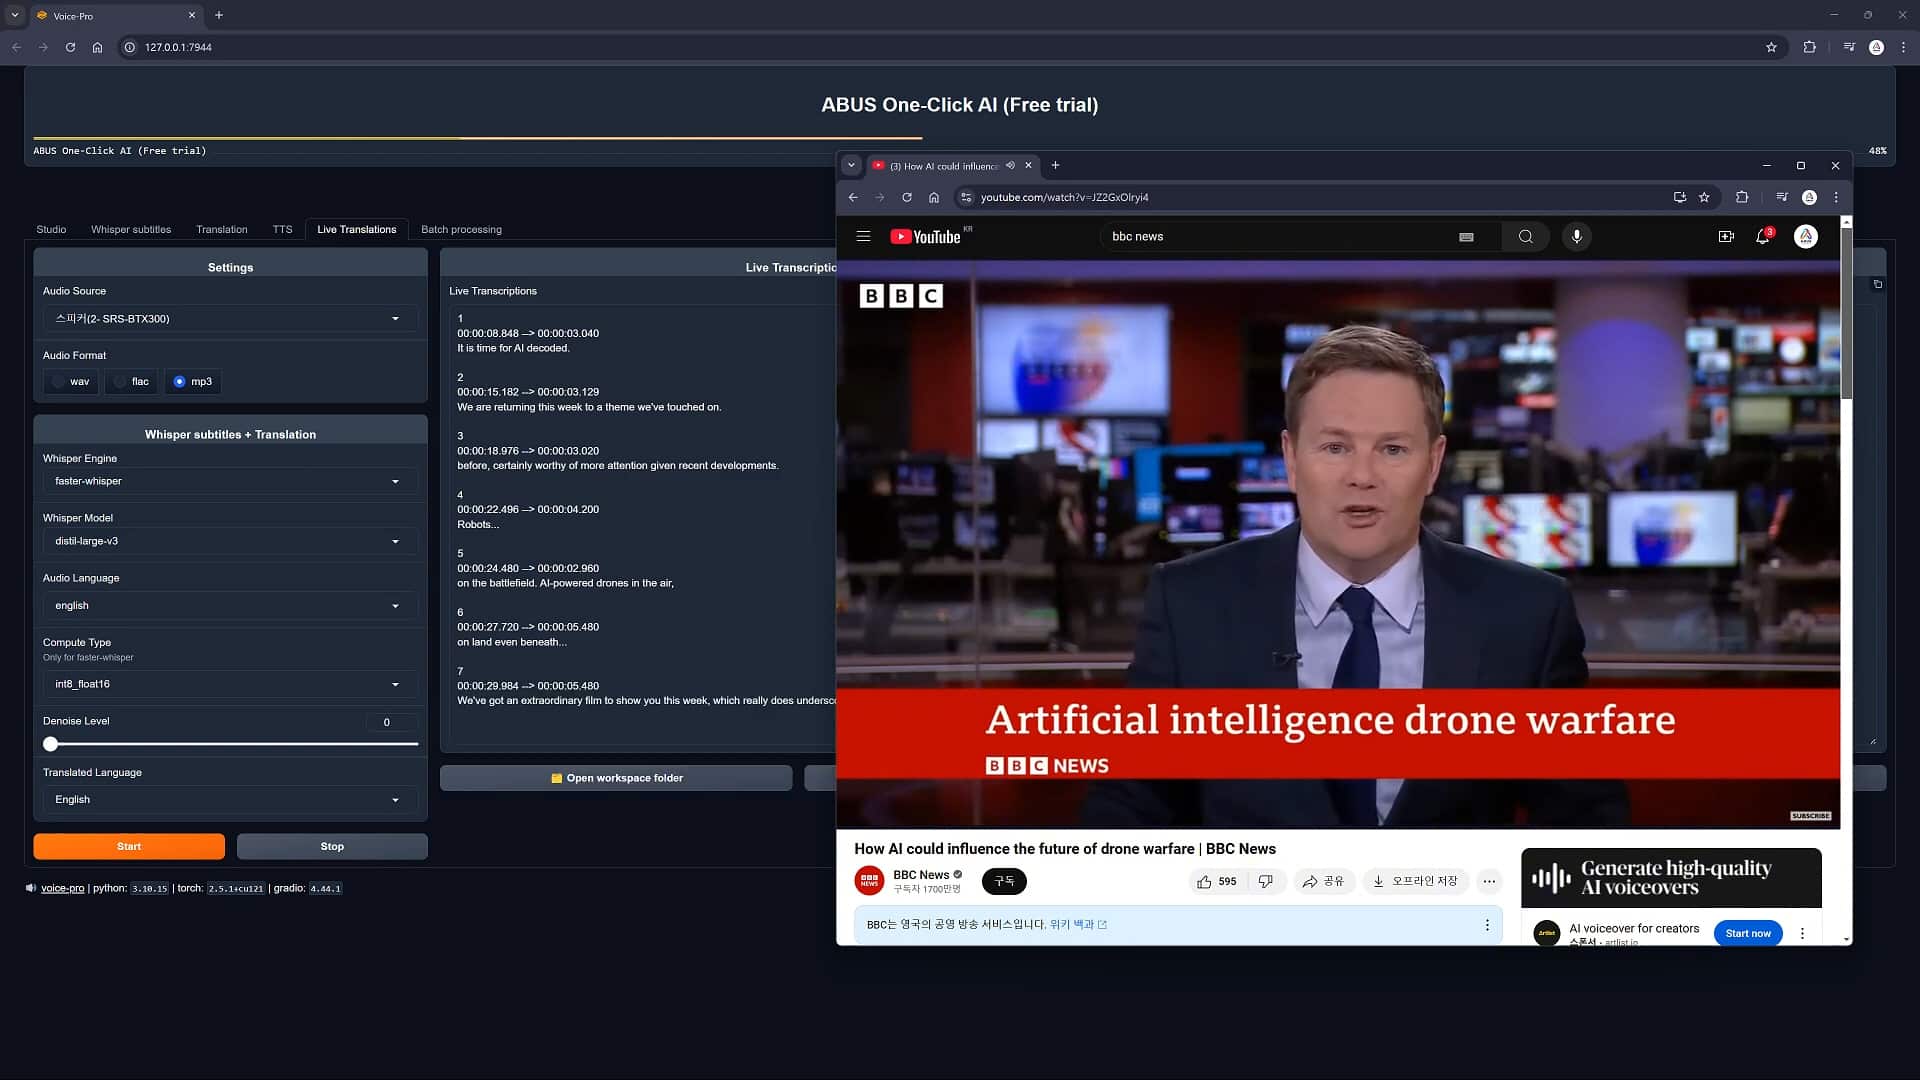
图:实时听译演示,左侧是识别加翻译的设置项,右侧播放 BBC 新闻,字幕逐句生成(来源:官方仓库)
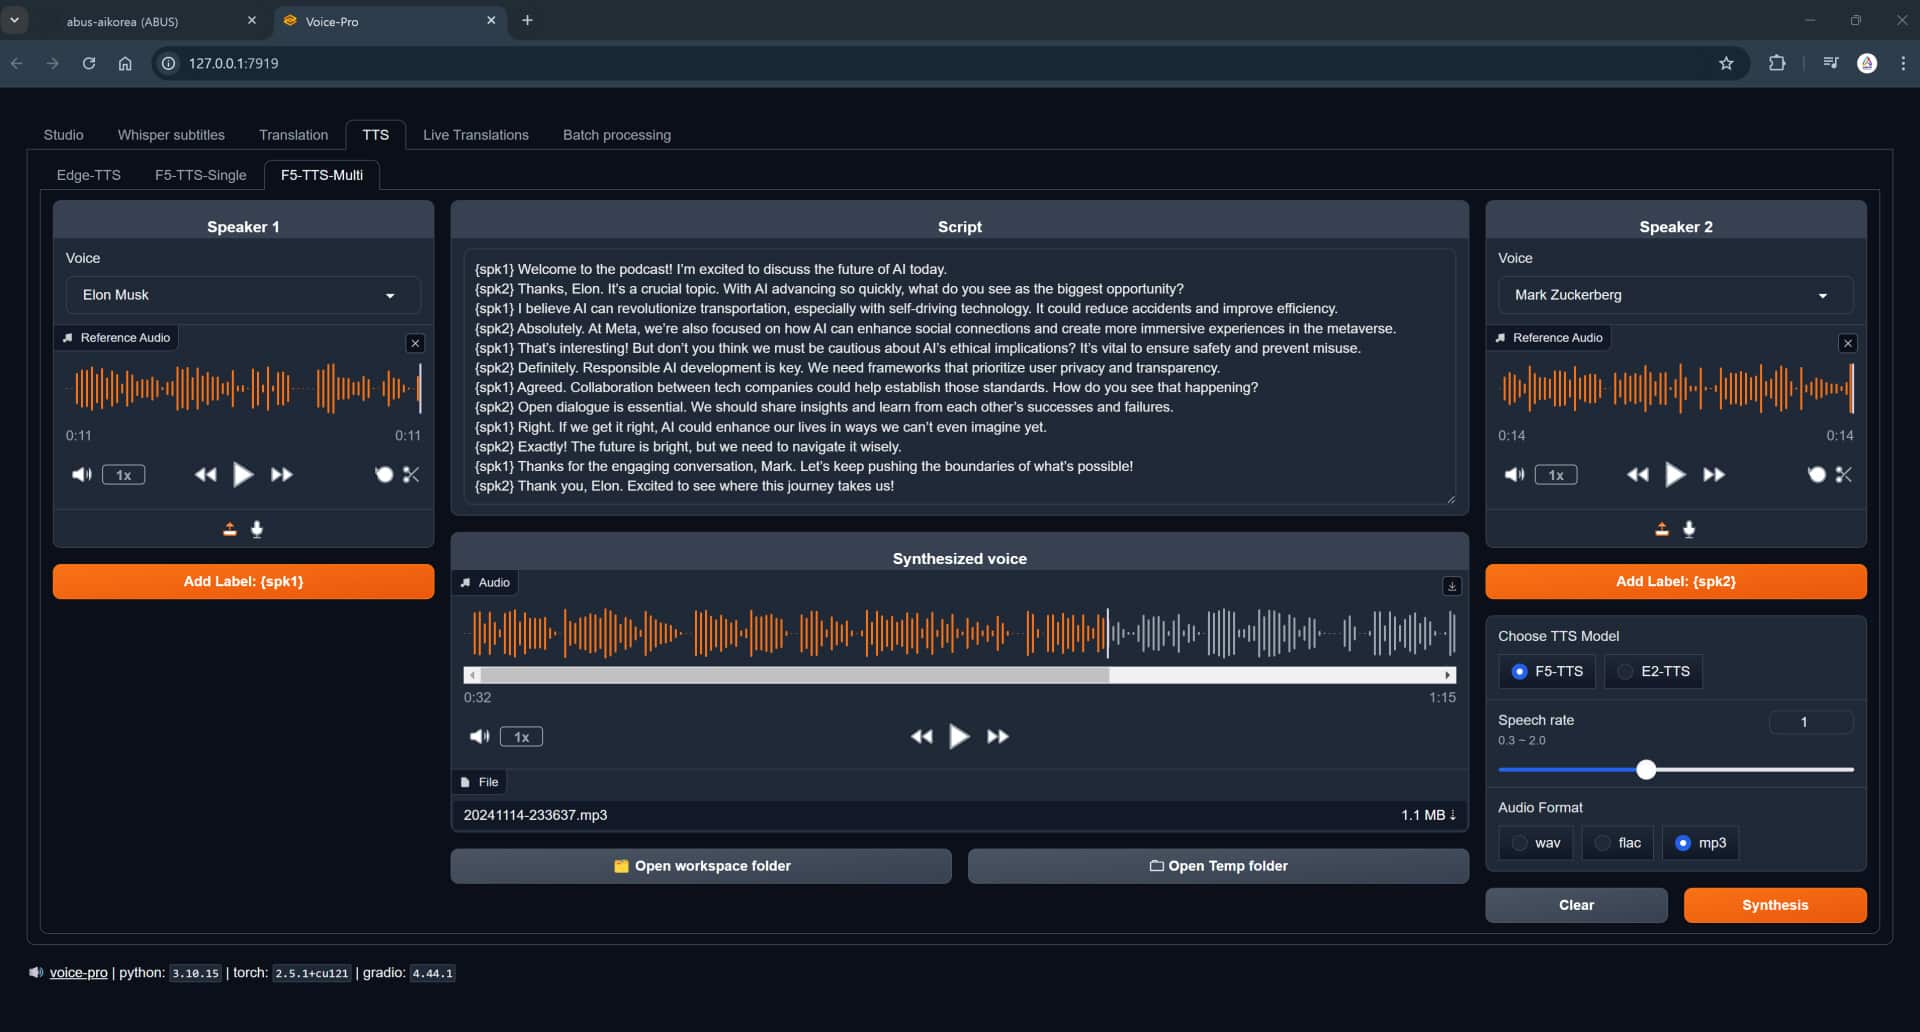
图:F5-TTS 多说话人模式,脚本里标注两个说话人,分别用不同的克隆音色朗读成一期播客(来源:官方仓库)
只需要字幕、不需要配音的场景,站内介绍过的 AI Video Transcriber 更轻量;如果目标是把 YouTube 视频批量搬运到 B 站,YTB2BILI 那套自动化流程可以和 Voice-Pro 互为参考。
成本账:省下的是按分钟计费的订阅
官方 README 里有一份横向比价:处理一条 60 分钟视频(字幕、翻译加配音),Maestra 收 23.70 美元,VEED.IO 约 24 到 36 美元(不含配音),Kapwing 约 30 到 40 美元,HappyScribe 要 36 到 48 美元——按当前汇率,一条视频折合人民币约 170 到 340 元。持续产出的话,每月订阅开销普遍落在 50 到 300 美元区间。Voice-Pro 这边除了电费,边际成本为零。
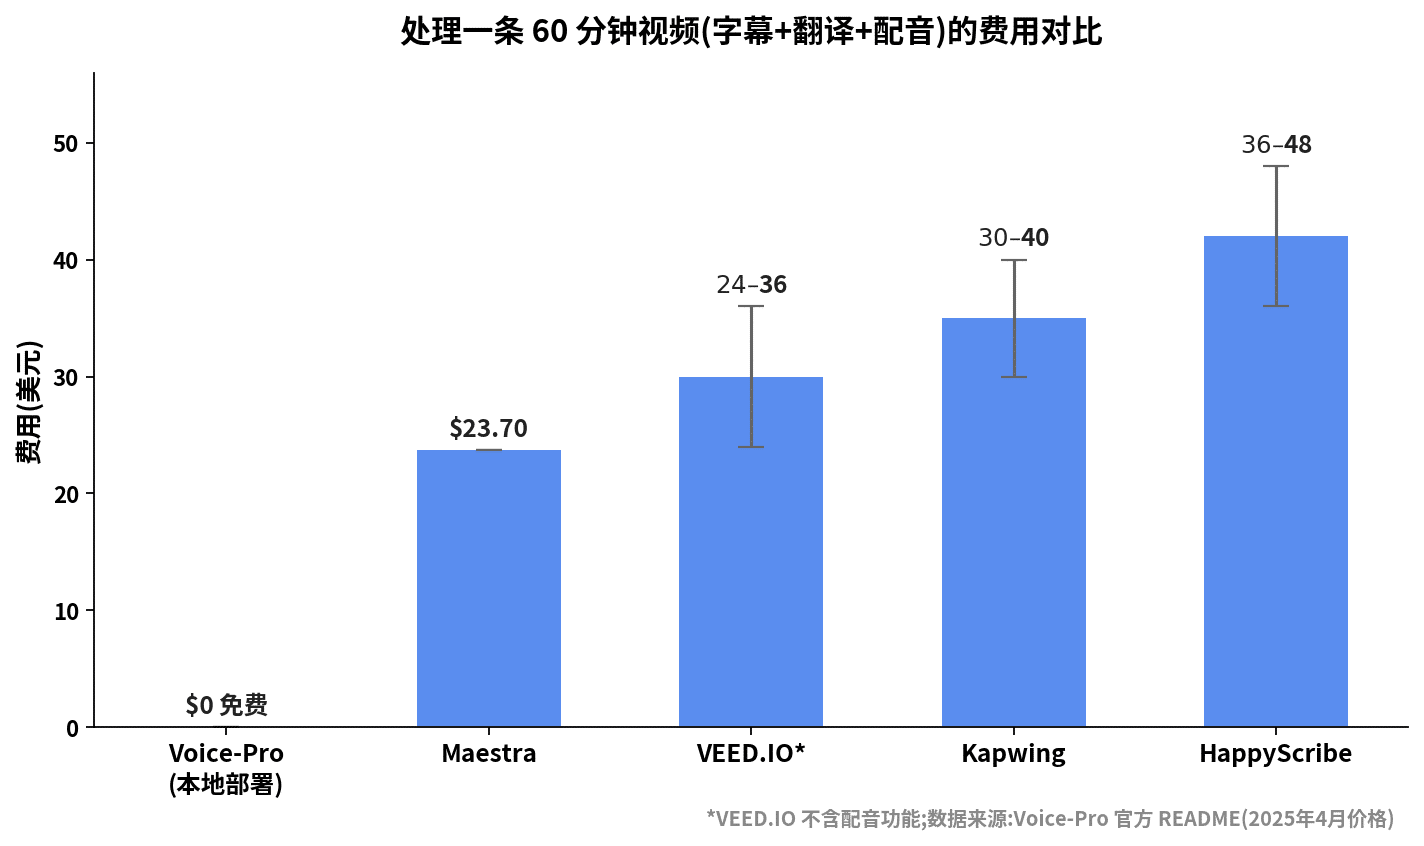
图:处理一条 60 分钟视频的费用对比,数据取自 Voice-Pro 官方 README(2025 年 4 月价格口径)
价格之外还有两点差别。数据安全上,在线平台要求把视频上传云端处理,未发布的素材存在外泄风险,本地部署全程不出自己电脑;使用限制上,SaaS 平台普遍设有每日时长配额,高峰期还要排队,本地版没有任何配额,显卡越强跑得越快。
硬件门槛与配置要求
软件免费,代价是吃自己电脑的显卡算力。官方给出的要求和社区经验综合起来是这样:
- 显卡:NVIDIA 显卡(N 卡)。官方最低要求 4GB 显存,实际想跑得顺畅建议 8GB 起步(RTX 3060 / 4060 级别及以上),降噪等级开到 2 档就明确要求 8GB。AMD 显卡和核显只能走 CPU 模式硬算,速度会慢一个数量级。
- 内存与硬盘:内存 4GB 以上即可,硬盘要预留 20GB 以上空间,光 AI 模型文件就有大约 10GB。
- 系统:Windows 10 / 11(64 位)。官方坦承 Mac 和 Linux 未经充分验证,稳妥的组合仍是 Windows 加 N 卡。
- 驱动:NVIDIA 驱动版本 570 以上,RTX 50 系显卡已获支持;新版不再需要单独安装 CUDA Toolkit 和 Visual Studio 组件。
安装步骤
安装不需要编程基础。2026 年 7 月发布的 4.0 版把安装器换成了 uv(一款高速 Python 包管理器),流程比网上流传的旧教程简单:早期版本要先跑约一小时的 configure.bat 预装组件,现在这一步已是可选项,全部工作交给 start.bat。
- 从 GitHub 仓库的 Releases 页下载最新源码压缩包,解压到一个不含中文的路径;会用 git 的话直接克隆:
git clone https://github.com/abus-aikorea/voice-pro.git- 双击运行
start.bat。首次运行自动下载 uv、Python 3.12 和全部依赖(只需几分钟),随后下载约 10GB 的 AI 模型——这是最耗时的一步,等命令行窗口跑完即可。 - 安装完成后浏览器会自动弹出操作界面;没有弹出就手动打开命令行里显示的地址(形如
http://127.0.0.1:7870)。
几个补充说明:configure.bat 需要管理员权限,作用是在系统层面装好 git 和 ffmpeg,公司电脑没有管理员权限可以直接跳过,start.bat 会自动下载便携版 ffmpeg 顶上;日常更新跑 update.bat;卸载跑 uninstall.bat 或整个删掉文件夹。运行报错时的通用解法是删掉 installer_files 文件夹后重跑 start.bat,几分钟即可完成干净重装,已下载的模型不会丢。显存不足报 CUDA Out-Of-Memory 时,把降噪等级调到 0 或 1、Compute Type 换成 int 类型即可缓解。
国内使用注意
有三点和网络环境相关,安装前需要确认:
- 首次安装要从 GitHub 和 Hugging Face 拉取依赖与模型文件,国内直连不稳定,需要提前准备可靠的网络环境。
- 翻译功能默认调用 Google 的免费网页接口,大陆网络直连不可用;语音合成里的 Edge-TTS 是微软在线服务,国内可以正常访问。手里有 Azure 订阅的用户,可以在 .env 文件里填入密钥,把翻译和合成整体切到 Azure 服务。
- 装好之后,Whisper 识别、Demucs 人声分离、F5-TTS 和 CosyVoice 克隆这些核心环节都在本地运行,不再依赖外网。
适用边界与替代选择
综合来看,每月要产出多条中长视频翻译、手里有 8GB 显存 N 卡的创作者,从 Voice-Pro 上省下的订阅费最可观;只是偶尔给短视频配几句旁白的轻量用户,装 10GB 模型并不划算,VoiceCraft 这类免安装的在线工具更省事,纯粹的录音转文字需求也可以看看 TransPocket 及其替代方案。音色的自然度上限方面,ElevenLabs 的商业模型仍略占优势,Voice-Pro 的核心竞争力在零成本、无配额和数据不出本机。
还有一点需要说明:开发团队目前把精力转向了另一款产品,Voice-Pro 暂停功能更新,但全部代码已经开源,允许任何人自由分发和修改,现有功能的使用不受影响。以 4.0 版的完成度,它已经是同类免费方案里链条最完整的一个。
官网 / 下载
GitHub 仓库(源码与整合包下载):https://github.com/abus-aikorea/voice-pro
© 版权声明
文章版权归作者所有,未经允许请勿转载。