TripStar(旅途星辰)是一个开源的 AI 旅行规划项目,仓库地址 github.com/1sdv/TripStar,README 标注的版本为 v2.1.0,采用 GPL-2.0 协议,最近一次代码提交在 2026 年 9 月中旬。它的产出不是一篇攻略长文,而是一份带地图路线、逐日安排和预算明细的结构化行程,生成之后还能在同一个页面里继续追问和修改。项目本身不提供在线服务,需要自行部署,也需要自行准备大模型与地图接口的密钥。
行程页面的六个板块
生成结果分成六个标签:行程概览、预算明细、景点地图、每日行程、知识图谱、天气信息,右上角另有编辑行程与导出行程两个入口。
行程概览是一排景点卡片,每张卡片给出景点名称与一段简介,页面底部附一份注意事项清单,内容涵盖预约渠道、交通建议、着装提示和餐饮选择。
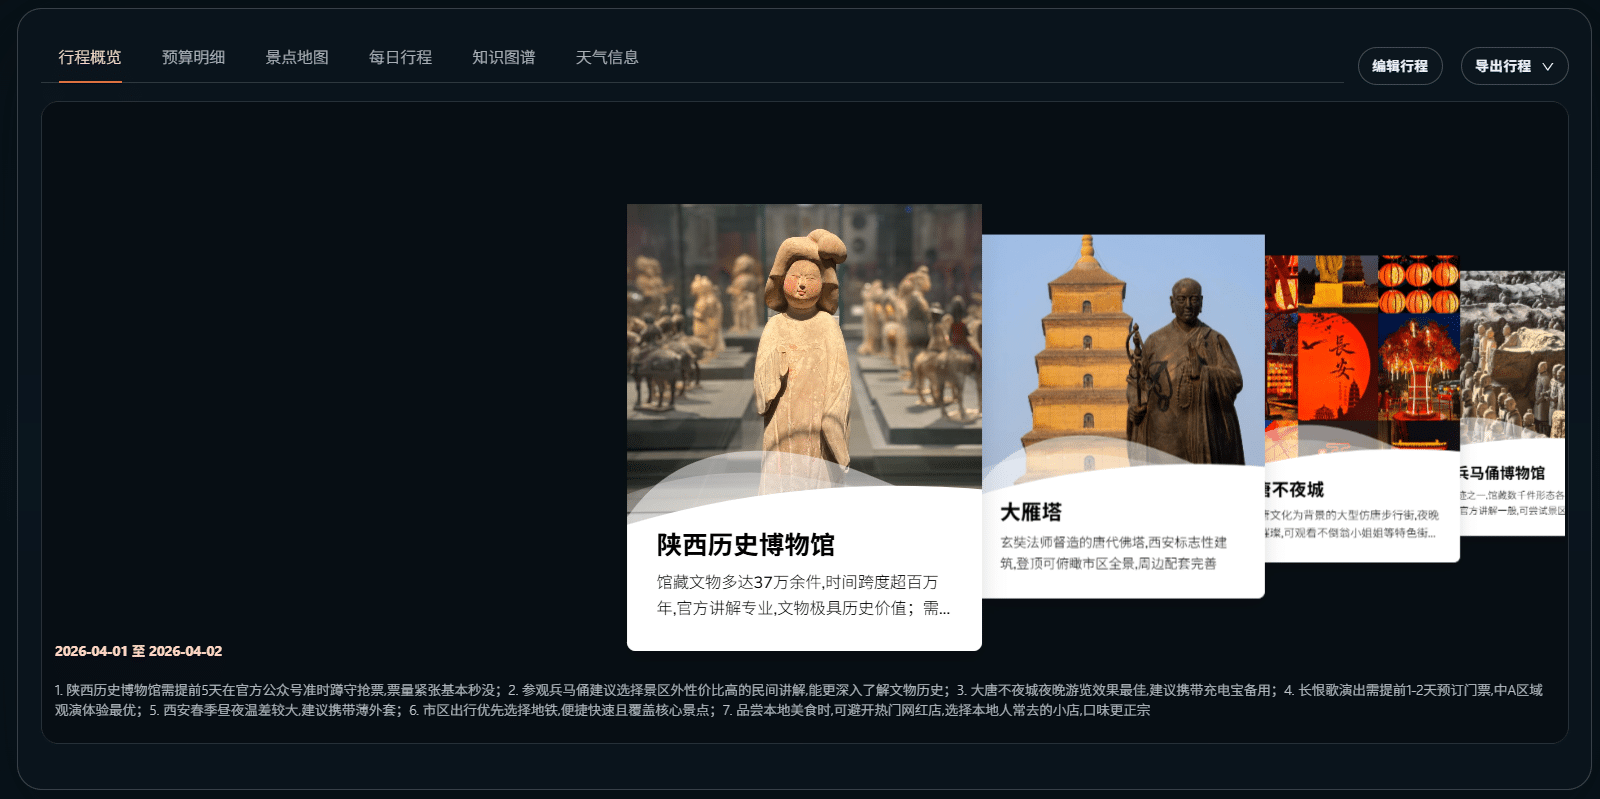
图:TripStar 的行程概览页面,来自项目官方 README 截图
每日行程按天展开,单日条目包含行程描述、交通方式、住宿推荐、景点安排(地址、游览时长、景点描述、预约提醒)、餐饮安排以及当天天气。预算明细把门票、餐饮、住宿、交通分门别类汇总成一张账单。知识图谱用 ECharts 把「城市—天数—行程节点—预算」的层级关系画成节点关系图。报告生成后,页面左下角会出现一个悬浮问答窗口,模型带着完整行程的上下文,可以针对票价、适宜性这类细节继续追问。
多城市规划也已经支持:一次旅行可以添加多个城市并分别设置停留天数,系统自动算出总天数,城际移动日会单独标注交通建议,预算面板独立统计城际交通费用,天气面板按城市分开展示。还有一个用户偏好记忆模块,开启后会在行程生成成功时提取稳定偏好并打分入库,带权重、有遗忘机制和 TOP-K 召回,下一次规划时把高权重偏好注入 Agent 提示词。
景点数据来自小红书
这是 TripStar 与多数同类项目最明显的区别。景点候选不靠模型凭记忆生成,而是去搜小红书的真实游记:后端用原生签名直连接口,失败时退回 SSR 页面抓取,拿到游记正文后交给大模型提纯成结构化的景点数组,字段包含名称、真实评价、游玩时长以及是否需要提前预约,最后再调高德 POI 搜索补齐经纬度。景点配图同样来自小红书——前端拿到行程后按景点名单独调用 /api/poi/photo 接口,后端搜索该景点的最新笔记并取首张图片直链。
预约提醒这项功能就建立在这条链路上:模型从游记里识别出故宫、陕西历史博物馆这类需要提前抢票的景点,在行程卡片上标出预约提示与渠道信息。
这条设计的代价体现在配置项里。后端 .env 的 XHS_COOKIE 是必填项,取值要从小红书网页端登录后的浏览器开发者工具里复制。Cookie 会过期,平台的接口与页面结构也可能随时调整,这是整个项目长期可用性上最不稳定的一环,也是部署完成后最容易先出问题的地方。用于商业场景的话,数据来源本身的合规性同样需要先做评估。
顺带更正一处流传较广的说法:早期的中文介绍提到景点配图依赖 Unsplash API、部署前需要申请免费额度,而当前版本的 README 里已经找不到 Unsplash 的任何痕迹,取图环节改成了小红书实时搜索。照早期教程去申请 Unsplash 额度已经没有必要。
多智能体的任务拆分
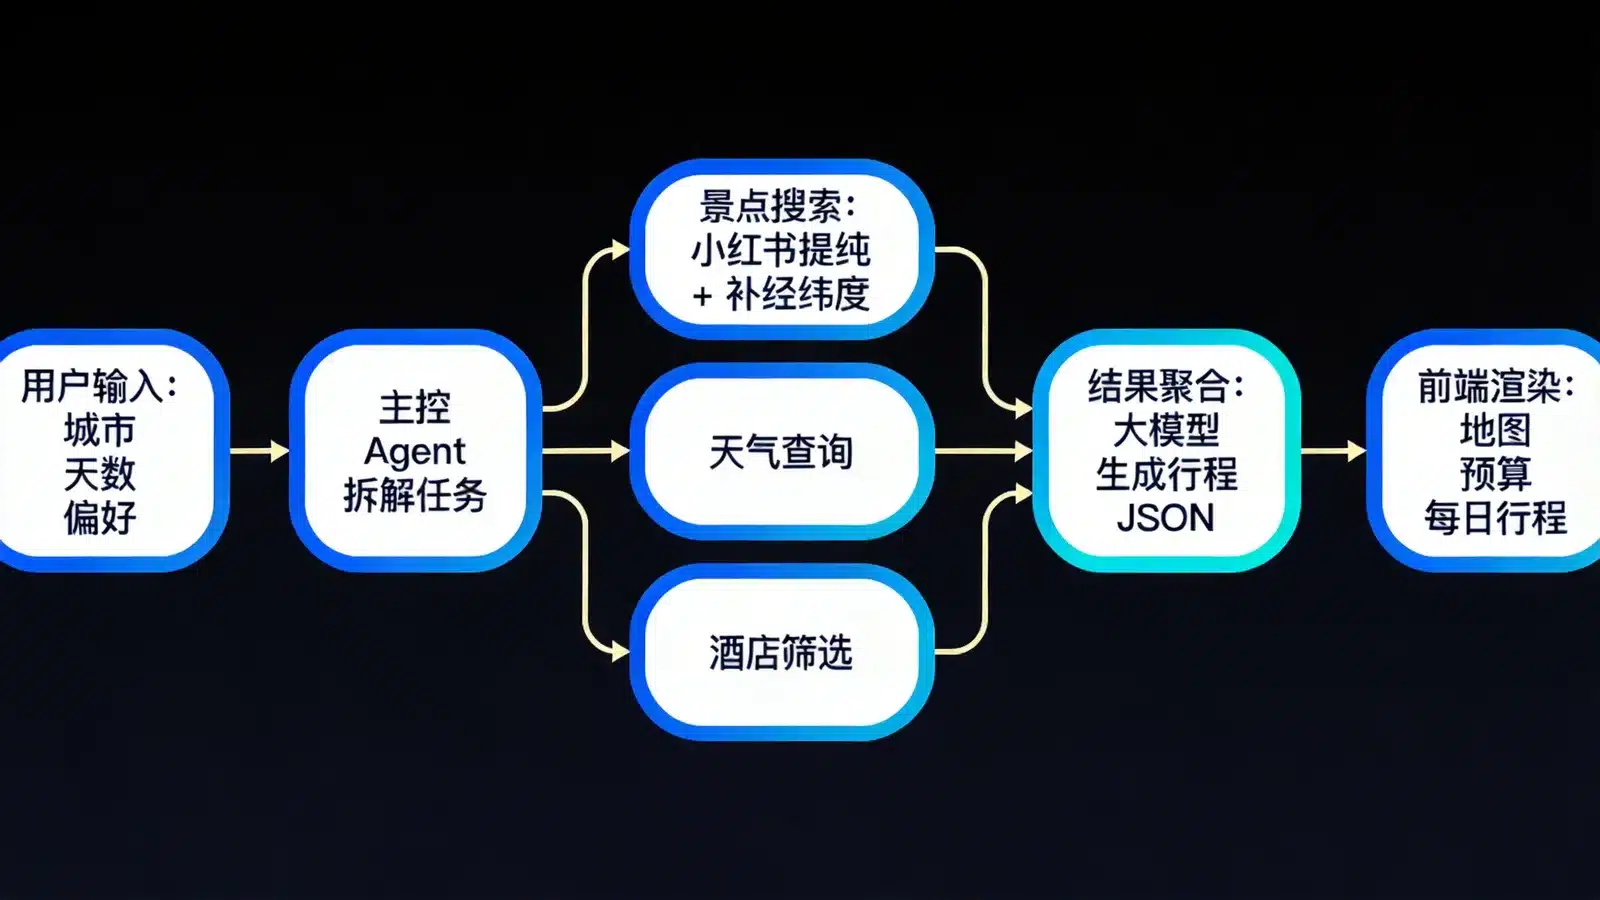
图:TripStar 的多智能体协作流程示意,据项目 README 整理
主控 Agent 接到需求后按 React 模式拆解任务,其中三路用 asyncio.gather 并发执行。一路做前面说的小红书景点提纯与坐标补齐,地理编码优先走 Google,失败降级到高德 REST 接口;一路是天气管家,通过 Google 或高德的 MCP Weather Tool 查询目标日期的气候状况,Google 请求失败会自动回退高德天气接口;一路是酒店专员,调用 Google 或高德的 POI 文本搜索,按预算寻找落脚点。
三路结果回来后进入串行聚合:景点、天气、酒店的上下文一起拼进最终的规划提示词,模型返回一份嵌套较深的行程 JSON,再由 _parse_response() 做五级容错——清理杂乱字符、修复未转义引号、截断修复补齐括号、暴力提取,以上都失败才再求助模型修补。最后 build_knowledge_graph 把行程数据转成节点与边,并按目标语言翻译标签。
任务调度这块的写法值得单独看。POST /api/trip/plan 收到请求后立即返回 task_id 与 WebSocket 地址,把可能跑上几分钟的推理丢进 asyncio.create_task;前端订阅 /ws/{task_id} 接收实时进度,同时保留 GET /api/trip/status/{task_id} 每三秒一次的轮询兜底;任务完成后状态持久化到磁盘,历史计划因此可以回看。任何一个单次模型调用动辄几分钟的自部署项目都会撞上网关超时,这套「立即返回任务 ID、后台执行、前端订阅进度」的结构比单纯调大超时时间稳妥,可以直接借鉴。那段五级 JSON 容错同理——让模型输出复杂嵌套 JSON 时,解析失败出现的频率相当高,兜底逻辑省不得。同类的智能体编排思路,站内此前介绍过的 Craft-Agent 开源研究智能体 走的是另一条路线,把研究结果直接输出成网页。
部署前要备齐的账号与密钥
环境方面需要 Python 3.10+、Node.js 18+ 和 uv 包管理器。密钥部分逐项如下。
大模型 API Key 必须来自兼容 OpenAI 格式、并且能稳定输出结构化 JSON 的服务,README 点名推荐豆包。普通对话模型会让后端的解析环节直接失败,这属于模型能力不足,换配置解决不了。
高德地图需要两个 Key:后端 REST 服务用 Web 服务类型的 Key,前端渲染用 Web 端(JS API)类型的 Key,另外还要配一个安全密钥 JSCode。这里有一处口径变化需要留意——当前 README 明确要求把 JSCode 填进 .env 的 VITE_AMAP_SECURITY_JS_CODE,构建或启动前端服务时会自动替换 index.html 里的占位符,并特别说明不要把真实密钥手写进 index.html。按早期教程直接改 index.html 的做法已经不是官方建议。
小红书 Cookie 在后端同样是必填项,取值来源前面已经说明。
Google Maps Key 属于选填,只有需要国外地图引擎时才配置。启用它要在 Google Cloud 控制台开通五个 API:Geocoding API、Places API (New)、Directions API、Maps JavaScript API 和 Weather API,并且需要绑卡。国内访问另有一个 GOOGLE_MAPS_PROXY 变量,它只作用于后端的 Google Maps 服务,不会影响大模型、小红书与高德的请求。
两种部署方式
官方推荐用 docker-compose 一键启动,前后端一起拉起来。运行之前先复制根目录的配置模板:
cp .env.example .env根目录 .env 的示例内容:
LLM_API_KEY=your_api_key
LLM_BASE_URL=https://your-openai-compatible-endpoint/v1
LLM_MODEL_ID=your_model
XHS_COOKIE="a1=xxx; web_session=xxx"
VITE_AMAP_WEB_KEY=your_amap_web_service_key
VITE_AMAP_WEB_JS_KEY=your_amap_web_js_key
VITE_AMAP_SECURITY_JS_CODE=your_amap_security_js_code
GOOGLE_MAPS_API_KEY=
GOOGLE_MAPS_PROXY=
容器化部署有几条约定容易被忽略:容器启动时不再读取项目目录里的 backend/.env,配置必须以环境变量形式传入;VITE_AMAP_WEB_JS_KEY 与 VITE_AMAP_SECURITY_JS_CODE 是前端构建期变量,通过 build.args 自动注入,改动之后需要重新构建镜像;前端设置页可以修改后端的运行时配置,敏感字段返回时会被遮罩,保存遮罩值不会覆盖原有密钥。这种配置项偏多、但容器封装相对完整的部署形态,和站内此前写过的 ai-goofish-monitor 闲鱼 AI 监控系统 属于同一类,难点都不在启动命令本身,而在前置账号的准备。
本地开发则前后端分开启动。后端:
cd backend
npm install
uv venv .venv
source .venv/bin/activate  # Windows: .venv\Scripts\activate
uv pip install -r requirements.txt
cp .env.example .env
uvicorn app.api.main:app --host 0.0.0.0 --port 8000 --reload
后端目录里那句 npm install 容易被当成笔误跳过,它装的是小红书签名引擎所需的 Node.js 依赖,漏装会导致景点搜索这一路走不通。服务起来之后访问 http://localhost:8000/docs 可以查看交互式 API 文档。backend/.env 的必填项是 LLM_API_KEY、LLM_BASE_URL、LLM_MODEL_ID、VITE_AMAP_WEB_KEY 和 XHS_COOKIE,Google Maps 相关的两项选填。
前端:
cd frontend
npm install
cp .env.example .env
npm run dev
前端 .env 必填 VITE_AMAP_WEB_JS_KEY(必须是 Web 端 JS API 类型)与 VITE_AMAP_SECURITY_JS_CODE,VITE_API_BASE_URL 默认指向 http://localhost:8000,同源部署可以留空。
地图引擎与多语言的实际支持范围
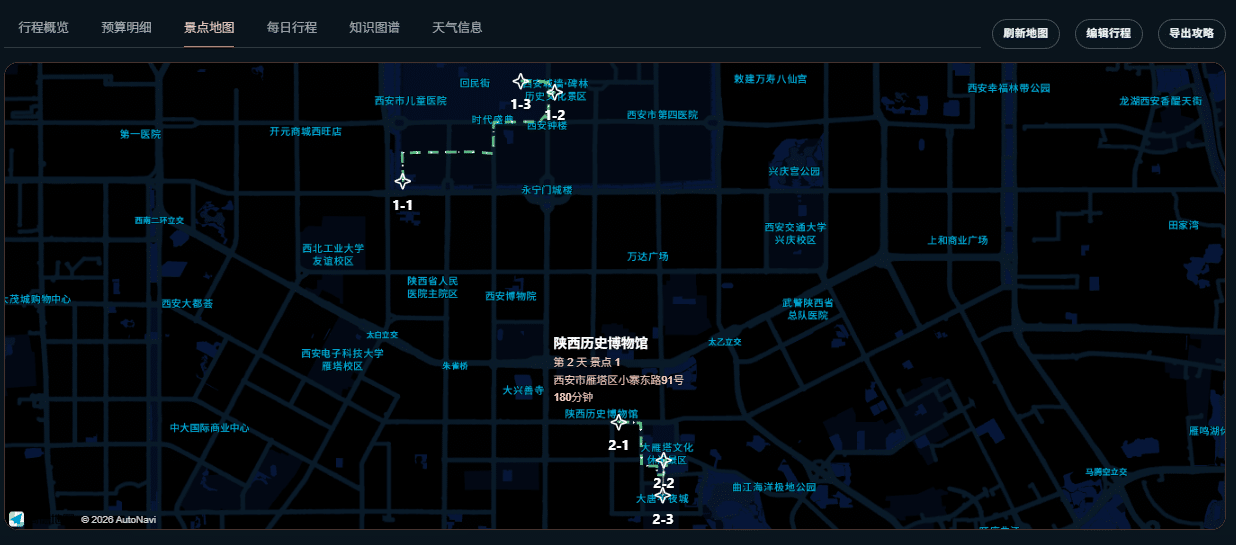
图:景点地图页面按「第几天—第几个景点」编号标注并绘制路线,来自项目官方 README
地图部分是双引擎结构:国外走 Google Maps,国内回退高德,两者之间自动切换。地图上绘制的是「起点—景点—终点」的真实经纬度连线,标记按第几天第几个景点编号,用来判断景点之间的方位关系足够清楚,底图配色也做过定制。
关于适用范围有一处口径需要更新。早期的中文介绍称该项目只支持国内旅行场景、跨境多国行程暂不支持,而当前 README 的路线图里,接入 Google Maps 实现国内外双引擎自动降级、模型返回语言的国际化适配与知识图谱多语言支持、多城市旅行支持这三项都已经标记为完成,仓库里也放出了东京与纽约行程的界面截图,界面与生成内容随语言整体切换,支持中、英、日三种语言。国外场景现在能跑,前提是接受 Google 那几个 API 的开通与绑卡流程。
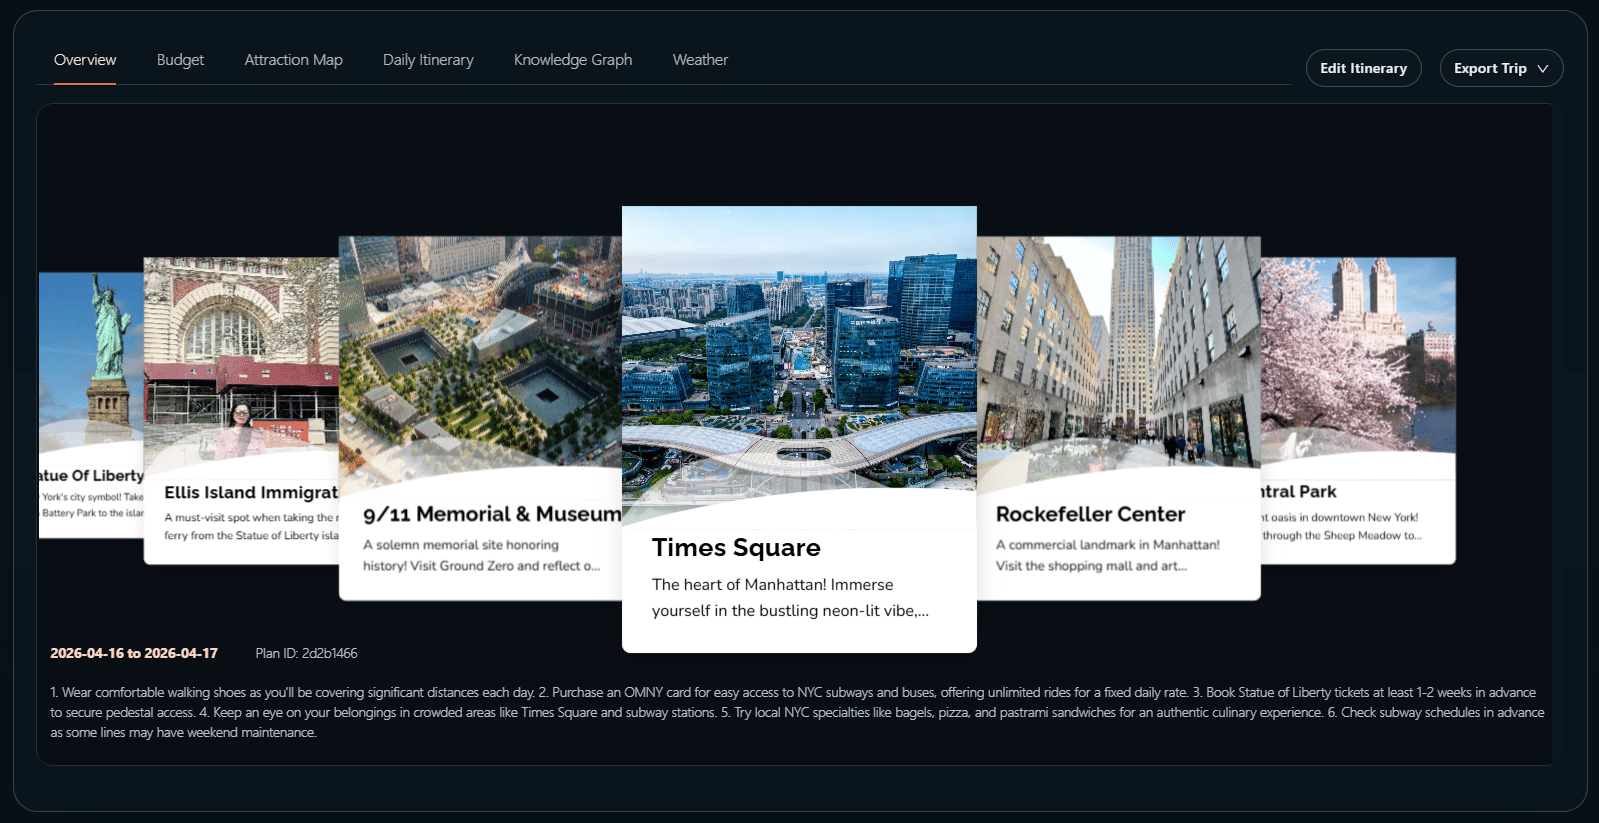
图:切换英文后生成的纽约行程,界面标签与行程内容一并本地化,来自项目官方 README
授权、托管与待办项
授权这一条比第三方接口的额度限制更前置。仓库采用 GPL-2.0,属于强 copyleft 协议:基于它二次开发并对外分发,衍生作品同样需要以 GPL-2.0 开源。个人自用或团队内部工具不受影响,但打算把它包装成闭源商业产品或对外 SaaS 服务的,这一条要先看清楚,再去核对大模型、高德、Google 各自的商用授权与并发限制。
目前没有官方托管版本,路线图里的「服务器在线部署」仍是未完成项。魔搭社区上能找到一个名为 Journey-to-the-China 的在线 Demo,由用户 lcclxy 创建,页面自述是 GitHub 开源项目文件、完整功能需本地部署,想完整体验仍需自行搭建。
路线图上其余未完成的条目包括小红书链接与美食推荐增强、前端优化以及车程信息。车程信息缺位意味着景点之间的实际通勤时间目前需要自行核对,生成的行程只保证顺序经过优化、避免折返,不保证时间排得开。
适用人群与取舍
研究文旅智能体、多智能体编排或大模型结构化输出容错的开发者,这个仓库的参考价值高于它的日常实用价值,并发编排与 JSON 解析兜底这两段代码尤其值得读。
只想拿到一份能用的攻略、不愿意配置五六个密钥的用户,现成的在线 AI 行程工具是更省事的选择,没有必要为此搭建一套前后端环境。同样是开源自部署项目,门槛卡在哪里各不相同——CyberVerse 开源数字人 Agent 卡的是显卡,TripStar 卡的是账号与密钥的齐备程度。
打算把行程生成能力接进自有产品的团队,更稳妥的顺序是先确认 GPL-2.0 与小红书取数这两条是否可接受,再评估技术栈的匹配度。
官网 / 下载
GitHub 官方仓库:github.com/1sdv/TripStar,提供源码结构、完整技术栈与部署环境变量说明。
魔搭社区在线 Demo(第三方用户创建,非官方托管):Journey-to-the-China。
© 版权声明
文章版权归作者所有,未经允许请勿转载。