CyberVerse 是一套开源的实时数字人 Agent 框架,上传一张照片就能生成可以视频通话的 AI 角色。语音识别、大语言模型、语音合成、口型驱动和 WebRTC 推流被串成一条链路,浏览器里呈现的是一张会说话、有表情、可以随时打断的脸,而不是一个文字对话框。项目以 GPL-3.0 协议开源,2026 年 5 月 16 日发布了 v0.1.0 版本。
需要先说明两处变动:仓库地址已从 dsd2077/CyberVerse 迁移到 Lynpoint/CyberVerse,旧链接会自动跳转;早期介绍里被列为”仍在规划中”的长期记忆、工具调用、多 Agent 协作和知识库问答,在当前官方文档中已经进入正式功能列表。
功能范围
核心能力是实时视频交互。用户上传照片生成形象后,可以像真人视频通话那样对话,数字人说话过程中随时插话打断,框架按全双工方式处理。
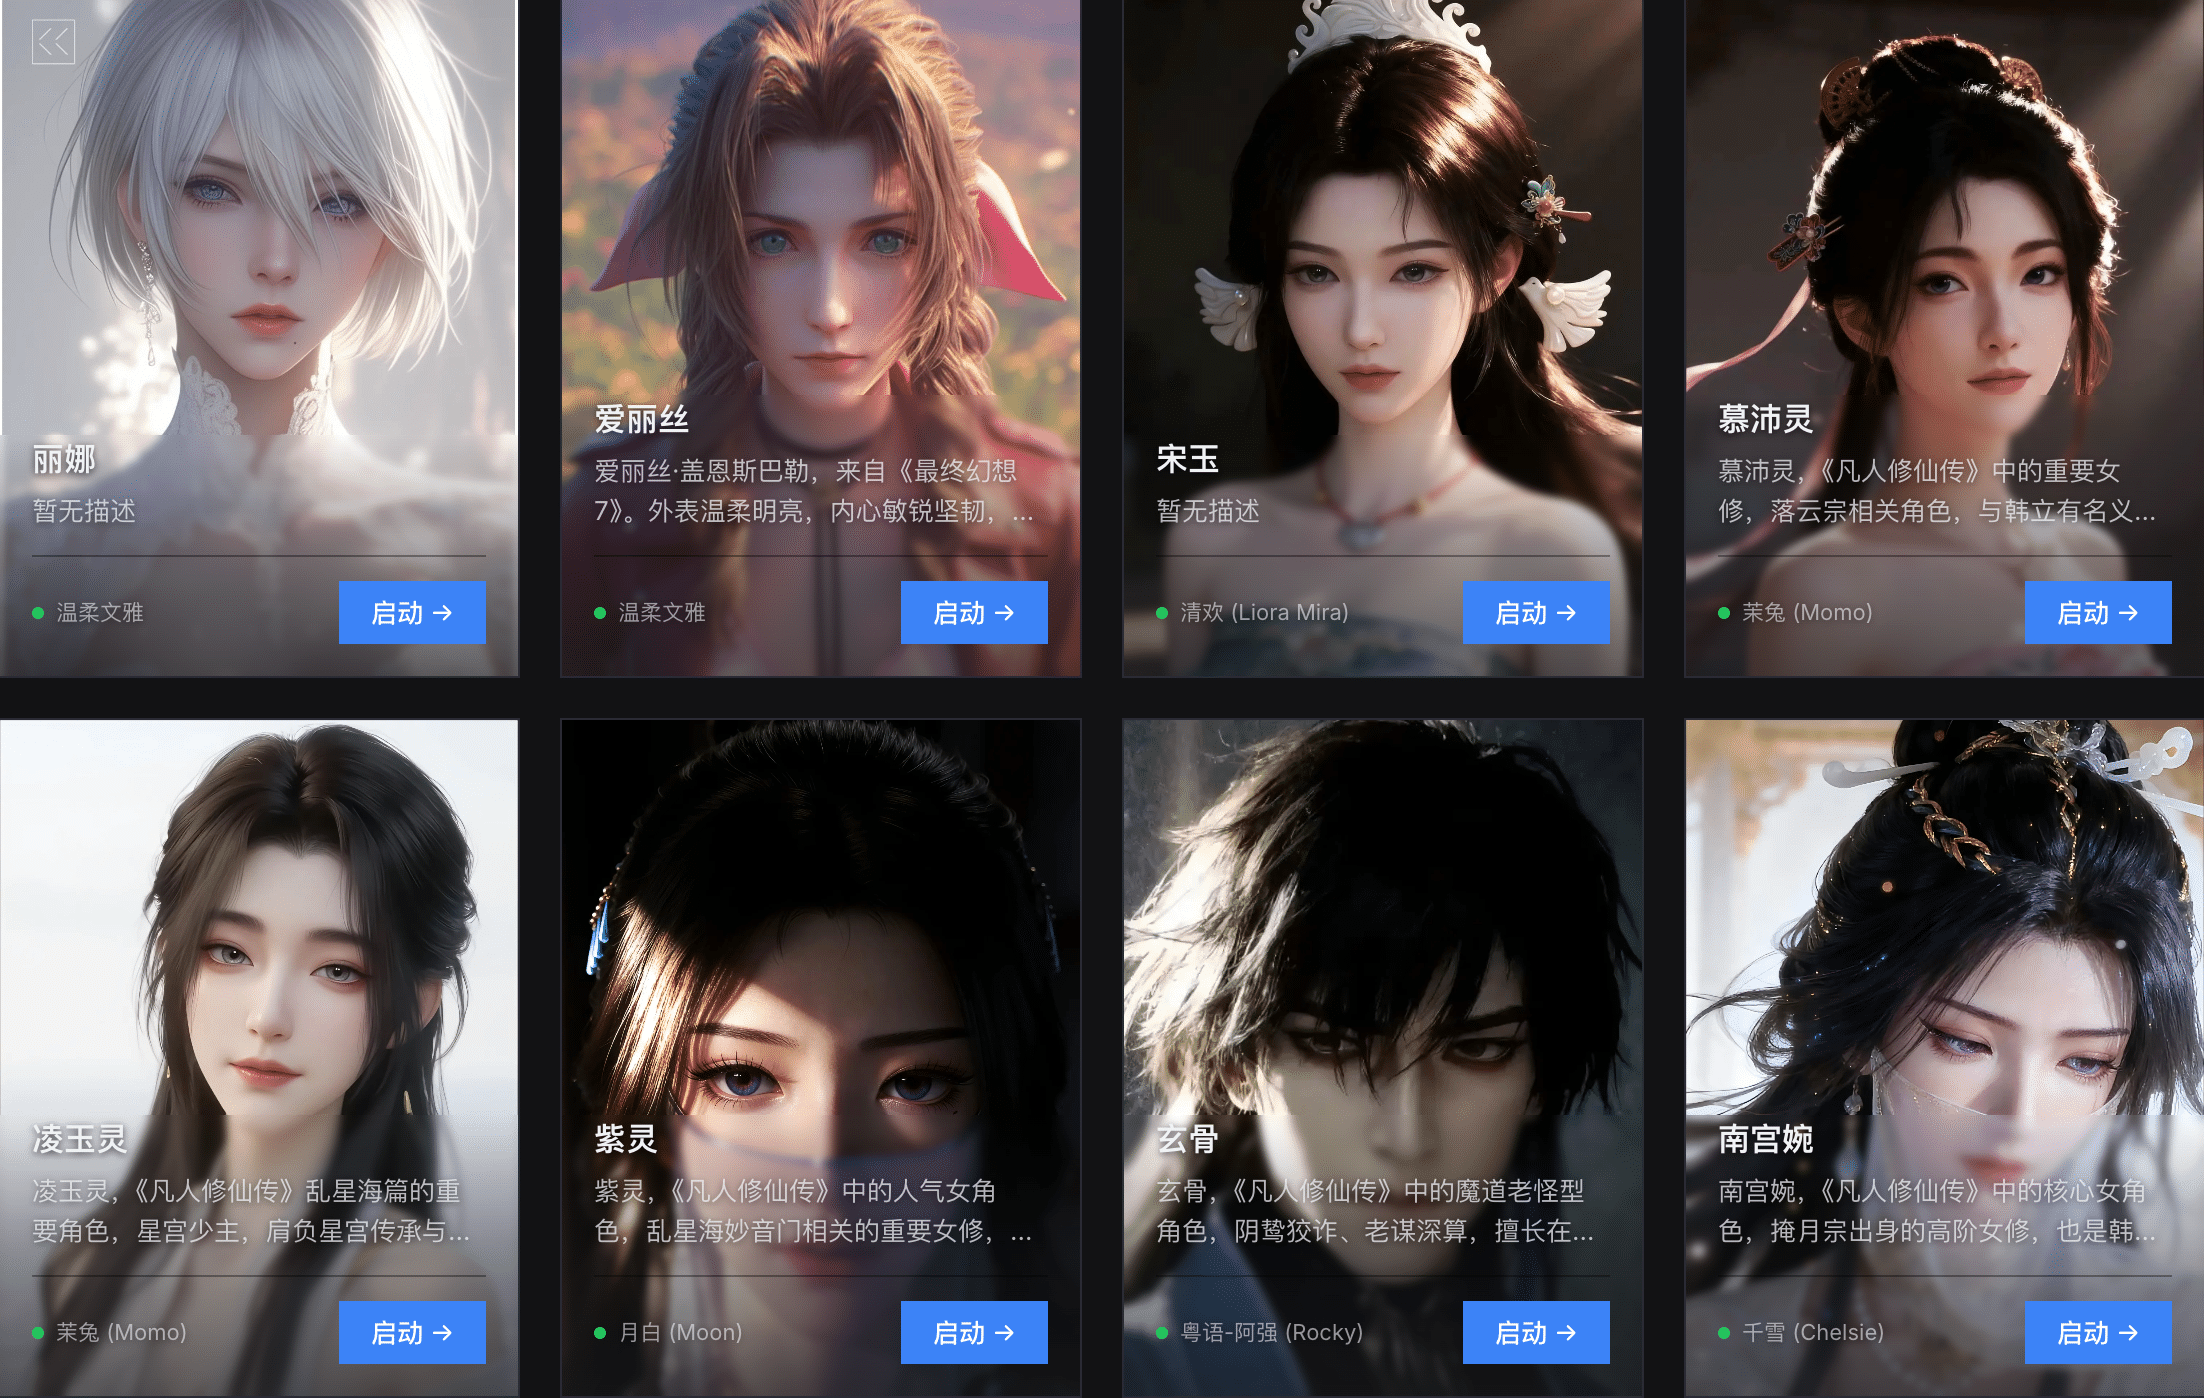
图:CyberVerse 官方仓库提供的角色选择界面演示截图
对话背后是一套 multi-agent 结构。PersonaAgent 常驻前台,只负责把对话接住、响应打断和切换上下文;搜索、调研、资料整理、总结、生成 HTML 报告这类耗时任务交给后台 SubAgent 异步跑。这样设计是为了避免一个长任务把语音回合卡住,用户在等待期间仍然可以继续说话或者改变方向。
角色记忆写在本地磁盘,重新进入对话会自动加载历史,跨会话有连续感。给角色导入文档、知识库、人物生平素材后,系统建立索引供检索增强生成使用,回答会更贴合设定。
各个模块都可替换:大脑、声音、听觉、工具、记忆、面孔。运行行为写在 config/cyberverse.yaml,omni 模型、LLM、TTS、ASR、Embedding 的 provider 定义从 infra/config/*_models/ 自动加载,需要覆盖时在 config/*_models/ 下放同名文件。API Key 和服务端点也可以在 Web UI 的 /settings 页面里改,不必只靠编辑配置文件。
一次对话要走完的链路
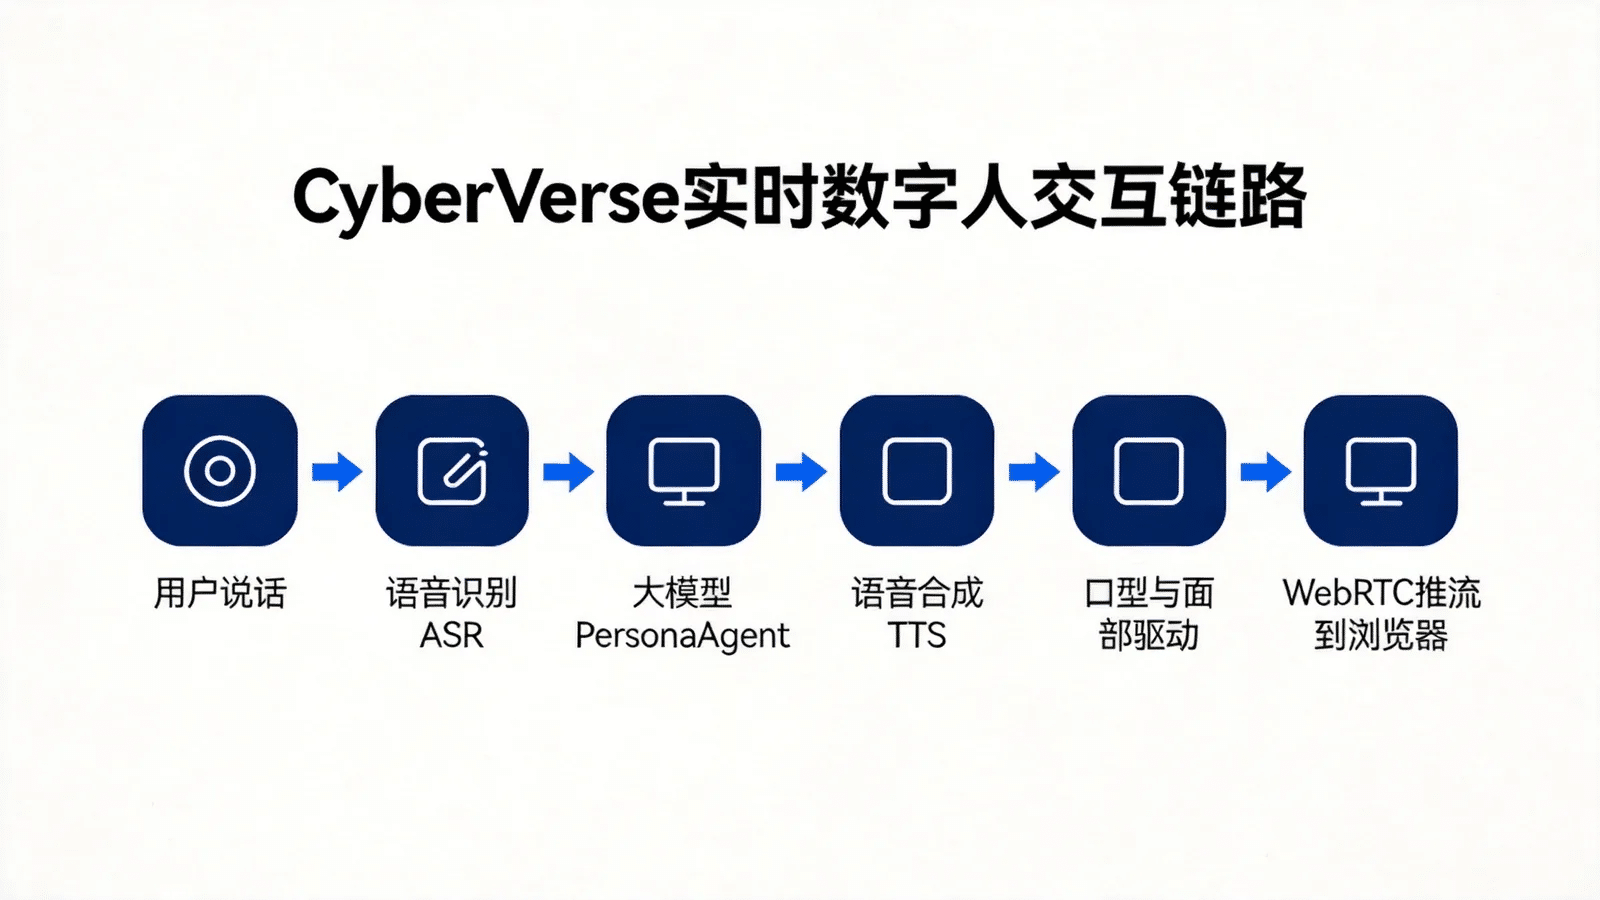
CyberVerse 一次对话要走完的六个环节
链路上任何一环慢下来,通话的实时感都会丢失,这也是这类项目难做的地方。同样是把 AI 接进音视频流程,LuoGen-agent 这类数字人口播工具走的是离线渲染路线,成片可以慢慢等;CyberVerse 要求每一帧都赶在播放之前生成出来,对算力的要求完全不是一个量级。
数字人模型与硬件要求
框架内置 FlashHead 和 LiveAct 两个本地数字人模型,同时支持百度曦灵、讯飞数字人和 Vidu S1 等云端方案。官方给出的硬件对照如下:
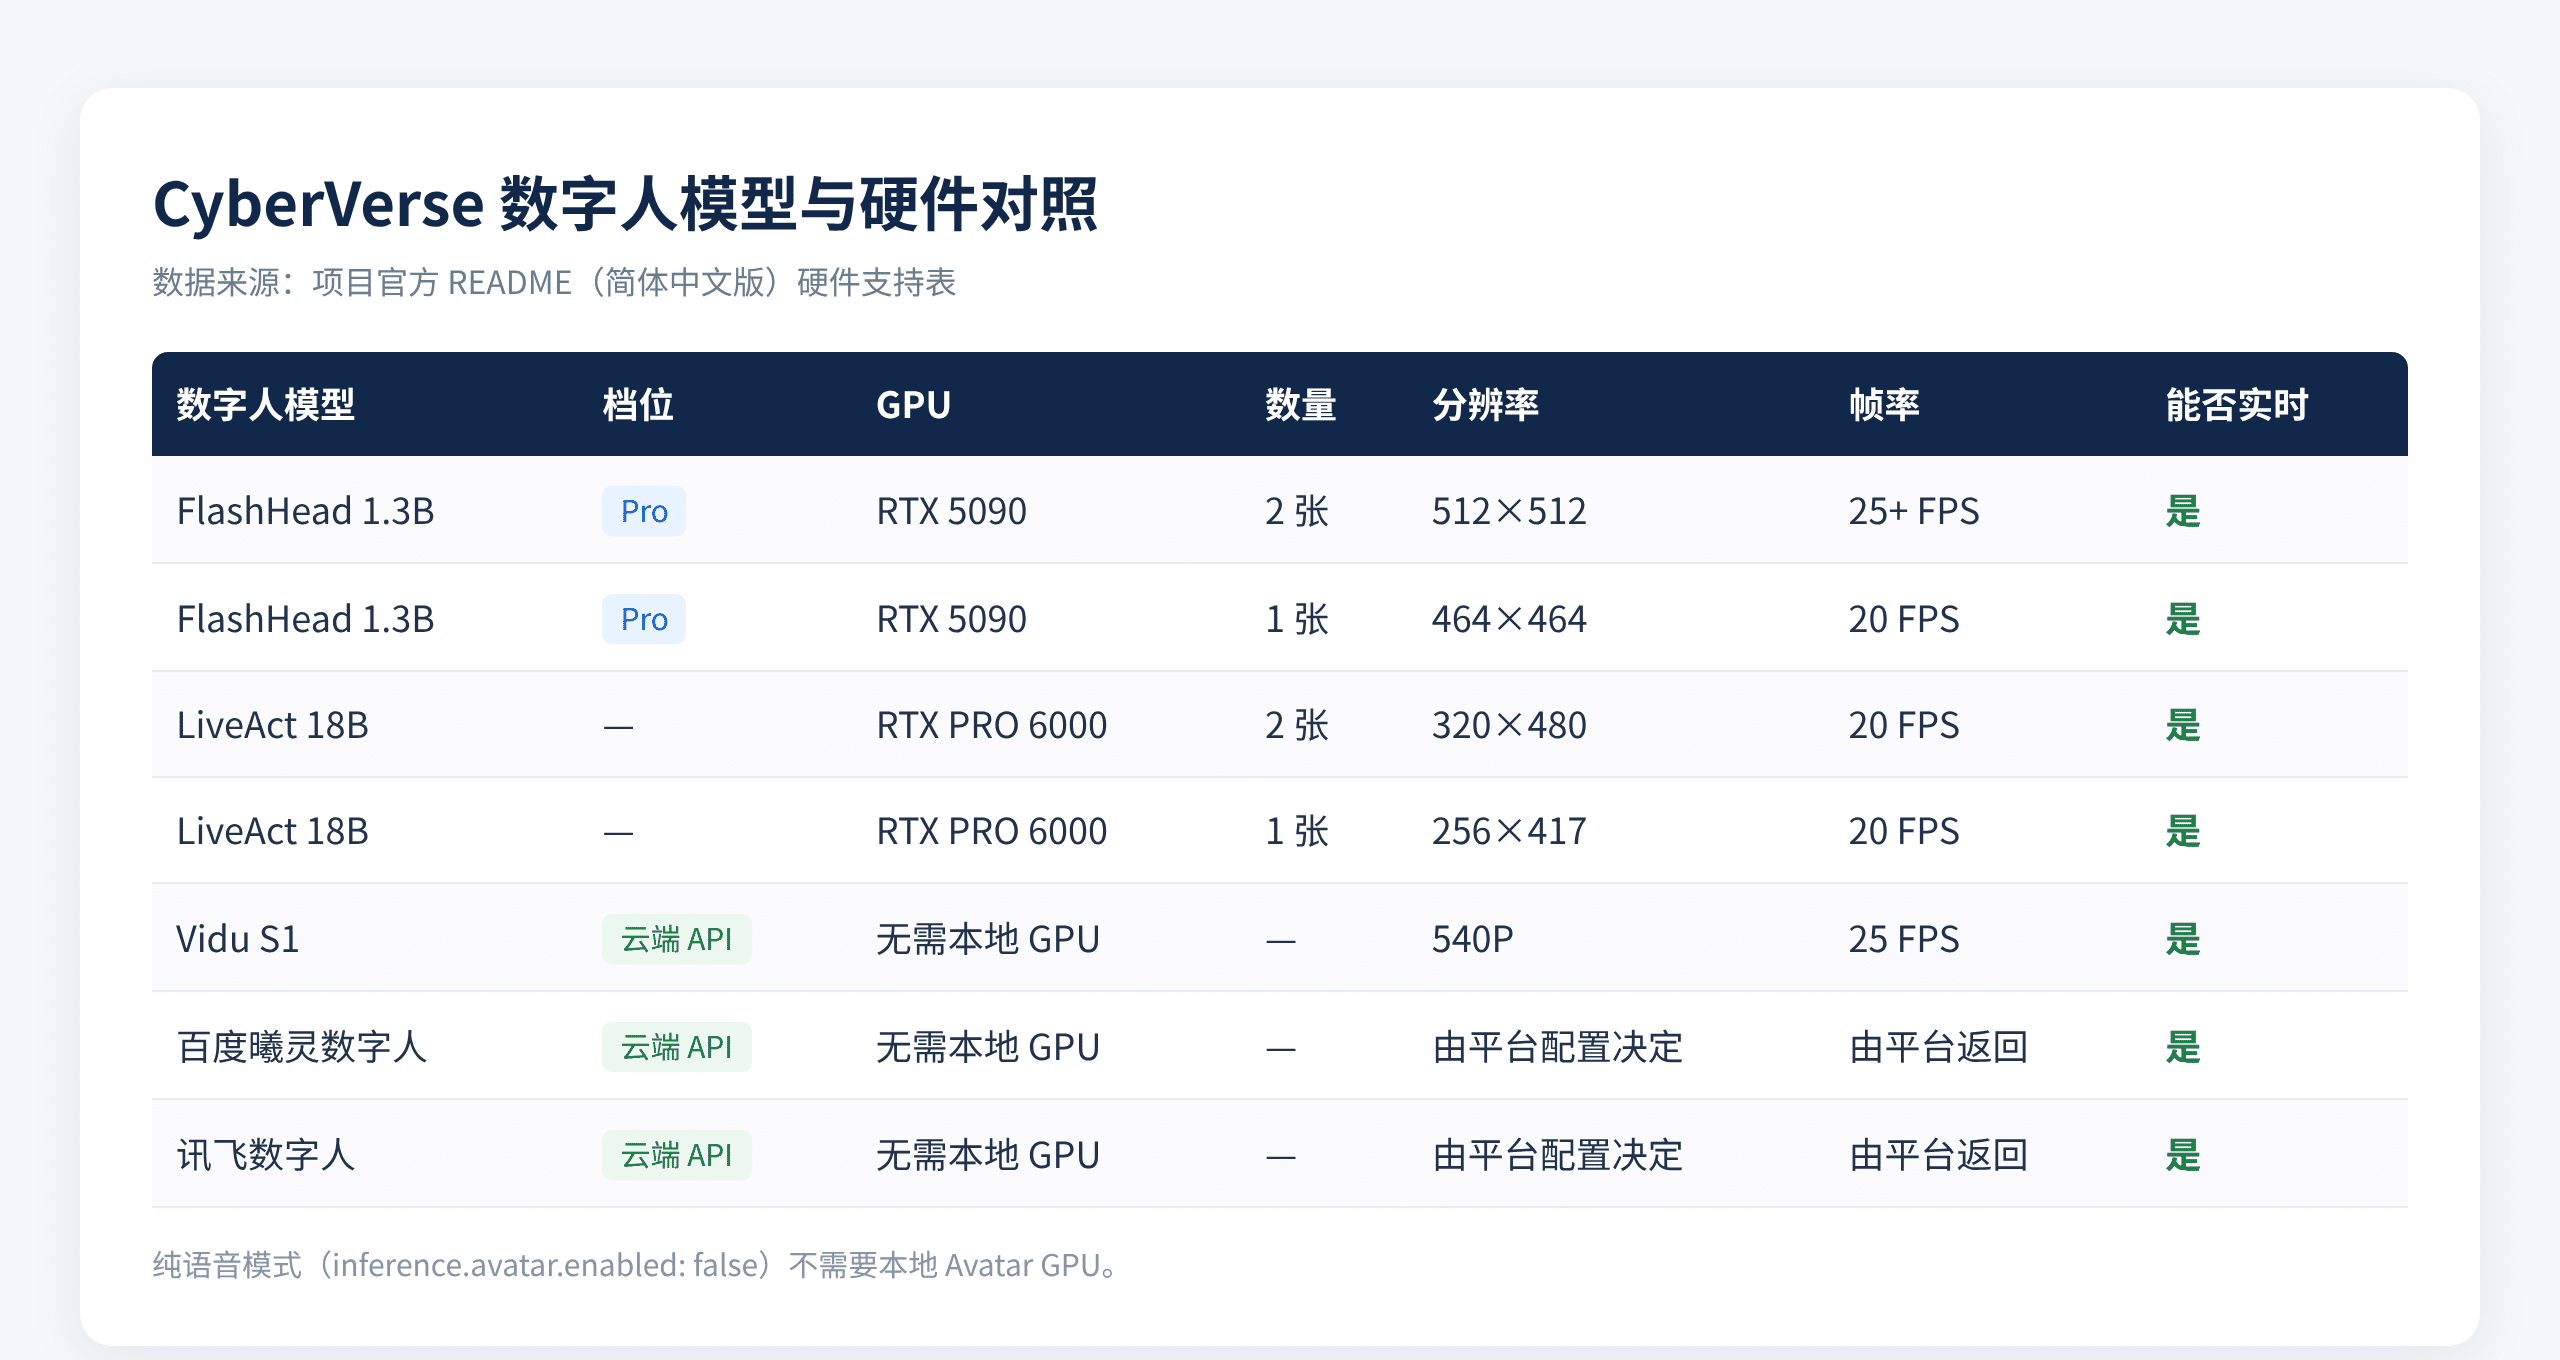
官方 README 给出的数字人模型与硬件对照,云端 API 路线不占本地显卡
这张表值得对照着读两遍。本地路线的实时档位起步就是 RTX 5090,LiveAct 18B 更是要 RTX PRO 6000 级别的卡,个人开发者手里的消费级显卡基本够不着。云端 API 那三行则是另一条路:火山引擎数字人、百度曦灵、讯飞这类平台按调用计费,本地一张显卡都不用买,代价是形象、分辨率和帧率都由平台那边决定,自由度换成了成本可控。
还有一个常被忽略的选项:关掉 Avatar,整套系统就退化成纯语音 Agent,不需要任何本地 GPU,运行成本只取决于所配置的实时语音、LLM、TTS、ASR 服务商。想先摸清这套框架的对话能力和记忆机制,从这里入手最省事。
安装
前置条件包括 Node 18+、Go 1.25(需要 protoc-gen-go 和 protoc-gen-go-grpc)、Conda、Python 3.10+、FFmpeg,以及 libopus-dev、libopusfile-dev、libsoxr-dev、pkg-config。装完先验一遍:
node --version
go version
protoc --version
ffmpeg -version
conda --version
克隆仓库并建 Python 环境:
git clone https://github.com/dsd2077/CyberVerse.git
cd CyberVerse
conda create -n cyberverse python=3.10
conda activate cyberverse
配置环境变量的这一步,把 infra/config 复制成 config,再编辑 config/env 填 API Key。阿里云 Qwen 系列、火山引擎 Doubao 系列、Atlas Cloud 的 OpenAI 兼容接口任选其一即可:
cp -r infra/config configDASHSCOPE_API_KEY=your_dashscope_api_keyDOUBAO_ACCESS_TOKEN=your_doubao_access_token
DOUBAO_APP_ID=your_doubao_app_idATLASCLOUD_API_KEY=your_atlascloud_api_key内置的 atlas provider 指向 https://api.atlascloud.ai/v1,模型是 deepseek-ai/deepseek-v4-flash,在角色的 LLM 组件里选中就能用。豆包语音需要去火山引擎控制台拿 App ID 和 API Key,填进 DOUBAO_APP_ID 与 DOUBAO_ACCESS_TOKEN。
接着在 config/cyberverse.yaml 里关掉 Avatar,让系统先按纯语音模式跑起来:
inference:
  avatar:
    enabled: false
装依赖用一条 make:
make setup这步会装基础可编辑包([dev,inference])、生成 gRPC stubs、装前端依赖。默认配置的语音 Agent 还要补装可选组:
pip install -e ".[all]"启动要开三个终端,分别拉起 Python 推理服务、Go API 服务和前端:
# 终端 1
conda activate cyberverse
make inference

# 终端 2
make server

# 终端 3
make frontend
验证接口健康状态,然后在浏览器打开 http://localhost:5173:
curl -s http://localhost:8080/api/v1/health嫌配环境麻烦的,官方在优云智算和 AutoDL 上都放了预装镜像,可以直接开机器启动。
开启数字人视频模式
要让 FlashHead 或 LiveAct 驱动实时画面,额外需要支持 CUDA 12.8+ 的 GPU、PyTorch 2.8(CUDA 12.8)、带 libvpx 的 FFmpeg,以及模型权重。
pip3 install torch==2.8.0 torchvision==0.23.0 torchaudio==2.8.0 --index-url https://download.pytorch.org/whl/cu128用 LiveAct 的话还要装 vllm:
pip install vllm==0.11.0权重按需下载。FlashHead 需要 SoulX-FlashHead-1_3B 和音频特征提取器 wav2vec2-base-960h,LiveAct 需要 SoulX-LiveAct 和 chinese-wav2vec2-base。国内网络环境下先把 Hugging Face 镜像挂上会顺利很多,两套权重在 ModelScope 上也都有:
pip install "huggingface_hub[cli]"

# 如果你在中国大陆,可以先使用镜像:
export HF_ENDPOINT=https://hf-mirror.com

hf download Soul-AILab/SoulX-FlashHead-1_3B \
  --local-dir ./checkpoints/SoulX-FlashHead-1_3B

hf download facebook/wav2vec2-base-960h \
  --local-dir ./checkpoints/wav2vec2-base-960h
hf download Soul-AILab/LiveAct \
--local-dir ./checkpoints/LiveAct
hf download TencentGameMate/chinese-wav2vec2-base \
--local-dir ./checkpoints/chinese-wav2vec2-base然后把 config/cyberverse.yaml 里的开关打开,模型参数放在 config/avatar_models/ 下,一个模型一个 YAML 文件,把里面的路径改成本地 checkpoint 的实际位置:
inference:
  avatar:
    enabled: true
    default: "flash_head"               # 可选 "flash_head" 或 "live_act"
    idle_strategy: "silent_inference"
    runtime:
      cuda_visible_devices: 0      # 共享 GPU ID,例如多卡可写 0,1
      world_size: 1                # 共享 GPU 数量,双卡时设为 2
    model_config_dir: "avatar_models"
选百度曦灵这条云端路线的,密钥同样写进 config/env,在 Web UI 里按角色选择即可,它不属于本地推理模型,不能配成 inference.avatar.default:
BAIDU_XILING_APP_ID="your-app-id"
BAIDU_XILING_APP_KEY="your-app-key"
# 如果形象需要固定机位,可选配置。
BAIDU_XILING_CAMERA_ID="0"
走这条路时,ASR、LLM、TTS、历史上下文和角色设定仍由 CyberVerse 的 orchestrator 处理,音频按 16 kHz、16-bit 单声道 PCM 分片发到浏览器,前端嵌入百度的 H5 iframe,用官方 sendAudioData 和 AUDIO_STREAM_RENDER 消息格式驱动画面。
另有两项可选加速:LiveAct 的 FP4 GEMM 需要从 LightX2V 编译 lightx2v_kernel,环境要 PyTorch 2.7+ 并准备好 CUTLASS 源码,编出 whl 装上后在 live_act.yaml 里把 fp4_gemm 设为 true、fp8_gemm 设为 false,改完重启推理服务;SageAttention 和 FlashAttention 也支持,前者源码编译,后者可以直接下官方预编译 whl 安装。
画面卡顿时先看 RTP
数字人出现卡顿、画面冻结或者明显落后于语音时,官方给了一个可量化的自检指标 RTP,即生成一段视频 chunk 的实际耗时与这段 chunk 按配置帧率播放所需时长的比值:
RTP = elapsed / (frames / fps)小于 1 说明生成快于播放、有余量;等于 1 是刚好实时;大于 1 就是产出跟不上消耗,会越积越卡。判断方法是在角色说话时盯 make inference 那个终端的日志,找 LiveAct 或 FlashHead 的 chunk 行:
INFO:inference.plugins.avatar.live_act_plugin:LiveAct chunk: idx=2 frames=32 320x480 fps=20 iter=2 elapsed=1.870s is_final=False这行的播放时长是 32 / 20 = 1.6 秒,实际耗时 1.870 秒,RTP 约 1.17,说明当前显卡在 320×480、20 fps 下已经跟不上。FlashHead 的日志用 elapsed 配 num_frames 和 fps 同样算法。
超标后有三个方向可调:降分辨率或画质档位(调小 LiveAct 的 infer_params.size、FlashHead 的 height / width,或者把 FlashHead 设成 model_type: "lite");加算力(增加 GPU 数量、开 FP8/FP4 GEMM、换更快的卡);或者干脆照着官方硬件表选一组标着”能实时”的组合。纯语音模式不涉及这个指标,云端数字人也不占本地 Avatar 推理。
远程访问还有一个坑值得提前避开:streaming_mode: direct 配内嵌 TURN 时,浏览器必须能连上服务端的 8443/TCP。页面打得开但音视频连不上、日志里出现 ICE connection state: failed 的,先用 nc -vz <server-ip> 8443 测端口。不通多半是云安全组或 NAT 限制,可以用 SSH 隧道把本机 8443 转发过去,或者把 pipeline.ice_public_ip 改成服务器公网 IP。
适合谁
做数字人客服、虚拟前台、AI 视频助手产品原型的工程团队最能用上这套框架,它把音视频链路上最脏的活都封装好了,省下的集成工作量相当可观。手里有算力资源、想搞清楚 WebRTC 与实时多模态怎么拼的独立开发者,也值得花时间读一遍它的插件结构。
指望下个安装包点两下就能用的普通用户可以直接跳过,这个项目还没有到那个阶段。只有消费级显卡又一定要本地跑数字人画面的,按官方硬件表看多半得失望,更务实的做法是先跑纯语音模式,或者接云端数字人 API。打算拿它直接上线商业客服系统的团队需要留出排错时间——版本号还停在 v0.1.0,不少地方得自己趟。
对比同类选择:只需要把文案变成一段数字人口播视频,用现成的口播生成工具更快;要的是配音和语音克隆能力,Voice-Pro 这类本地部署方案部署成本低得多;做成片流程和角色一致性管理的,Jellyfish 这类短剧工作台方向更接近。CyberVerse 的不可替代之处只在”实时双向通话”这一个点上。
许可证与合规
项目采用 GNU General Public License v3.0,基于它做二次开发和商业化之前,GPL-3.0 的传染性条款以及 FlashHead、LiveAct 等第三方模型权重各自的许可协议都需要逐一核对,这两者并不同步。
另一重风险来自使用场景本身。一张照片就能生成会说话的形象,这项能力天然靠近肖像权、声音权和人格权的边界,用真人照片、已故亲属影像或者他人声音做角色,在国内已经有明确的法律约束。官方演示中的角色仅用于展示,不随项目提供,这个态度本身就是提示。
官网 / 下载
GitHub 仓库:github.com/Lynpoint/CyberVerse,源码、依赖清单、中英日韩四语 README 和完整部署文档都在这里。仓库 README 标注的项目主页为 www.cyberverse.cc,本文整理时该域名未能正常打开,以 GitHub 仓库为准即可。
站内相关:火山引擎数字人(云端数字人 API,可作为 CyberVerse 的云端 Avatar 方案之一)。
© 版权声明
文章版权归作者所有,未经允许请勿转载。