Jellyfish 是开发者 Forget-C 在 GitHub 上开源的 AI 短剧生产工作台,采用 Apache-2.0 协议。它不自己训练模型,而是把剧本拆解、分镜准备、角色与场景资产管理、图片和视频生成、任务追踪放进同一套系统,目标是解决 AI 短剧制作里最常见的两个问题:同一角色在不同镜头里长相不一致,以及剧本、垫图、视频生成分散在多个工具之间、只能靠人工来回搬运。
项目定位:短剧生产的调度层
眼下用 AI 做竖屏短剧,常见做法是在文本模型里写剧本,到出图工具里做角色参考图,再把图和提示词逐条贴进视频模型。角色一多,创作者往往要单独维护一张表格,记录每个角色的提示词和参考图链接,每生成一个镜头都要复制粘贴一遍。镜头之间人物“换脸”、服装变样的情况,也多半出在这个环节。
Jellyfish 的思路是把这些分散的信息收进数据库:角色、场景、道具、服装作为共享实体统一管理,分镜在生成前先绑定这些实体,生成任务统一排队、可追踪、可取消。官方 README 对它的定位是“端到端的 AI 短剧生产工作区”,并特意强调它不是一个单纯的出图或出视频工具。
核心功能
剧本理解与分镜拆解。以章节为单位导入剧本后,系统用大模型把剧本拆成镜头,同时抽取出场角色、场景、道具、服装和台词,还提供剧本优化、精简、一致性检查,以及针对角色画像、场景细节的专项分析。
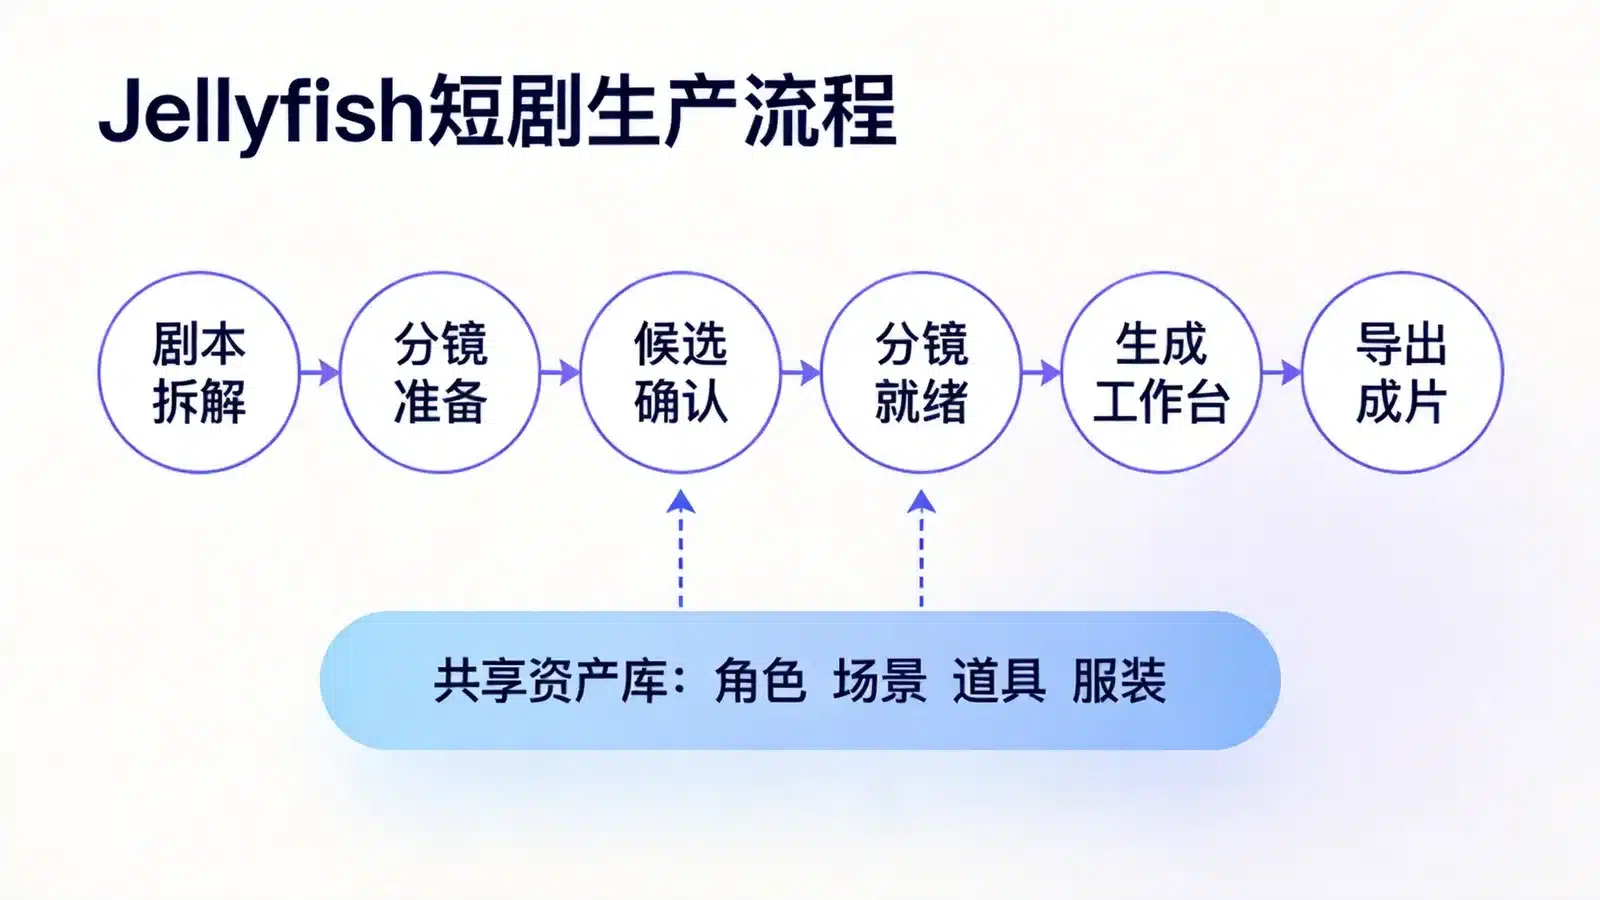
分镜准备与确认。这是整个项目设计最细的部分。官方给出的主流程是:剧本拆解 → 分镜准备 → 候选确认 → 分镜就绪 → 生成工作台。模型抽出来的资产和台词先作为“候选项”出现,由人工逐条接受、忽略,或关联到库里已有的角色和场景,确认完毕、状态变为“就绪”的镜头才进入生成阶段。系统把“已准备好”和“正在生成”区分成两种状态,避免未确认的镜头误触发付费调用。
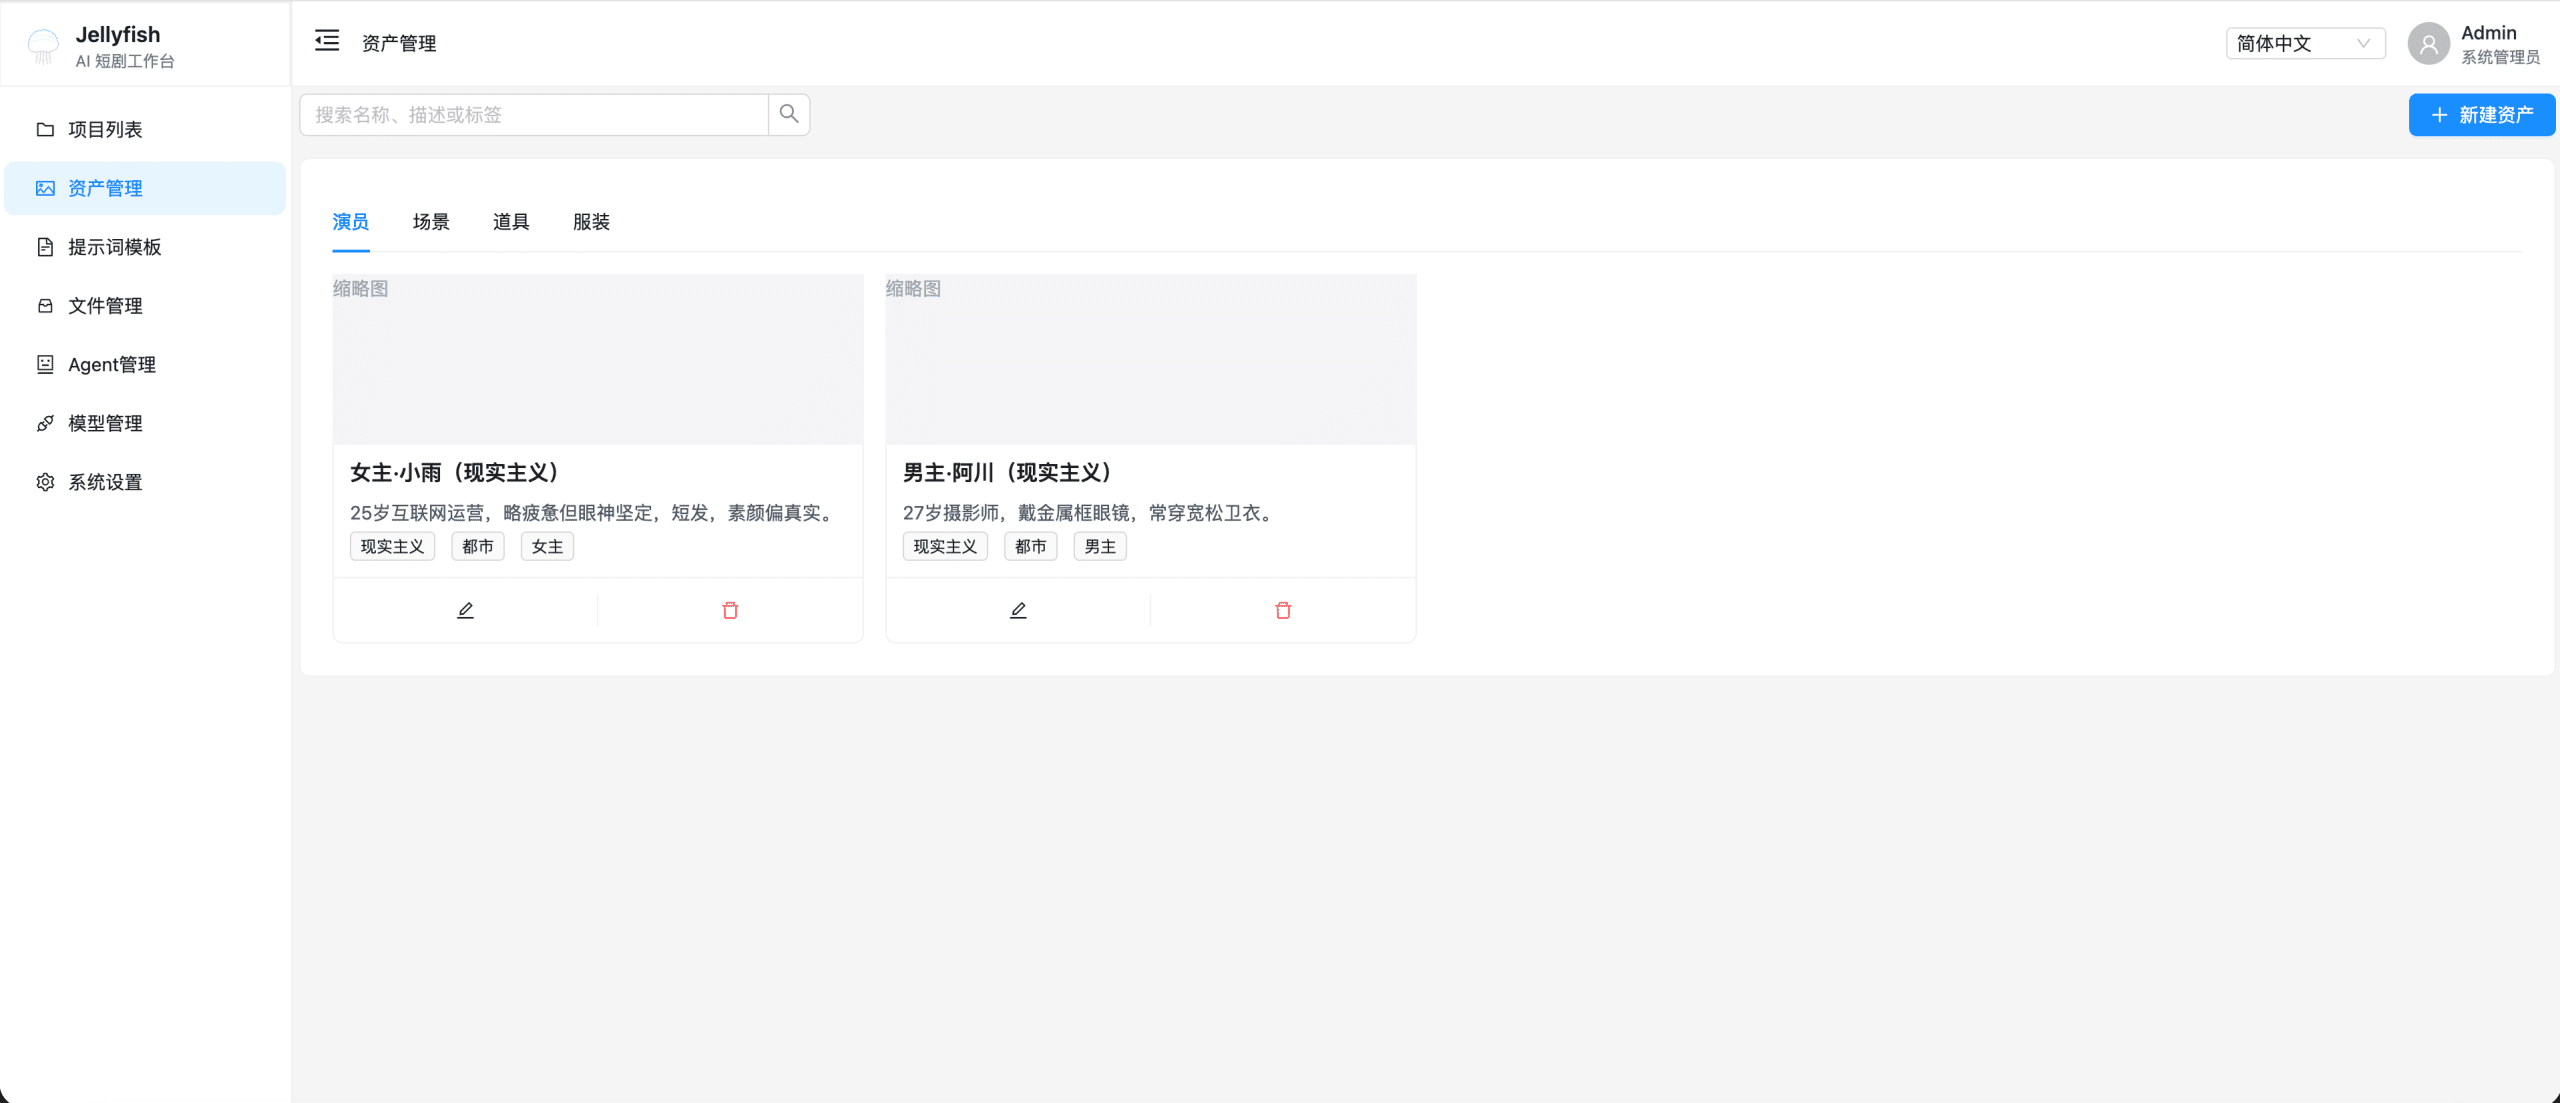
资产一致性。角色(含演员)、场景、道具、服装在所有镜头之间共享,每个实体可以挂自己的参考图;新建实体时系统会检查同名资产是否已存在,引导复用而不是重复创建。人物漂移最终能压到什么程度,取决于接入的图片和视频模型对参考图的遵循程度,Jellyfish 做的是保证每个镜头都拿到同一套参考素材。
镜头级生成工作台。镜头就绪后,可以管理关键帧和参考图、预览视频提示词、做单镜头或批量的生成前检查,再发起图片和视频生成任务,产出会写回对应镜头和媒体库。
统一任务中心。文本处理、图片生成、视频生成都走同一套异步任务系统,能看状态、进度、耗时和结果,支持取消,并能从任务直接跳回所属的项目、章节或镜头。视频生成动辄几分钟一条,这个设计对批量生产的意义大于单条创作。
配套模块还包括项目与章节管理、提示词模板管理、文件与生成媒体管理,以及多供应商、多模型的配置与按类别设定默认模型。
模型接入与国内可用性
Jellyfish 不提供算力,所有生成都要自备 API Key。根据仓库 provider_bootstrap.py 中的内置注册表,目前预置三家供应商:
- OpenAI:文本、图片、视频三类能力,默认地址
https://api.openai.com/v1 - 火山引擎:图片和视频,默认地址
https://ark.cn-beijing.volces.com/api/v3 - 阿里百炼:文本,默认地址
https://dashscope.aliyuncs.com/compatible-mode/v1
每个供应商可以分别配置文本、图片、视频三套 base_url,文档建议文本入口接 OpenAI 兼容网关,其他模型也可以按官方的供应商注册指南自行扩展。ahhhhfs 的介绍文称视频端覆盖 Kling、Runway、Luma 等服务,但这几家并不在当前的内置列表里,需要通过兼容网关或二次开发接入。
对国内用户而言,“火山引擎 + 阿里百炼”这一组合是最省事的配置:两家接口在大陆可以直接访问,火山方舟上的豆包系图片、视频模型与即梦AI同出字节,文本侧用百炼的通义千问即可,不需要额外的网络环境。OpenAI 接口在大陆无法直连,需要自备相应网络环境或中转服务。
部署与运行
ahhhhfs 在 3 月的介绍中提到项目当时没有一键部署包,这一点已经过时。仓库现在提供 Docker Compose 配置,并通过 GitHub Actions 构建镜像推送到 GHCR。复制环境变量模板后一条命令即可启动:
cp deploy/compose/.env.example deploy/compose/.env
docker compose --env-file deploy/compose/.env -f deploy/compose/docker-compose.yml up --build
启动后各服务端口如下:前端 http://localhost:7788;后端 http://localhost:8000,访问 /docs 可查看 Swagger 接口文档;MySQL 默认 3306,Redis 默认 6379,对象存储 RustFS 默认 9000,三者均可在 .env 中改端口。
想改代码的开发者可以分别启动前后端。后端基于 FastAPI,用 uv 管理依赖:
cd backend
cp .env.example .env
uv sync
uv run uvicorn app.main:app --reload --host 0.0.0.0 --port 8000
前端是 React + Vite:
cd front
pnpm install
pnpm dev
本地开发时最容易出问题的是前后端接口不同步。前端的请求函数和类型定义由后端 OpenAPI 规范自动生成,输出在 front/src/services/generated/,规范缓存在 front/openapi.json。前端大面积报接口错误时,先确认后端已在 http://127.0.0.1:8000 运行,再执行:
cd front
pnpm run openapi:update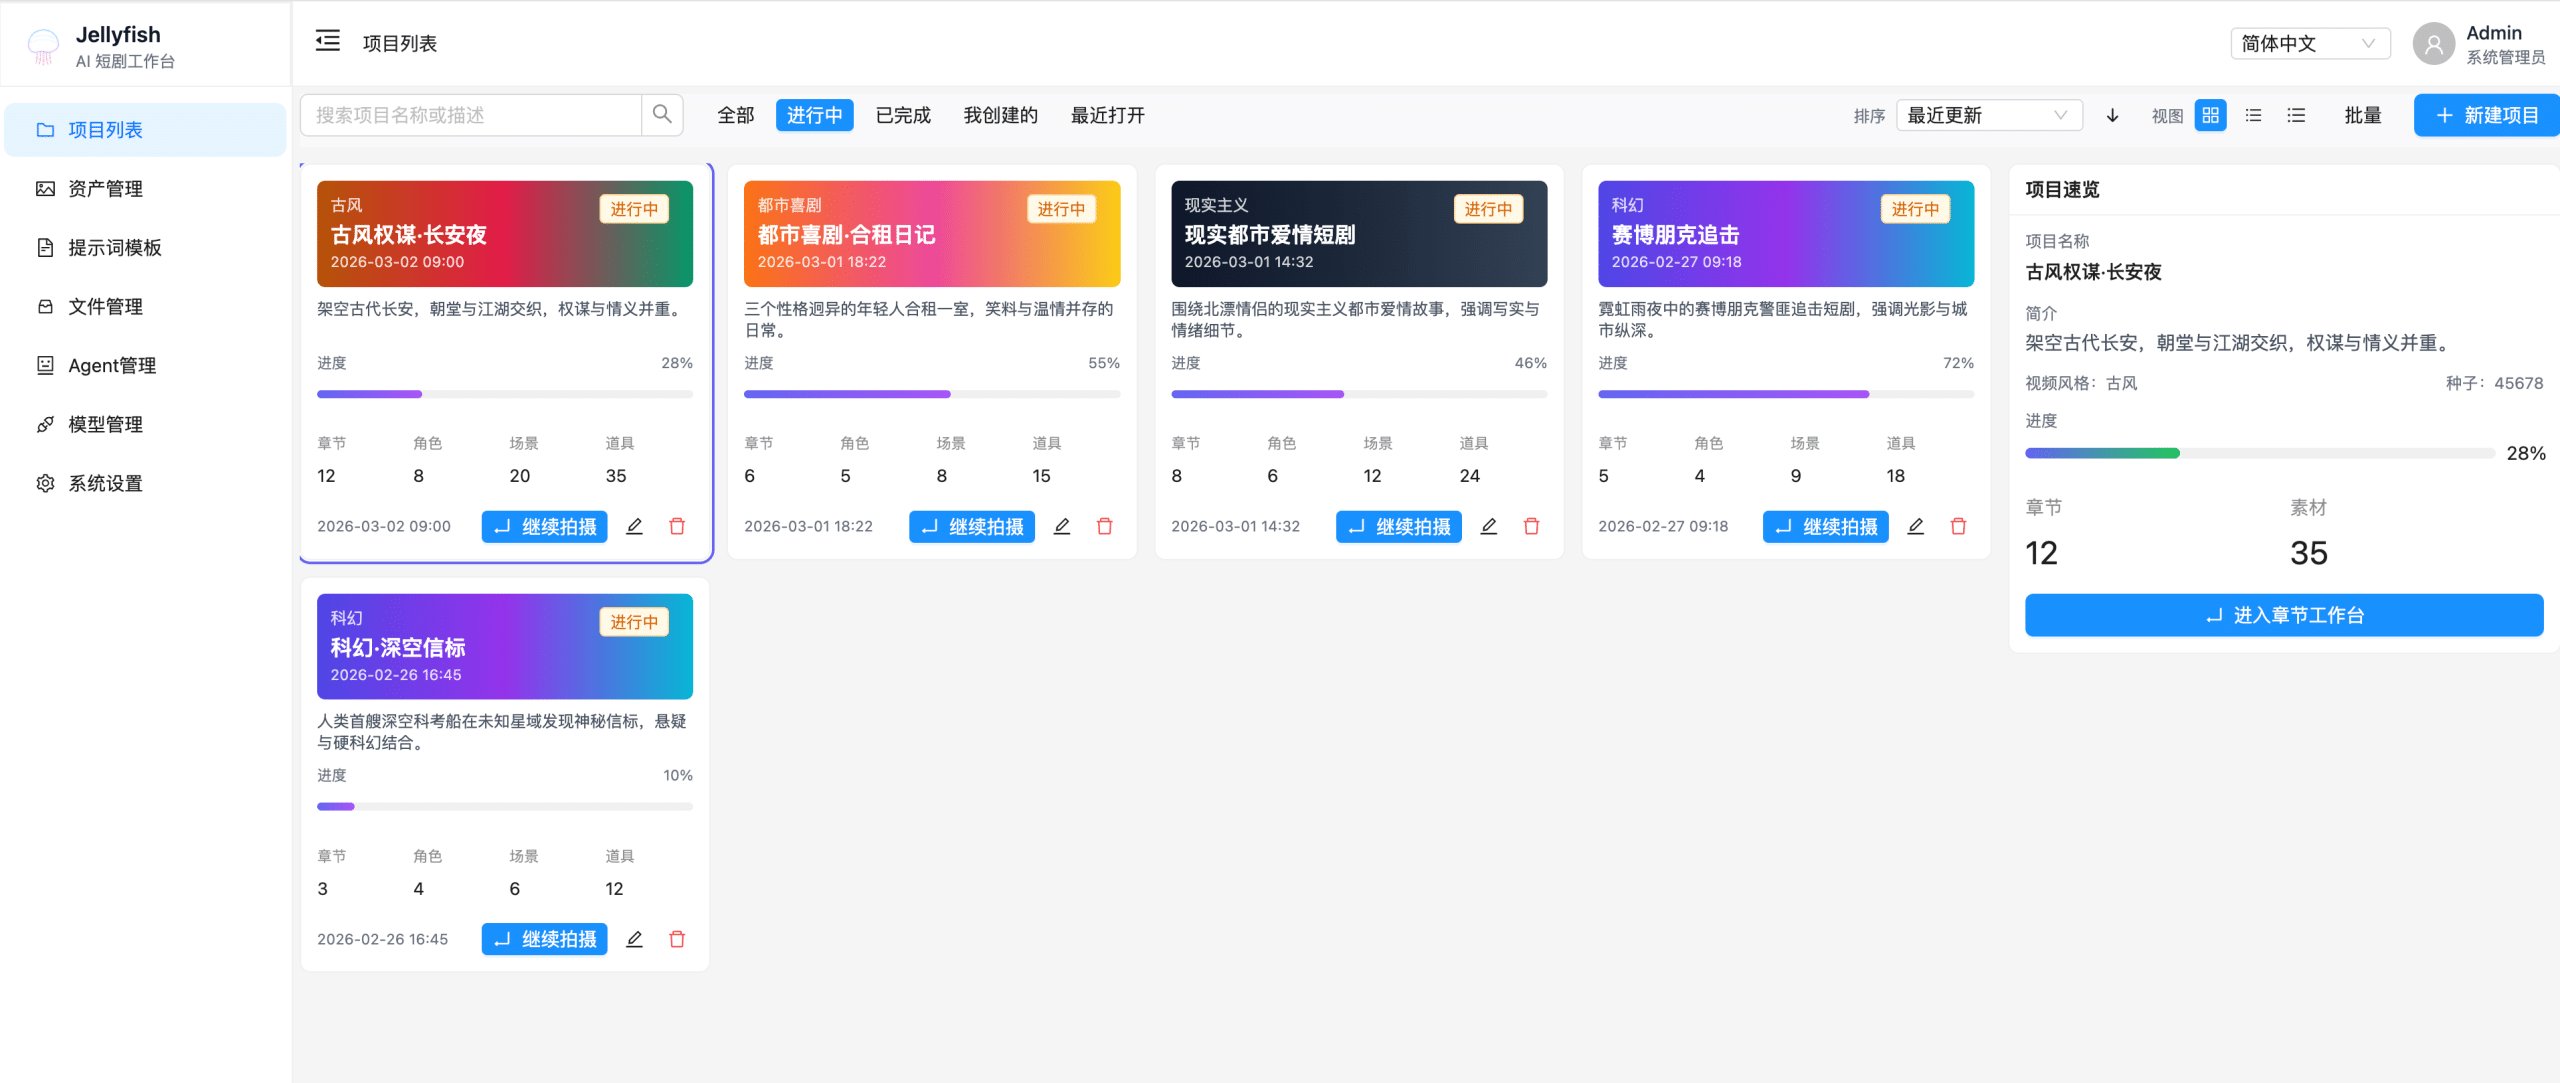
成熟度与适用人群
官方路线图的表述是:当前版本已具备项目管理、章节工作台、模型管理等核心交互与部分后端能力,后续重点是深化分镜编辑与生成流程、强化提示词模板与智能填充、完善图片和视频任务状态追踪、补强时间线和成片导出。这意味着时间线剪辑和成片导出仍是短板,生成出来的镜头目前还需要导到剪映等剪辑软件里完成拼接。
成本是另一层考量。高阶视频模型按秒或按条计费,靠人工反复试错时废片率很高;Jellyfish 把“候选确认”和“就绪检查”放在生成之前,作用是在付费调用前拦下不合格的镜头。ahhhhfs 的判断是,这类流程优化对批量内容生产团队的价值大于个人创作者,这一点与项目的架构取向相符。
从定位看,Jellyfish 更适合有一定开发能力、准备自建 AI 短剧生产线的小团队,作为参考架构或二次开发底座;只想快速出几条片子的个人创作者,直接使用即梦、可灵AI这类成品平台效率更高。站内介绍过的同类开源项目中,Toonflow 侧重小说到短剧的自动化生成,deep-printfilm 面向漫剧的剧本、角色与关键帧流水线,三者的取舍在于自动化程度与人工把控粒度,Jellyfish 属于人工确认环节最多的一个。
官网 / 下载
- GitHub 仓库:https://github.com/Forget-C/Jellyfish
- 项目文档站:https://forget-c.github.io/Jellyfish
- 问题反馈:GitHub Issues
© 版权声明
文章版权归作者所有,未经允许请勿转载。