Mistral 是一家总部在法国巴黎的 AI 公司,它把自家大部分模型的权重公开放到网上,任何人都可以下载下来,装在自己的电脑或服务器上运行。这批权重公开的型号合称 Mistral 开源系列,规模跨度很大:最小的 Ministral 3 3B 下载下来只占 3GB 磁盘,一台带独立显卡的家用机就能跑;最大的 Mistral Large 3 总参数 675B,需要服务器级的多卡环境。能力上和常见的聊天助手接近——对话、写代码、读长文档、识别图片,现役型号全部支持图文输入。对个人用户来说,把权重下到本地运行意味着不用付 API 费用,对话内容也不会离开自己的机器;对企业来说,主力型号采用 Apache 2.0 许可,可以直接商用,不必另外谈授权。
现役开放权重型号
按 Mistral 官方文档 2026 年 9 月在列的清单,权重公开的通用型号分三条线。
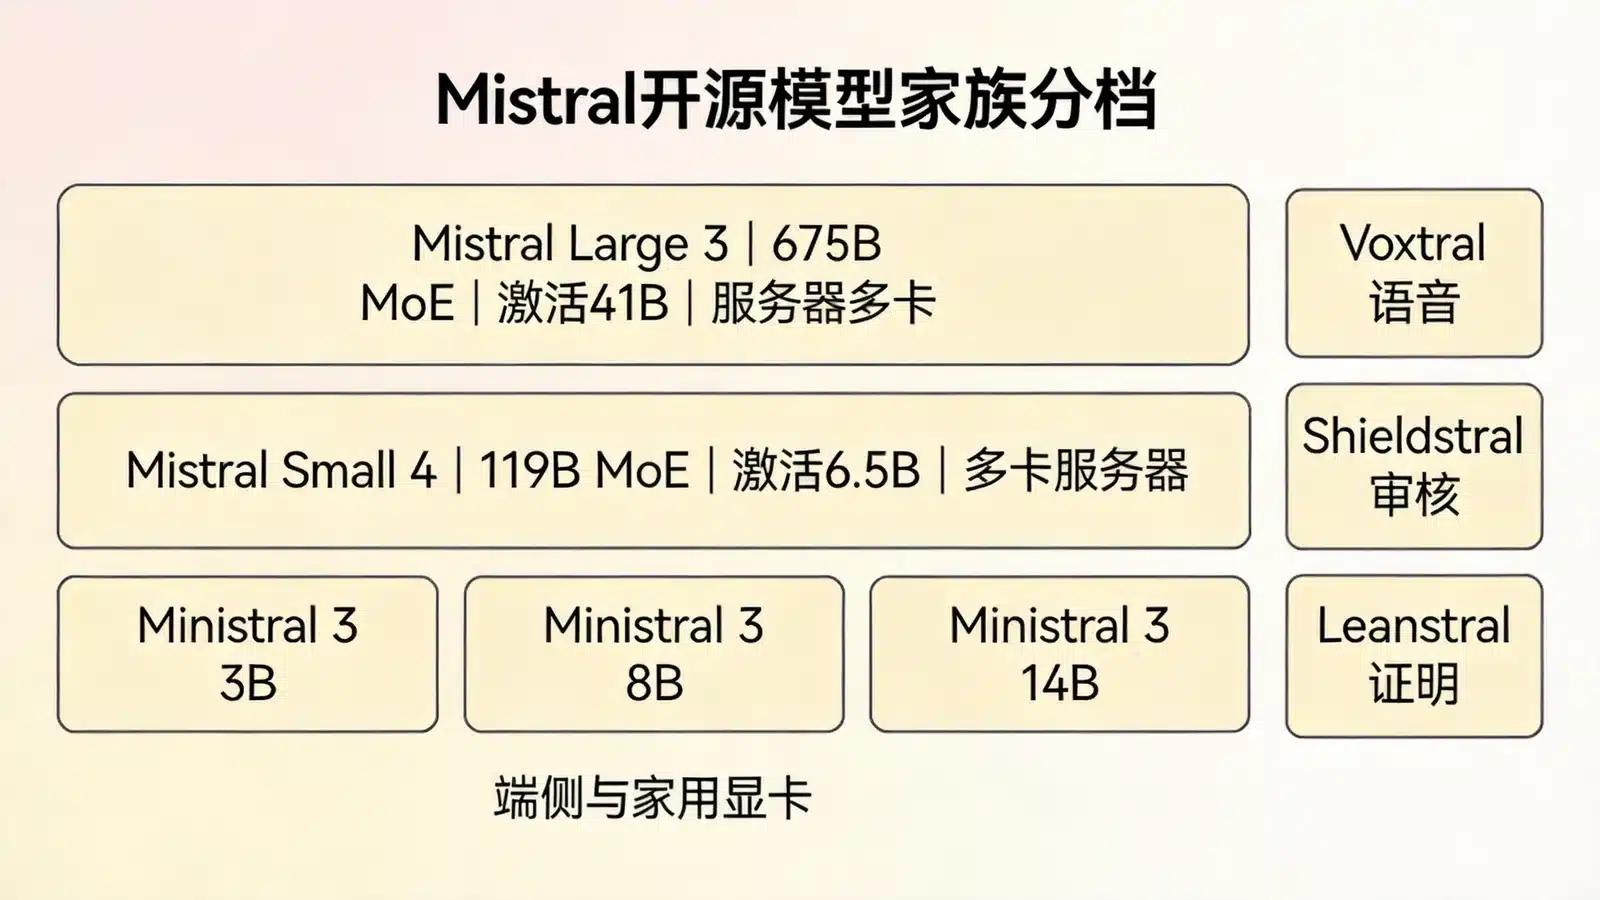
Mistral Large 3(版本 25.12,Apache 2.0)是这个家族的旗舰,采用细粒度混合专家架构,总参数 675B、每个 token 激活 41B,其中语言模型部分 673B(激活 39B),另有一个 2.5B 的视觉编码器负责图像输入。上下文窗口 256K,官方模型卡说明它由 3000 张 H200 从零训练。部署上,FP8 精度可以放进单节点 B200 或 H200,官方另提供 NVFP4 量化版本,可落到单节点 H100 或 A100。
Mistral Small 4(版本 26.03,Apache 2.0)是今年 3 月发布的中档型号,同样是混合专家结构,128 个专家每次激活 4 个,总参数 119B、每 token 激活 6.5B,上下文 256K,支持图文输入。它最大的变化是把 Mistral 此前三条独立产品线——指令对话的 Instruct、推理的 Magistral、编程的 Devstral——合并进了同一个模型,推理强度可以按请求逐次配置,需要深度思考就打开推理模式,日常问答走快速回复模式。官方模型卡给出的效率数据是:延迟优化部署下端到端完成时间比 Mistral Small 3 缩短 40%,吞吐优化部署下每秒处理请求量达到上一代的三倍。
Ministral 3(版本 25.12,Apache 2.0)是面向端侧和边缘设备的一条线,提供 3B、8B、14B 三个尺寸,都是稠密模型,都带视觉能力,上下文同样是 256K。官方模型卡直接标注了 FP8 精度下的显存需求:3B 约 8GB,8B 约 12GB,14B 约 24GB,进一步量化还能再降。官方对 14B 的定位描述是性能可以对标上一代体量更大的 Mistral Small 3.2 24B。
通用型号之外还有几个专项模型权重公开:语音输入模型 Voxtral Small(25.07)和实时转写模型 Voxtral Mini Transcribe Realtime(26.02)都是 Apache 2.0;内容审核模型 Shieldstral 1.0 是 3B 的多模态分类器;Leanstral 1.5 是面向 Lean 4 形式化证明的代码智能体模型。语音合成模型 Voxtral TTS 的许可是 CC BY-NC 4.0,只能用于非商业场景。
另有一个介于开源与商用之间的型号:Mistral Medium 3.5(版本 26.04)的权重同样公开,但许可是修改版 MIT,不是 Apache 2.0。官方把它定位成面向智能体和编程任务的前沿级多模态模型,也是官方文档在「该用哪个模型」问答里推荐的通用首选。
命名容易误导:Small 不等于小
选型时最容易踩空的地方在名字。Mistral Small 4 的「Small」指的是产品档位而非模型体量,119B 的混合专家结构对显存的要求按总参数算,不按激活参数算,家用显卡装不下。按硬件规模划分档位的是 Ministral 系列,词根多了一个 mini。这两个名字在中文语境里都容易被读成「小模型」,实际部署门槛差着两个数量级。
另一处需要更新认知的是产品线归并。Magistral 和 Devstral 曾经是 Mistral 各自独立的推理系列和编程系列,现在两条线都已并入 Small 4 与 Medium 3.5,官方文档的退役表里,Magistral Small 1.2、Magistral Medium 1.2、Devstral 2 和 Devstral Small 2 的退役日期都落在 2026 年内,替代型号分别指向 Mistral Small 4 和 Mistral Medium 3.5。网上 2025 年写的 Mistral 部署教程多半还在教装 Magistral,照着做会装到一个已经停止维护的分支。
按硬件条件选型
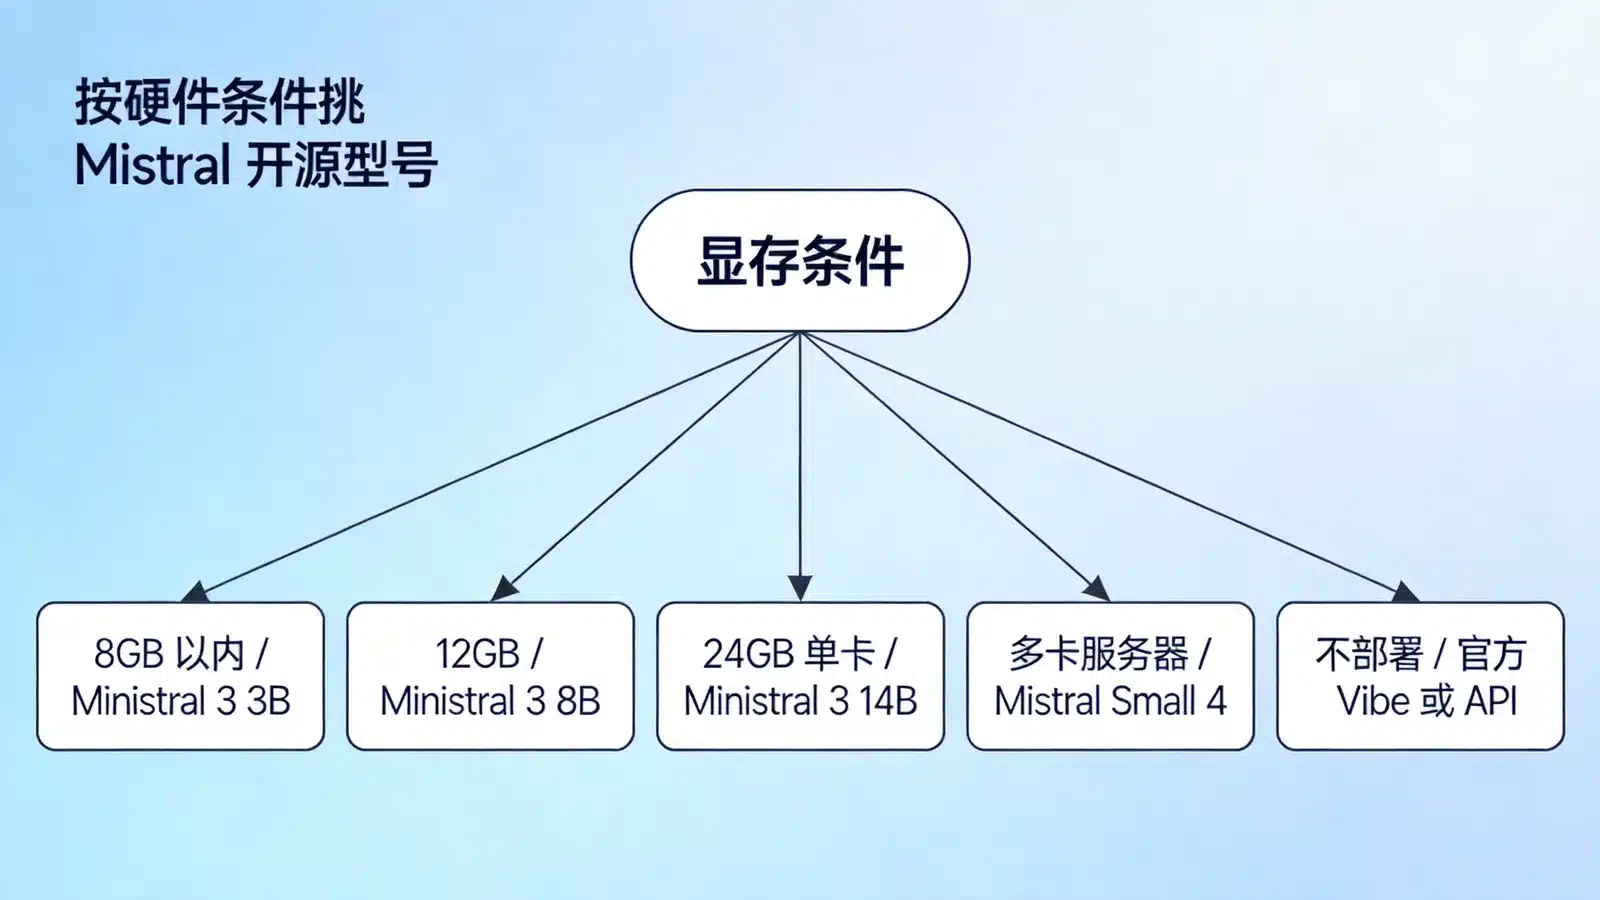
个人用户的可选范围实际只有 Ministral 3 这三档。16GB 显存以内的主流游戏显卡,8B 是稳妥选择,占 6GB 左右,日常对话、翻译、截图识别都够用。24GB 显存(RTX 4090、3090 一类)可以直接上 14B,这是家用硬件能跑到的上限,也是这个家族里性价比最高的一档。笔记本核显或者 8GB 显存的旧卡选 3B,能力会明显缩水,适合做固定格式的文本处理和嵌入式场景,不适合当通用助手。
企业有多卡服务器时,Small 4 值得优先考虑:一个模型同时覆盖对话、推理、编程三类任务,省掉多模型并行部署的运维成本,256K 上下文也够处理整本手册级别的文档。Large 3 的场景更窄,主要是需要顶配质量的长文档理解、检索增强系统和复杂企业流程,硬件账要单独算。
本地部署的两条路
Ollama 是门槛最低的方式,Ministral 3 全系三档都已收录,带视觉输入和工具调用:
ollama run ministral-3:3b     # 3.0GB
ollama run ministral-3:8b     # 6.0GB
ollama run ministral-3:14b    # 9.1GB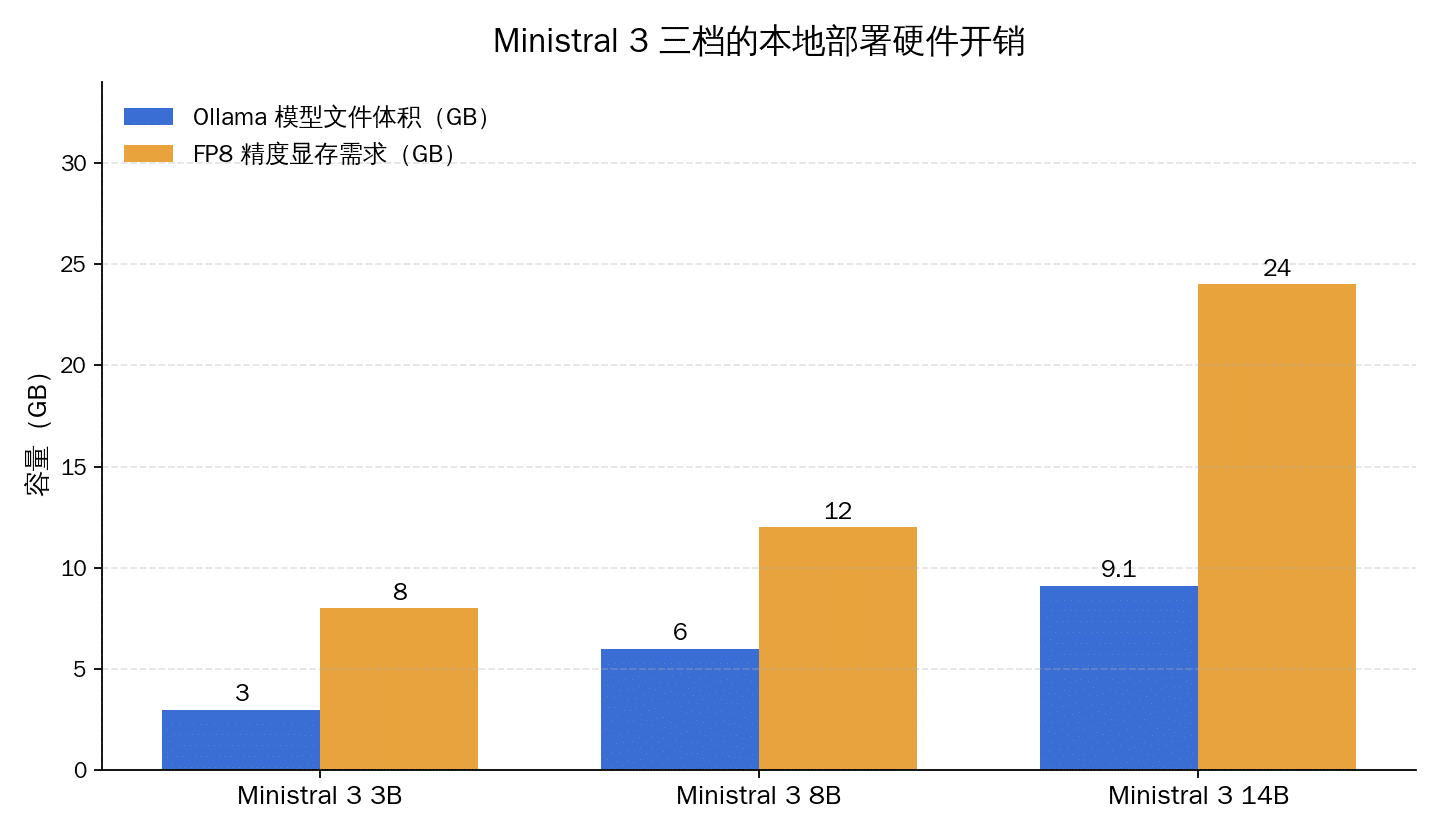
括号里是 Ollama 官方标注的模型文件体积,三档的上下文窗口都是 256K。这个条目在 Ollama 上的累计下载量已经超过 150 万次。
Ollama 这条路到 Ministral 3 为止。截至写稿时,Ollama 官方库里没有 mistral-small-4 条目,旧的 mistral-small 条目还停留在一年前的 Mistral Small 3 24B 版本,上下文只有 32K 且不支持图像输入;mistral-large-3 条目存在,但只提供 675b-cloud 一个标签,走的是 Ollama 的云端推理而非本地权重。想在本地跑 Small 4 或 Large 3,需要绕开 Ollama,用 vLLM 直接加载官方权重:
vllm serve mistralai/Ministral-3-14B-Instruct-2512
vllm serve mistralai/Mistral-Small-4-119B-2603
vLLM 启动后提供 OpenAI 兼容接口,已有的客户端代码改个 base_url 就能接上。Small 4 官方还额外提供了两个优化版本:NVFP4 四比特量化检查点 Mistral-Small-4-119B-2603-NVFP4,以及配套的推测解码草稿模型 Mistral-Small-4-119B-2603-eagle,显存紧张或者追求吞吐时可以换用。
不想部署时的两个入口
Mistral 的网页端和移动端产品现在叫 Vibe,前身是 Le Chat。免费档可以使用最新模型的对话、搜索和创作功能,并附带每月 10 美元的 API 额度;Pro 档每月 14.99 美元(按当前汇率约合 106 元人民币),放开长任务和编程智能体的用量上限。官方对经过认证的在校学生给出 5.99 美元的月费(约合 42 元人民币)。
走 API 的话,官方定价问答里给出的示例是 Mistral Large 每百万输入 token 0.5 美元、输出 1.5 美元,按当前汇率约合 3.6 元和 10.7 元。两个降价开关值得记住:批处理模式整体打五折,命中缓存的输入 token 最高可省九成,长系统提示词反复调用的场景差价相当可观。OCR 按千页计费,语音模型按分钟计费,工具类接口按调用次数计费,都不套用 token 口径。
许可证要逐个确认
Apache 2.0 覆盖了 Large 3、Small 4、Ministral 3 全系、Voxtral Small、Voxtral Mini Transcribe Realtime、Shieldstral 和 Leanstral,这些型号可以自由商用、修改和再分发,不收授权费。Medium 3.5 走的是修改版 MIT,条款与 Apache 2.0 不完全等价;Voxtral TTS 的 CC BY-NC 4.0 明确排除商业用途,做语音克隆产品的团队需要另找方案或联系官方谈授权。商用前按 Hugging Face 权重仓库页面标注的许可证逐个核对是必要步骤,不能因为「Mistral 是开源的」就整体套用。
国内下载与访问
权重不必绕道 Hugging Face。魔搭 ModelScope 上有 mistralai 组织的官方仓库,Ministral-3-14B-Instruct-2512、Mistral-Small-4-119B-2603、Mistral-Large-3-675B-Instruct-2512 的页面都能直接打开并下载。权重落地之后模型完全在本地运行,不依赖任何境外服务,对内网环境和数据不外传的场景比较合适。官方 API 与 Vibe 订阅按美元、欧元计价,面向国际用户结算,国内团队更常见的用法还是下载权重自部署。
在开源阵营里的位置
和国内的开源模型家族横向对比,Mistral 的差异化主要在两点:一是端侧档位划分更细,3B、8B、14B 三档都带视觉能力且统一 256K 上下文,同价位硬件上的选择余地比多数竞品宽;二是欧洲数据合规背景,跨境业务团队做私有化部署时会把这一点算进选型理由。
中文任务密度高的场景则是另一回事。Qwen3 系列在中文语料上的训练投入更集中,同参数量下的中文表现通常更稳;需要更极端性价比的推理型号,Kimi K2 的万亿参数 MoE 路线又是另一种取舍。单卡小模型这一档,Gemma 3 与 Ministral 3 部署门槛接近,可以放在一起实测比较;Llama 4 则在生态工具链的成熟度上仍有优势。
完整的型号参数、许可条款与价格对照表,可参见站内模型页 Mistral 开源系列;官方网页端产品的介绍在 Mistral Le Chat 条目。
© 版权声明
文章版权归作者所有,未经允许请勿转载。